看不见的锁:机密计算如何重构数据信任边界
被流通需求倒逼出来的新方案
过去我们讲数据安全,核心思路是“围起来”:存的时候加密,传的时候加密,只有在我自己的安全域里才解开用。但凡要出域,就得把数据整份交出去,等于把控制权也交出去了。
规则层面有了数据安全法、个人信息保护法之后,谁敢随便交?违规的成本动辄几千万上亿,没人赌得起。但不流通,数据的价值又出不来,躺着的就是一堆没用的数字。需求卡在这儿,自然就长出了新的解法。
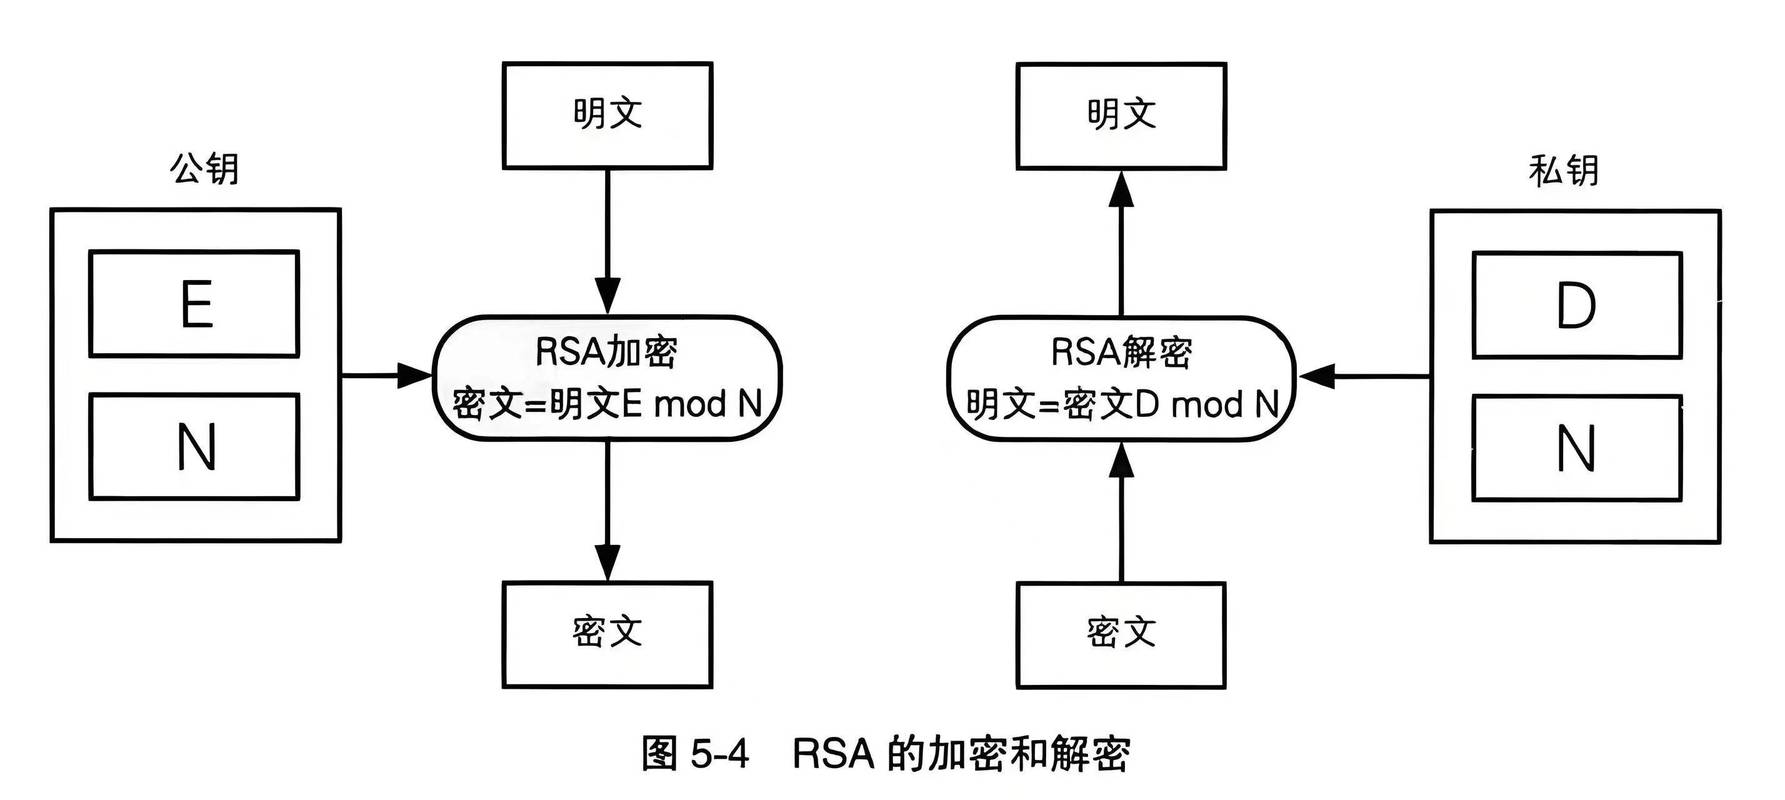 传统端到端加密数据明文处理过程图
这个思路的核心,不是把数据围在自己的域里不让出去,而是把计算过程锁在一个没人能偷看的小黑屋里。你把算法放进去,我把数据放进去,锁上门算,算完只把结果给你,原始数据和中间过程没人能看到。哪怕帮我们托管服务器的云厂商,也碰不到小黑屋里的任何东西。
说实话,这个思路刚出来的时候,很多人觉得多此一举。不就是加密吗?干嘛非要把计算也锁起来?那是因为很多人没碰到那个场景:当你必须把计算放在不可信的环境里运行,还要保证数据不泄露,你就会知道这个锁有多重要。
它到底把秘密藏在了哪里
核心的技术底座,是可信执行环境,也就是很多人常说的飞地。它和普通的虚拟机、容器隔离不是一回事。普通隔离是逻辑层面的,操作系统有权限访问任何容器的内存空间,要是系统本身被攻破了,所有容器里的数据也就暴露了。
飞地不一样,它的隔离是硬件层面做的。CPU给飞地开辟了一块专属的加密内存区域,任何飞地之外的程序,哪怕是最高权限的内核、Hypervisor,都没办法读取或者修改这块区域里的内容。只有飞地内部的程序能访问,验证通过之后,才会把结果输出到外部。整个计算过程,数据对外部完全不可见。
当然,这不是说它就万无一失。行业里很早就发现了侧信道攻击的风险:攻击者虽然看不到飞地里面的数据,但可以通过监测飞地运行时的功耗、运行时间、缓存占用这些物理特征,反向推导出来里面的计算内容和密钥。前几年已经有多个研究团队,在主流的商用产品上实现了这类攻击,能提取出完整的RSA密钥。
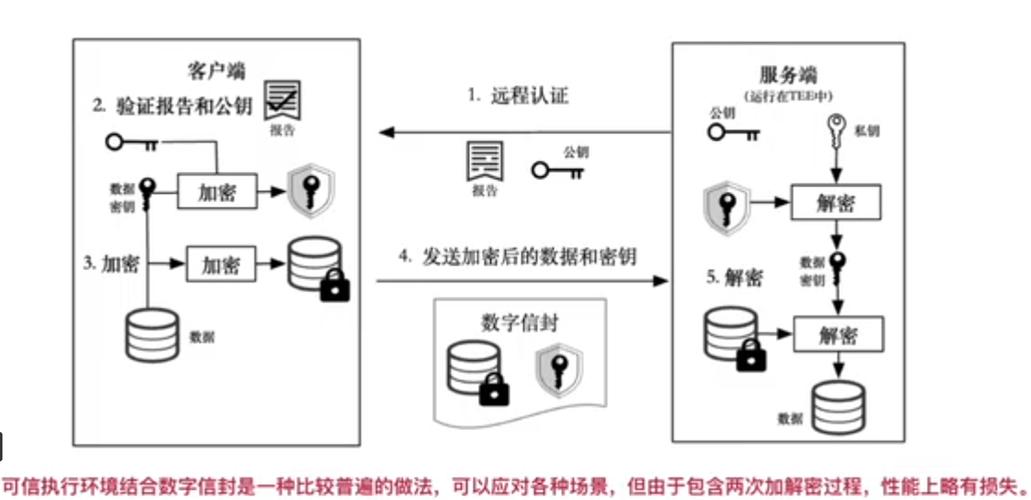 机密计算可信执行环境飞地隔离架构图
这几年硬件厂商已经在芯片层面做了很多防御,侧信道攻击的门槛已经被提得非常高,普通攻击者根本没条件实现。但它也给所有从业者提了醒:技术本身还有缺陷,不是说用了就绝对安全。
哪些坑,现在还绕不开
 哪些坑,现在还绕不开
市面上不少PPT把它吹成了隐私保护的万能钥匙,交智商税的项目不在少数。捋清楚它的应用边界,比盲目跟风重要得多。
第一个绕不开的坑就是性能损耗。哪怕现在技术进步了,飞地的内存大小有限,加密计算本身也会带来额外开销,对性能敏感的高并发场景,损耗还是很难接受。要适配飞地,很多原有应用的代码都要改,改的成本远高于大多数企业的预期。
第二个坑就是兼容性碎片化。不同芯片厂商、不同云厂商的飞地接口、标准都不统一,你今天在A云做了适配,明天想迁到B云,几乎等于重写一遍代码。对于想做跨云部署的企业来说,这就是个无解的麻烦。
第三个更深层的问题是责任边界不清。飞地里面的计算过程,所有人都看不到,要是出了数据安全事故,到底是谁的责任?是数据提供方?还是算法方?还是提供飞地的云厂商?现在全球都没有明确的法律法规界定这个事,真出了问题,就是扯不完的皮。
不过话说回来,这些问题都是技术发展过程中的正常问题,不是无解的。现在行业里已经在推统一的开源标准,硬件也在不断扩大飞地的内存容量、降低计算损耗,很多问题再过两三年估计就不是问题了。
真正值得提醒的是,别什么场景都往里面塞。你自己企业内部存个用户数据,自己用,根本不需要。只有那些多方协同处理敏感数据的场景,才是它真正能发挥价值的地方:跨境数据合规计算、金融联合风控、医疗数据联合研发、广告投放的数据对齐,这些地方才是真需求,别的地方,更多就是炒作。
未来它会往哪里走?现在已经能看到苗头,从云端往端上走,未来每一部手机、每一个智能设备,都会有属于用户自己的飞地,你的隐私数据不用上传到云端,直接在本地飞地里计算,厂商拿不到你的原始数据,还能给你提供个性化服务。这个方向走通了,整个数据行业的信任逻辑都会变。
它不是什么改变世界的魔法,就是一把给数据上锁的工具——刚好解决了之前解决不了的那个矛盾,让数据能流通,也能保得住秘密。