藏起秘密也能证明你行:零知识证明的虚实边界
它到底解决了什么真问题
很多人对它的印象停留在加密圈的炒作概念。也有人说它是下一代隐私基础设施。吵来吵去,大部分人没说清它到底能做什么,不能做什么。
我们每天都在遇到这样的困境:你要向平台证明你是你,就得交出身份证号、人脸、住址所有敏感信息,最后这些信息说不定就被卖掉。金融机构要核实你的征信情况,必须拿到你所有的历史交易记录,你完全没有隐私可言。
本质上,传统的验证逻辑是:想要证明一件事是真的,你就得公开相关的所有信息。这就把数据的所有权和验证权绑死了——你要让别人验证,就必须交出所有权。
它要做的,就是把这两个权利拆开。我不需要告诉你我的秘密是什么,我只需要让你相信,「我拥有这个秘密」或者「我做的计算是对的」这件事本身是真的。
最经典的例子就是阿里巴巴山洞问题:证明者知道打开密门的咒语,怎么在不说出咒语的情况下,让验证者相信他知道?验证者只需要让证明者走进山洞,随机选择从左边或者右边出来,证明者只要每次都能按要求走对,就能证明他知道咒语,完全不需要说出咒语内容。
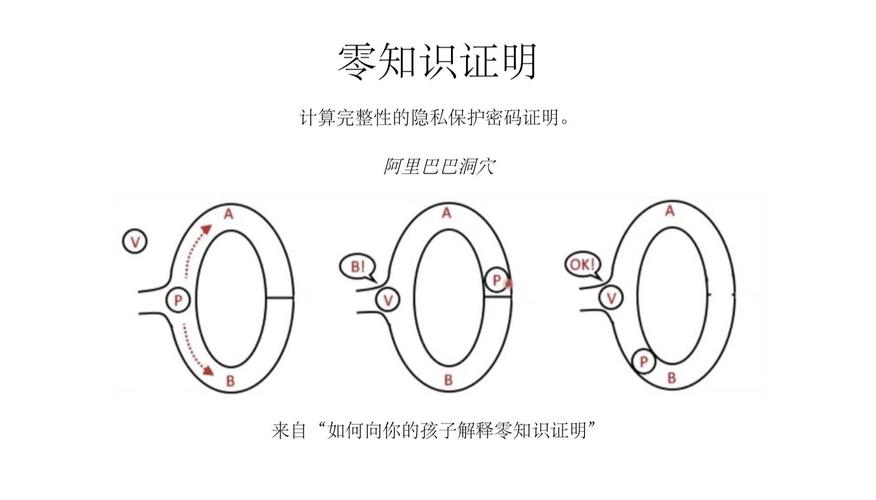 零知识证明阿里巴巴山洞逻辑示意图
不是魔法,是带约束的数学工具
它不是什么黑科技玄学,是有严格定义和约束的密码学协议。满足三个基本性质,才能称得上合格。
完备性:只要证明者说的是真话,验证者最后一定会被说服,不会有冤案。可靠性:只要证明者说的是假话,不管怎么骗,都没法骗过验证者,不会有假案。零知识性:验证者整个过程下来,除了知道证明者说的是真话,得不到任何额外的信息,证明者的秘密还是自己的。
现在落地的实现路径,主流分几个方向,各有各的适用场景,也各有各的限制。
用的最多的Groth16,证明体积小,验证速度快,优点很突出。但它有个绕不开的问题:需要可信初始设置。什么意思?就是协议启动的时候,需要一群人一起生成一套公共参数,生成过程中会产生一个“有毒垃圾”,只要这个有毒垃圾没被销毁,任何人都可以用它伪造假证明,整个体系直接崩溃。之前不少项目就栽在这个点上,初始设置的参与者没做好销毁,留下了隐患。
后来出来的zk-STARK解决了可信设置的问题,不需要第三方参与初始设置,不存在有毒垃圾的风险。但它的证明体积比Groth16大一个数量级,验证时间也更长,成本更高,对存储和带宽要求高,很难用到对性能要求高的场景。
还有像Plonk、Marlin这些方案,就是折中的思路,用通用的可信设置,一次设置可以给所有电路用,不需要每个项目都重新做,一定程度上降低了可信设置的风险,性能也介于两者之间。
 零知识证明不同实现方案参数对比表
落地的坑,远没到铺满路的时候
 落地的坑,远没到铺满路的时候
现在行业里吹的应用场景一大堆,从隐私身份到数据共享,从供应链溯源到AI训练,什么都能蹭。但真正跑通大规模落地的,屈指可数。
最大的坑就是性能。生成一个证明的成本,远高于普通的签名验证。处理简单的计算还好,要是涉及复杂的业务逻辑,比如整个电商订单流程的验证,生成证明就要花好几秒,甚至好几分钟。你能想象你在APP上付款,等三分钟才能出结果吗?根本没法用在高频的民用场景。
零知识不是绝对零知识。大部分实用的方案都是统计零知识,不是完美零知识,信息泄露的概率非常小,但不等于零。对普通的互联网场景可能无所谓,但对金融、政务这类要求绝对安全的场景,这个极小的概率,也是不能接受的风险。
说实话,现在很多创业者连三个基本性质都没搞明白,就拿着概念拉投资,吹风口,挺没劲的。不过话说回来,也不能一棒子打死,确实有一些场景已经跑通了小范围落地。
比如加密资产的隐私交易,用户不需要公开自己的交易地址和金额,就能证明交易合法有效,保护了用户的财产隐私。再比如个人征信场景,用户要向银行申请贷款,只需要证明自己“连续五年没有逾期”“月收入超过贷款要求”,不需要把自己所有的消费记录、收入明细都交给银行,既满足了银行的风控要求,也保护了用户的个人隐私。
现在行业的研发方向,主要都是冲着性能去的。递归证明技术可以把大的证明拆成多个小证明,逐次递归压缩,最后得到一个很小的证明,降低验证成本。还有专门的硬件加速方案,用FPGA或者专用ASIC芯片加速证明生成过程,能把生成速度提高好几倍。
当然,绕不开的还有监管风险。它能隐藏交易和身份信息,天生就有被非法利用的可能。未来真正大规模落地,肯定要在隐私和监管之间找到平衡,技术上预留可控的后门,只对第三方匿名,对监管合规透明,这才是能走通的方向。
它是解决特定隐私问题的好工具,但不是包治百病的神药。放下炒作的滤镜,能做什么,不能做什么,其实边界很清楚。