在冯诺依曼之外:类脑芯片研发的破局与困局
冯·诺依曼墙,不是玄学。是现在每个做芯片的人都摸得到的天花板。
摩尔定律放缓之后,算力增长的速度赶不上大模型参数膨胀的速度,每年光是训练顶级大模型消耗的电力,已经到了普通人不敢想的量级。人们开始往别的方向找出路。
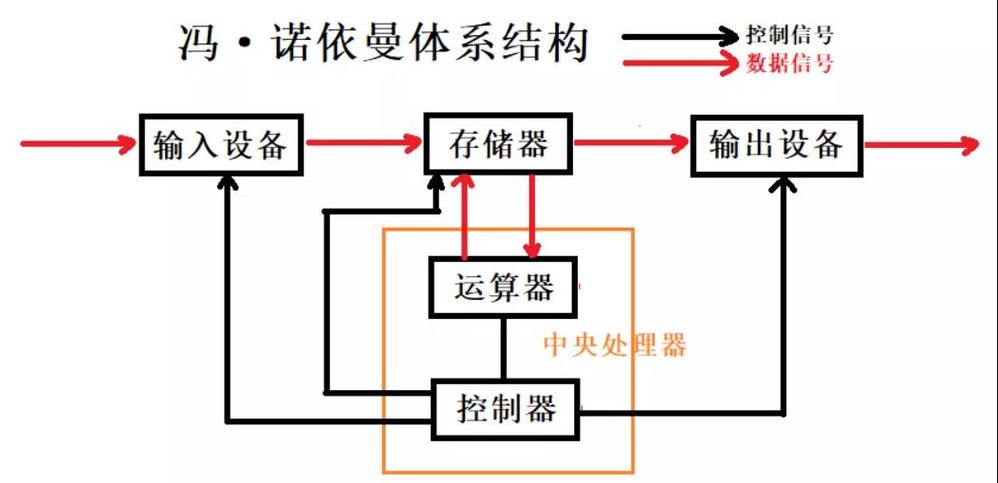 冯诺依曼架构与类脑架构功耗对比示意图
现在已经发布的不少产品,都喜欢拿神经元数量做宣传,很少有人提突触塑性的实现效率。说白了,很多所谓的类脑芯片,只是用传统数字电路模拟了神经元的连接,并没有真的实现神经突触能随着信号传递改变权重的生物特性。
我见过一个实验室的内部测试,同样做1000类图像识别,某号称亿级神经元的产品,功耗确实比GPU低不少,但延迟是GPU的三倍,准确率还低两个百分点。也就适合用在对延迟不敏感的低算力场景,远没到宣传里那样能颠覆现有格局。
真正难啃的骨头,是在线学习的突触更新。现在大部分产品只能做离线推理,训练好的权重烧进去就不能改,真要让芯片在使用过程中自己更新突触权重,工艺和设计上的问题一大堆,温度漂移、噪声干扰就能把精度冲没了。
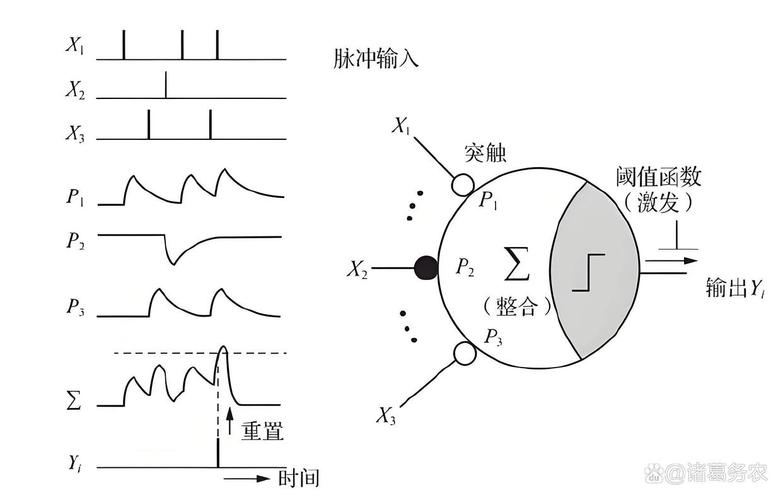 类脑芯片脉冲时间编码原理示意图
举个实际的例子,把用时间编码的类脑芯片装在户外的物联网传感节点上,环境温度变化五摄氏度,传感器输出的噪声稍微涨一点,识别准确率就能掉15个百分点,根本没法商用。
现在也有不少团队在做混合编码方式,把两种编码的优势结合,或者把Transformer的注意力机制适配到脉冲网络上,但大多还停留在仿真阶段,流片出来的少,能稳定跑真实任务的更少。
不过话说回来,就算编码问题解决了,还有架构适配的问题。现在反向传播是深度学习的基础,但脉冲信号是离散的,没法直接做反向传播,大部分方案都是用近似梯度,精度本来就有损失,想要训练大参数的模型,效果还不如传统GPU。
 别吹颠覆,先找对自己的应用位置
现在资本热,什么概念火就往里面砸钱,一堆人喊着要替代GPU,要做通用计算。我只能说,太急了。
类脑芯片的核心优势,从来不是峰值高算力,是低功耗下的单位算力效率。它本来就不该去跟GPU抢数据中心训练大模型的生意,那个地方,人家拼了几十年的生态和工艺优化,根本抢不动。
它真正的机会,在边缘端。在那些电池容量只有几百毫安,又需要做实时AI推理的场景。比如植入式脑机接口,要处理实时脑电信号,又不能让芯片发热烧伤脑组织,对功耗的要求苛刻到极致,这个地方,现有的GPU和低功耗MCU都满足不了,类脑就是最合适的选择。再比如工业物联网里成千上万个传感节点,每个节点都要做本地预处理,不能把所有原始数据都传到云端,低功耗的类脑芯片就比传统芯片合适太多。
现在最大的风险,就是大家都盯着“通用”“颠覆”这些概念炒,没人愿意沉下心解决特定场景的具体问题。很多项目发了顶会论文,拿了融资,流了片,就没有下文了,根本落不了地。
未来十年,类脑都不会取代现有的计算架构。它会作为现有架构的补充,先在一个个小众的高要求场景扎下根,慢慢迭代技术,慢慢扩大应用范围。
路要一步步走,饭要一口一口吃。急着摘果子,往往最后拿到的,都是还没熟的青果。
不是堆神经元数量,是模拟生物神经的事件驱动
很多人对这个方向的第一印象,就是“做一个人造大脑”,凑够上亿甚至上百亿神经元,就能媲美人类大脑。这是误区。 人类大脑的耗能,大概只相当于一个20瓦的灯泡。核心原因从来不是神经元多,而是它只有被激活的神经元才会传递信号,也就是事件驱动的工作模式。不像传统冯诺依曼架构,不管有没有用,都要不停地在内存和运算单元之间搬数据,大部分功耗都浪费在数据搬运上。冯诺依曼架构与类脑架构功耗对比示意图
现在已经发布的不少产品,都喜欢拿神经元数量做宣传,很少有人提突触塑性的实现效率。说白了,很多所谓的类脑芯片,只是用传统数字电路模拟了神经元的连接,并没有真的实现神经突触能随着信号传递改变权重的生物特性。
我见过一个实验室的内部测试,同样做1000类图像识别,某号称亿级神经元的产品,功耗确实比GPU低不少,但延迟是GPU的三倍,准确率还低两个百分点。也就适合用在对延迟不敏感的低算力场景,远没到宣传里那样能颠覆现有格局。
真正难啃的骨头,是在线学习的突触更新。现在大部分产品只能做离线推理,训练好的权重烧进去就不能改,真要让芯片在使用过程中自己更新突触权重,工艺和设计上的问题一大堆,温度漂移、噪声干扰就能把精度冲没了。
卡脖子的不只是制造工艺,还有底层编码逻辑
说实话,我之前也觉得,卡我们的就是先进制程,只要工艺上去了,什么都好说。后来跟做底层设计的工程师聊过才知道,根本不是这么回事。 现在类脑芯片用的脉冲信号,编码逻辑一直没找到最优解。常用的速率编码,靠脉冲的发送频率代表信息,完全浪费了脉冲的时间维度优势,跟传统的数字编码没太大区别,优势发挥不出来。热门的时间编码,靠脉冲发送的时间差编码,对噪声极其敏感。类脑芯片脉冲时间编码原理示意图
举个实际的例子,把用时间编码的类脑芯片装在户外的物联网传感节点上,环境温度变化五摄氏度,传感器输出的噪声稍微涨一点,识别准确率就能掉15个百分点,根本没法商用。
现在也有不少团队在做混合编码方式,把两种编码的优势结合,或者把Transformer的注意力机制适配到脉冲网络上,但大多还停留在仿真阶段,流片出来的少,能稳定跑真实任务的更少。
不过话说回来,就算编码问题解决了,还有架构适配的问题。现在反向传播是深度学习的基础,但脉冲信号是离散的,没法直接做反向传播,大部分方案都是用近似梯度,精度本来就有损失,想要训练大参数的模型,效果还不如传统GPU。
别吹颠覆,先找对自己的应用位置
别吹颠覆,先找对自己的应用位置
现在资本热,什么概念火就往里面砸钱,一堆人喊着要替代GPU,要做通用计算。我只能说,太急了。
类脑芯片的核心优势,从来不是峰值高算力,是低功耗下的单位算力效率。它本来就不该去跟GPU抢数据中心训练大模型的生意,那个地方,人家拼了几十年的生态和工艺优化,根本抢不动。
它真正的机会,在边缘端。在那些电池容量只有几百毫安,又需要做实时AI推理的场景。比如植入式脑机接口,要处理实时脑电信号,又不能让芯片发热烧伤脑组织,对功耗的要求苛刻到极致,这个地方,现有的GPU和低功耗MCU都满足不了,类脑就是最合适的选择。再比如工业物联网里成千上万个传感节点,每个节点都要做本地预处理,不能把所有原始数据都传到云端,低功耗的类脑芯片就比传统芯片合适太多。
现在最大的风险,就是大家都盯着“通用”“颠覆”这些概念炒,没人愿意沉下心解决特定场景的具体问题。很多项目发了顶会论文,拿了融资,流了片,就没有下文了,根本落不了地。
未来十年,类脑都不会取代现有的计算架构。它会作为现有架构的补充,先在一个个小众的高要求场景扎下根,慢慢迭代技术,慢慢扩大应用范围。
路要一步步走,饭要一口一口吃。急着摘果子,往往最后拿到的,都是还没熟的青果。