被高估还是破局者:量子算法研究的真实边界
不是所有问题,都需要量子叠加来算
从理论框架来说,量子计算的优势来源于叠加与纠缠带来的并行性,但这种并行性不是免费的,也不是万能的。我们今天碰到的绝大多数计算问题,从互联网路由到推荐系统排序,从AI模型训练到财务数据统计,经典算法已经在算力成本和精度之间找到了完美的平衡。
哪怕是被写进教科书的Grover算法,理论上能给未排序搜索带来二次加速,放到实际场景里一跑,就能看出问题:现在哪有完全不做预处理的裸搜索?哈希索引、分块预处理早就把搜索复杂度压到了对数级,所谓的二次优势,连工程上的一点额外开销都抵消不了。
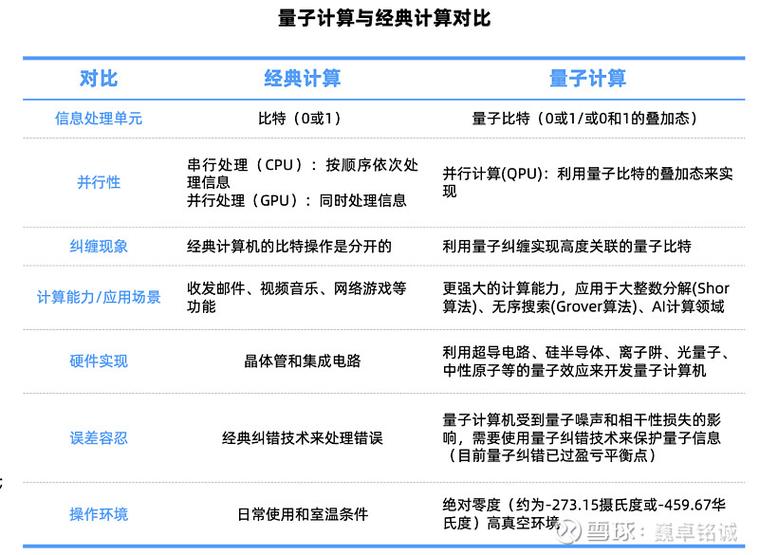 Grover量子算法搜索复杂度对比图
说白了,现在很多市场宣传里的应用,都是拿大概念套小问题。 说白了,就是凑风口。
真正适合量子发力的问题,全都是经典算法摸得到天花板的硬骨头:比如多体系统的量子模拟,比如大规模组合优化中的NP难问题,比如特定的密码分析场景。这些问题卡了经典计算机几十年,不是因为经典算法工程师不够聪明,是物理规则本身就限制了经典系统模拟复杂量子系统的效率,这个是本质上的瓶颈,不是堆算力就能解决的。
当前卡脖子的,从来都不只是原理
很多圈外的人觉得,现在出不了成果是因为原理没想对,算法没设计好。其实真不是。现在至少一半以上拿了顶会认可的算法,都死在了NISQ设备的噪声手里。
没错,就是现在我们能摸到的含噪声中等规模量子设备,别说容错了,连一百个量子比特的连贯运算都做不到,每一次门操作都有误差,累积起来,最后测量出来的结果和随机猜差不了多少。
现在最火的变分量子算法,初衷就是为了适配NISQ设备,把大部分计算压力放到经典端,只让量子计算机做那个经典算不了的部分。听起来很美好对不对?实际跑起来,参数优化的梯度消失问题,比经典深度学习还严重,算一个十多个原子的小分子基态,经典DFT算法半小时出结果,精度够工业用了,变分量子算法跑三天,结果误差还比DFT大一圈。成本翻了几十倍,看不到任何收益。
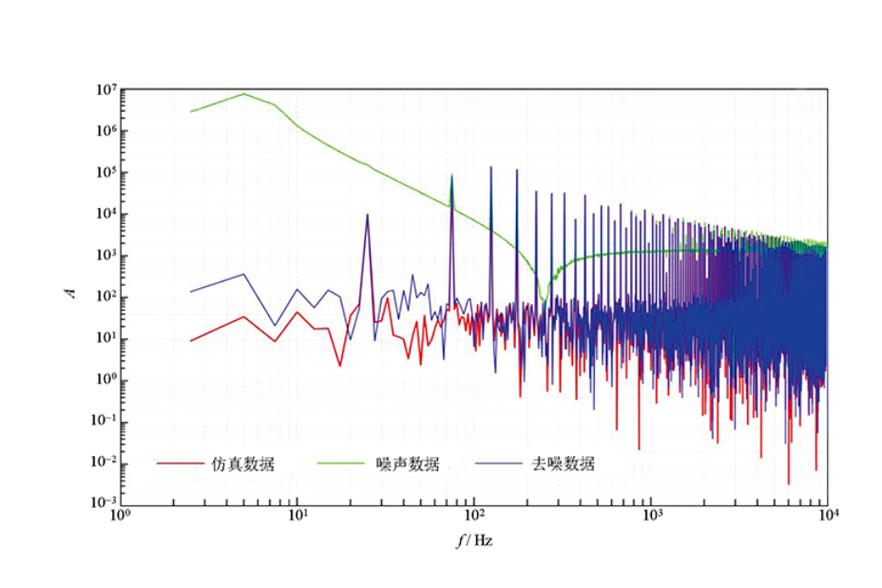 NISQ设备量子比特噪声误差折线图
不过话说回来,也不能全怪硬件。很多算法设计的时候,默认量子比特是理想的,完全不考虑噪声的分布,也不考虑量子比特的连接拓扑,把算法放到真实硬件上,还要做大量的SWAP操作映射,额外引入一堆误差,最后结果能好才怪。还有一个容易被忽略的问题:怎么把实际的业务问题,准确编码到量子态上?现在的编码方案要么需要几倍于问题规模的量子比特,要么会丢失问题本身的非线性特质,绕了一圈,最后还是要经典来补,白瞎了量子的优势。
破局的方向,藏在交叉和务实里
 破局的方向,藏在交叉和务实里
现在圈子里也慢慢回过神来了,不再卷那种纯理论、理想条件下的算法了。现在有意思的工作,大多往两个方向走:一个是和经典算法深度结合,一个是顺着硬件特性做设计。
量子启发经典算法就是很好的例子,把量子算法里的概率分布、叠加思想,用到经典算法的设计里,不需要量子硬件,就能拿到一部分量子的优势,现在已经在计算机视觉、推荐系统里落地出不错的结果了,这个比喊着“十年后颠覆一切”要实在得多。
还有容错量子计算的预研,现在很多人开始做带噪声的算法设计,不是等容错硬件做出来再写算法,而是反过来,算法设计的时候就把噪声的特性考虑进去,做原生容错的算法,哪怕比特数少一点,至少能跑出能用的结果,先解决有没有的问题,再谈好不好。
至于应用的边界,我们也得拎清楚:Shor算法确实能破解当前主流的公钥密码体系,但它需要上千个无误差的逻辑量子比特,以当前的技术进展来看,至少十年内,这个场景根本落不了地。现在吵着说所有密码都要失效,更多是媒体博眼球的噱头。反过来,量子模拟在新能源催化剂、新药研发的场景,现在已经能拿到经典给不出的结果,哪怕现在只能算小分子量,也是实实在在的进展。
风险也不是没有:如果真的容错量子计算出来了,整个互联网的密码体系都要重构,现在的后量子密码标准其实已经在提前布局了,就是怕真到那天手忙脚乱。
不要神化,也不要贬低,路要一步一步走,饭要一口一口吃。急不来。