当算法要"背书":重新理解可信AI技术的落地陷阱
很多人提起这个词,第一反应是商业包装出来的概念,是AI企业用来拿政府项目的由头。说实话,我之前也这么想。直到去年秋天在南京江心洲的一个小会上,听一个做医疗AI的创始人吐了三个小时苦水,才改了主意。他说拿了三类证准备上线,结果卫健委要求所有AI辅助诊断结果必须可追溯可解释,他们原来拿深度学习堆出来的模型,根本说不清楚为什么给这个病灶打了四分。整个项目卡了快一年,投进去的钱都快烧完了。
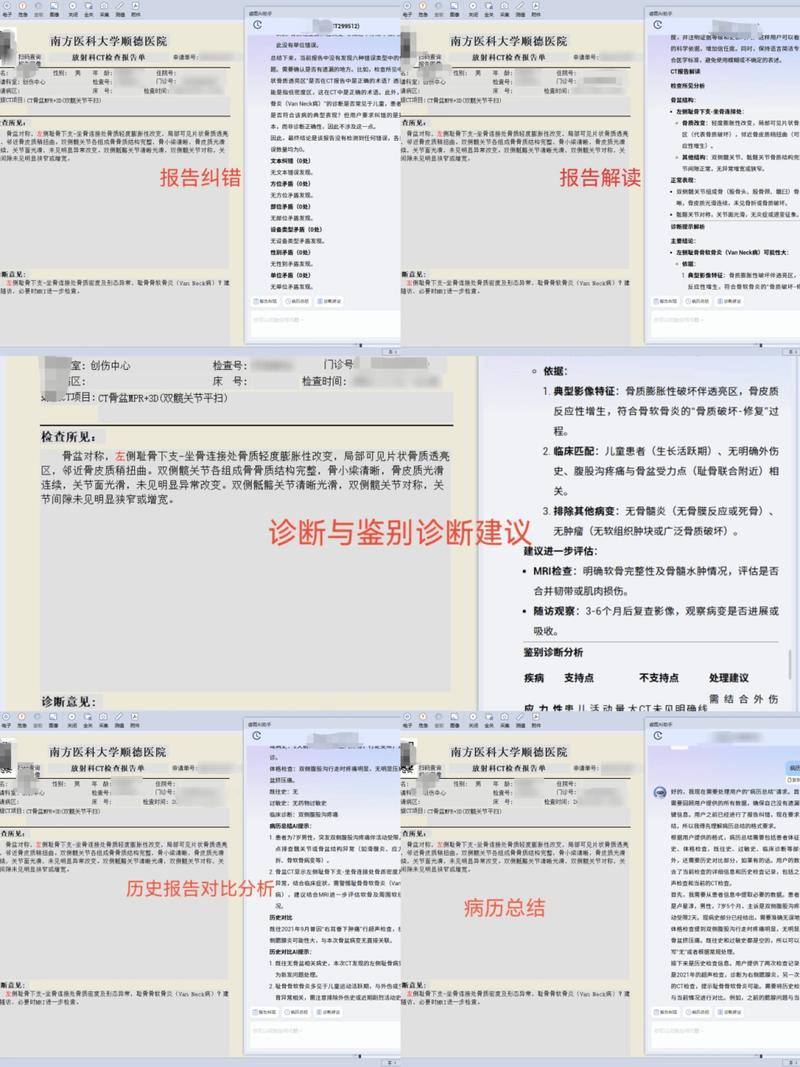 大模型生成医疗诊断报告幻觉案例对比图
很多厂商现在宣传自己的方案可解释,十有八九都是事后可解释,也就是模型先出结果,再用LIME或者SHAP找几个特征凑原因,本质就是给黑盒子穿一件白衬衫。说实话,这种自欺欺人的方案也就骗骗不懂技术的甲方负责人。真到出事的时候,拿出来的归因根本站不住脚。
不过话说回来,也不能全怪厂商。技术本身就有瓶颈。哪有那么多完美的方案。
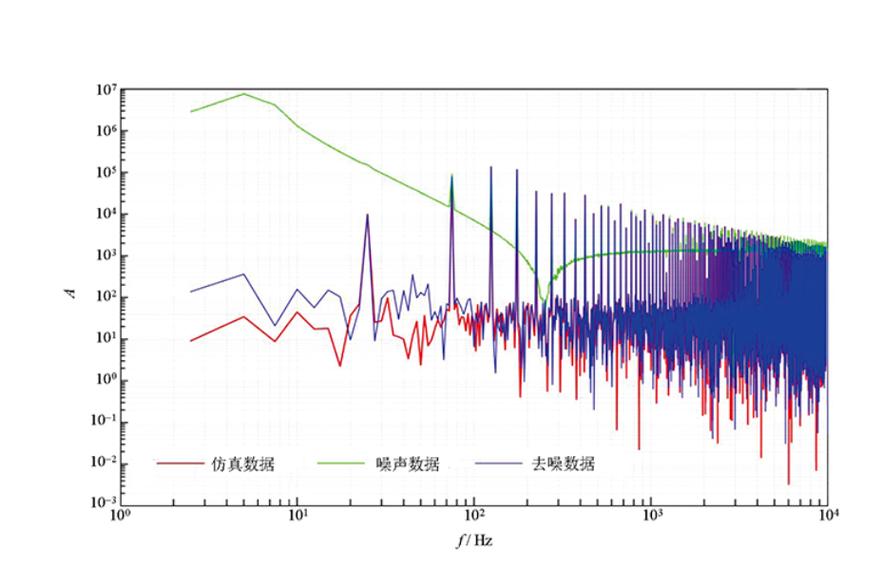 联邦学习差分隐私噪声对模型AUC影响折线图
第三个,鲁棒性和泛化性的冲突。可信要求模型能抗对抗样本,不会被一点点人类看不出来的扰动就骗错。那就要加对抗训练,把各种对抗样本放到训练集里让模型学。但训练多了,模型就会过拟合对抗样本,对正常样本的预测准确率反而会往下降。这个跷跷板,到现在也没有哪个方案能彻底摆平,顶多就是在具体场景里找一个平衡点。
 落地要找窄门,别往宽坑里挤
现在行业里最大的误区,就是认为所有AI都要做可信,恨不得所有模型都套一层可信的壳。其实根本不是这么回事。应用边界从一开始就划的很清楚:如果你做的是给用户生成壁纸、写朋友圈文案这种非核心决策场景,错了根本没什么大损失,根本不需要花额外的成本去做可信,凑活用就行。
但如果你碰的是医疗、金融、自动驾驶、政务这些涉及人身安全、财产权益、公共服务的领域,可信就是必须过的坎。而且这里也不存在绝对的可信,我们要的是可验证的可信,不是嘴炮出来的可信。你说你的模型鲁棒性够,那就拿出来不同对抗扰动下的准确率数据;你说你的模型不泄露隐私,那就拿出来差分隐私的参数和隐私风险量化结果;你说你的模型可解释,那就拿出来一百个样本里解释符合人类逻辑的比例,别空口说白话。
不过话说回来,现在泡沫确实太多了。卖数据安全的换个皮就说自己做的是这个,做旧技术的也蹭概念,反正只要能拿到项目经费,什么牛都敢吹。我见过一个区里的政务项目,本来用传统规则跑的好好的,非要换成大模型加一套可信包装,花了快两千万,上线之后的准确率还不如原来的规则引擎,这哪里是技术落地,这是拿项目经费打水漂!
未来几年,泡沫肯定会慢慢挤出去。真正能留下来的方案,一定不是那种吹出来的“全场景完美方案”,而是在某个具体场景里,把那三个核心矛盾平衡好的方案。比如做信贷审批,我不需要百分之百全流程可解释,只要能把核心否决因素说清楚,满足监管要求,准确率比原来高两个点,就够了。
技术从来都不是越完美越好,是能解决问题才好。对吧。
不是“道德加分项”,是准入门槛
很多舆论总喜欢把这个方向和伦理绑定,说AI要讲道德所以要可信。扯远了。对核心行业来说,这不是道德问题,是能不能进场的问题。 你给自动驾驶做决策算法,高速上识别错一次障碍物就是车毁人亡。你给银行做信贷审批,平白无故拒了一个优质用户,银行损失的不止是利息,还有口碑。哪怕你做内容推荐,天天给用户推他已经看过的内容,或者推他根本不感兴趣的诈骗广告,用户转身就走了。大模型生成医疗诊断报告幻觉案例对比图
很多厂商现在宣传自己的方案可解释,十有八九都是事后可解释,也就是模型先出结果,再用LIME或者SHAP找几个特征凑原因,本质就是给黑盒子穿一件白衬衫。说实话,这种自欺欺人的方案也就骗骗不懂技术的甲方负责人。真到出事的时候,拿出来的归因根本站不住脚。
不过话说回来,也不能全怪厂商。技术本身就有瓶颈。哪有那么多完美的方案。
三个绕不开的核心矛盾
第一个,准确性和可解释性的天然冲突。现在AI性能能打,基本都是靠深度模型堆出来的,参数越多层越深,拟合能力越强,准确率越高,可内部的特征依赖也就越复杂,根本拆不清楚哪一个节点对应了什么人类能理解的逻辑。反过来,像逻辑回归、决策树这种天生可解释的模型,复杂场景下的准确率就是打不过深度学习。 银行信贷审批就是最典型的例子。监管要求必须给用户一个明确的拒绝理由,比如“你征信逾期次数超过三次”,而不是“模型说你不行”。很多银行试过用深度学习替换逻辑回归,准确率确实能涨七八个点,但因为过不了监管的可解释要求,根本没法上线。说白了,就是不能用。 第二个,隐私保护和模型性能的冲突。要做跨机构的联合建模,又不能出原始数据,现在用的最多的就是联邦学习加差分隐私。原理很简单,给每一轮传输的模型参数加噪声,让对方没法反推原始数据。但噪声加的越大,隐私保护越强,对模型性能的影响也就越大。去年南京那个会上,那个跨医院联合建模的项目,加了满足ε=1.0的差分隐私噪声之后,模型AUC直接从0.92掉到了0.85,差了七个点,这个差距放在肺癌早筛里,就是上百个漏诊病例,根本没法用。联邦学习差分隐私噪声对模型AUC影响折线图
第三个,鲁棒性和泛化性的冲突。可信要求模型能抗对抗样本,不会被一点点人类看不出来的扰动就骗错。那就要加对抗训练,把各种对抗样本放到训练集里让模型学。但训练多了,模型就会过拟合对抗样本,对正常样本的预测准确率反而会往下降。这个跷跷板,到现在也没有哪个方案能彻底摆平,顶多就是在具体场景里找一个平衡点。
落地要找窄门,别往宽坑里挤
落地要找窄门,别往宽坑里挤
现在行业里最大的误区,就是认为所有AI都要做可信,恨不得所有模型都套一层可信的壳。其实根本不是这么回事。应用边界从一开始就划的很清楚:如果你做的是给用户生成壁纸、写朋友圈文案这种非核心决策场景,错了根本没什么大损失,根本不需要花额外的成本去做可信,凑活用就行。
但如果你碰的是医疗、金融、自动驾驶、政务这些涉及人身安全、财产权益、公共服务的领域,可信就是必须过的坎。而且这里也不存在绝对的可信,我们要的是可验证的可信,不是嘴炮出来的可信。你说你的模型鲁棒性够,那就拿出来不同对抗扰动下的准确率数据;你说你的模型不泄露隐私,那就拿出来差分隐私的参数和隐私风险量化结果;你说你的模型可解释,那就拿出来一百个样本里解释符合人类逻辑的比例,别空口说白话。
不过话说回来,现在泡沫确实太多了。卖数据安全的换个皮就说自己做的是这个,做旧技术的也蹭概念,反正只要能拿到项目经费,什么牛都敢吹。我见过一个区里的政务项目,本来用传统规则跑的好好的,非要换成大模型加一套可信包装,花了快两千万,上线之后的准确率还不如原来的规则引擎,这哪里是技术落地,这是拿项目经费打水漂!
未来几年,泡沫肯定会慢慢挤出去。真正能留下来的方案,一定不是那种吹出来的“全场景完美方案”,而是在某个具体场景里,把那三个核心矛盾平衡好的方案。比如做信贷审批,我不需要百分之百全流程可解释,只要能把核心否决因素说清楚,满足监管要求,准确率比原来高两个点,就够了。
技术从来都不是越完美越好,是能解决问题才好。对吧。