当计算下沉到设备端:重新理解边缘智能技术的应用边界
去年九月在南京江宁的产学研对接会上,我亲眼见一家做智能交通摄像头的工厂老板拍着桌子吐槽。招标方要的100ms以内的违章抓拍响应,走云端传输,一到下班高峰期网络拥堵,延迟直接蹦到400ms开外,眼睁睁丢了百万级的订单。
这不是个例。太多圈子里的人把计算下沉吹成了包治百病的神药,好像只要把AI挪到数据产生的地方,所有问题都迎刃而解。真不是这么回事。
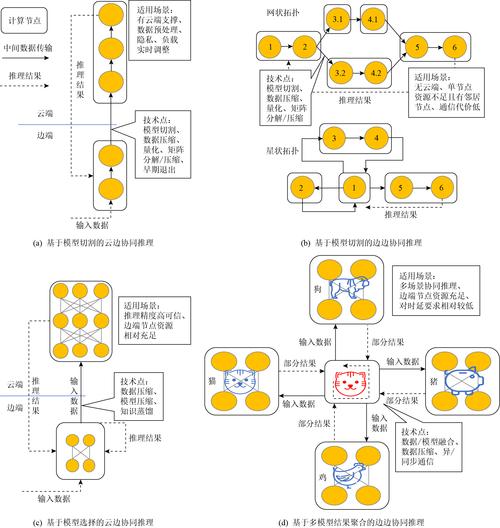 边缘智能与云计算推理流程对比图
反过来看,它能解决的,都是云端天生搞不定的问题。刚才说的违章抓拍,摄像头本地直接完成目标检测和车牌识别,只把结果传到云端,不用传全量视频,既省了带宽,又把延迟压到了几十毫秒以内。这不就是刚好卡在了它的价值区间里?
说实话,见过太多拿概念讲故事的,张口就是替代云计算,喊得比谁都响,真落到场景,连基本的算力适配都搞不定。扯。
 边缘设备动态推理能耗对比实验图
不过话说回来,这些问题都不是死结。针对特定场景做半定制化调整,大部分时候就能拿到能用的结果。工业产线的外观缺陷检测,原来走云端,一旦工厂内网断了,整条线就得停,现在把检测模型放到产线边的网关里,断网也能正常分拣,准确率只掉不到两个点,完全满足生产要求,这样的落地就是有价值的。
 真正的应用边界在哪里
我见过最离谱的事,是一个小区升级门禁,原来把人脸数据传到云端比对,延迟也就一百多毫秒,用户根本没感觉,物业非要听厂商忽悠,换成全边缘本地计算,一套设备多花了三倍的钱,用户体验一点没变。纯浪费。
很多人搞不清,它的核心优势从来不是“比云计算算得更好”,而是三个不可替代的特性:低延迟、带宽成本低、数据不出域。所有符合这三个需求的场景,才是它该待的地方。
自动驾驶的车身控制,要求几十毫秒内完成障碍物检测和决策,你传去云端算,来回延迟都几百毫秒了,早撞上去了,这就必须放边缘做。用户做家用智能马桶的健康检测,粪便隐血这些数据都是高度隐私,直接在马桶的边缘模块分析完,只把异常结果推给用户,原始数据根本不用上传,既满足了需求,又规避了隐私风险,这也刚好踩在价值点上。
反过来,需要全量用户数据联合训练的推荐系统,需要长期汇总分析的城市级交通态势预测,这些活放在云端做,效率比分散在几百上千个边缘节点高得多,没必要硬挪。
概念炒得越热,越要冷静。它不是什么颠覆云计算的新革命,只是整个AI计算架构里的一块补充。能补上云端的短板,解决原来解决不了的问题,那才是真的价值。对吧?
被错估的下沉逻辑
很多人的固有认知,就是把云端的模型压缩一下,塞进边缘设备就完事。实际上,它的核心逻辑从来不是简单的“搬家”。它是把AI的推理环节,甚至碎片化的训练环节,放到数据产生的源头,从架构层面重新分配整个系统的计算负载。 不是所有计算都适合下沉。哪怕是当前最先进的端侧芯片,也撑不起千亿参数大模型的完整推理。更别说预训练这种需要海量算力的环节,至今只能放在云端的数据中心。边缘智能与云计算推理流程对比图
反过来看,它能解决的,都是云端天生搞不定的问题。刚才说的违章抓拍,摄像头本地直接完成目标检测和车牌识别,只把结果传到云端,不用传全量视频,既省了带宽,又把延迟压到了几十毫秒以内。这不就是刚好卡在了它的价值区间里?
说实话,见过太多拿概念讲故事的,张口就是替代云计算,喊得比谁都响,真落到场景,连基本的算力适配都搞不定。扯。
落地绕不开的三个硬约束
要做落地,第一个绕不开的就是边缘节点的资源约束。绝大部分边缘设备都是电池供电,算力撑死几TOPS,内存容量连云端芯片的零头都不到。暴力压缩模型,精度掉得厉害,用户根本不买账。现在行业里走得通的路,是动态按需推理,简单说就是该省的时候省,该使劲的时候使劲。比如说智能门锁的人脸识别,门口半天没人,就跑一个几百KB的轻量人体检测,一旦检测到有人靠近,再激活全精度的人脸比对模型,这么搞下来,能省八成以上的电量,准确率一点没掉。 第二个问题是分布式模型的一致性。几百上千台边缘设备分布在不同地方,模型更新不可能同步到位。同一品牌的无人零售柜,有的更新了新商品的识别模型,有的还是三个月前的旧模型,错识率能差三倍还多。现在常用联邦学习来解决这个问题,各个边缘节点本地训模型,只传参数梯度不传原始数据,聚合成全局模型再更下去。可一旦碰到弱网场景,参数传不上去,整个流程就卡壳了,至今没有通用的低成本解决方案。 第三个是安全和对抗风险。边缘设备物理上暴露在公开场景,又没有云端的大数据交叉校验,很容易被针对。前两年就出过这样的事,有人把精心制作的对抗样本贴纸贴在车牌上,停车场的边缘识别系统直接识别不出来,硬生生逃了大半年的停车费。这种风险,哪怕到今天,也只能靠场景化的规则来补,没有通用的防御方案。边缘设备动态推理能耗对比实验图
不过话说回来,这些问题都不是死结。针对特定场景做半定制化调整,大部分时候就能拿到能用的结果。工业产线的外观缺陷检测,原来走云端,一旦工厂内网断了,整条线就得停,现在把检测模型放到产线边的网关里,断网也能正常分拣,准确率只掉不到两个点,完全满足生产要求,这样的落地就是有价值的。
真正的应用边界在哪里
真正的应用边界在哪里
我见过最离谱的事,是一个小区升级门禁,原来把人脸数据传到云端比对,延迟也就一百多毫秒,用户根本没感觉,物业非要听厂商忽悠,换成全边缘本地计算,一套设备多花了三倍的钱,用户体验一点没变。纯浪费。
很多人搞不清,它的核心优势从来不是“比云计算算得更好”,而是三个不可替代的特性:低延迟、带宽成本低、数据不出域。所有符合这三个需求的场景,才是它该待的地方。
自动驾驶的车身控制,要求几十毫秒内完成障碍物检测和决策,你传去云端算,来回延迟都几百毫秒了,早撞上去了,这就必须放边缘做。用户做家用智能马桶的健康检测,粪便隐血这些数据都是高度隐私,直接在马桶的边缘模块分析完,只把异常结果推给用户,原始数据根本不用上传,既满足了需求,又规避了隐私风险,这也刚好踩在价值点上。
反过来,需要全量用户数据联合训练的推荐系统,需要长期汇总分析的城市级交通态势预测,这些活放在云端做,效率比分散在几百上千个边缘节点高得多,没必要硬挪。
概念炒得越热,越要冷静。它不是什么颠覆云计算的新革命,只是整个AI计算架构里的一块补充。能补上云端的短板,解决原来解决不了的问题,那才是真的价值。对吧?