隐私计算技术:数据流通里的"密门",终于能放心走了
你有没有想过。想要用别人的数据创造价值,又绝对不能碰别人的原始数据。这可能吗?
放在十年前,没人信。放在五年前,只有实验室里的学究在抠满页的公式,没人觉得能落地。现在?这就是隐私计算技术正在干的事。
之前数据行业有个诡异的悖论:所有人都知道数据是石油,是金矿,可偏偏这块金矿你挖不了,我也卖不出,攥在手里怕漏,放出去怕错,活活把一堆黄金变成了占库存的废石头。
为什么说隐私计算技术解决了行业的“心病”?
举个最常见的例子。两家银行想联合做反欺诈,你有我没有的客户,我有你没有的行为记录,合在一起做模型,能把诈骗识别率提三成。可谁敢直接交换客户数据?
《个人信息保护法》直接红牌罚下,搞不好还要负刑事责任。之前试过脱敏去标识化?别扯了,现在只要有一点维度信息,交叉比对分分钟就能把个人身份重新识别出来,早就被监管点过名了,不靠谱。
隐私计算的妙处就在这——数据可用不可见,计算完成即销毁。大家把模型拿到各自的数据源上算,只交换中间的运算参数,原始数据从头到尾都不离开自己的存储域,最后拿到的是共同训练好的模型,谁也拿不到谁的原始数据。
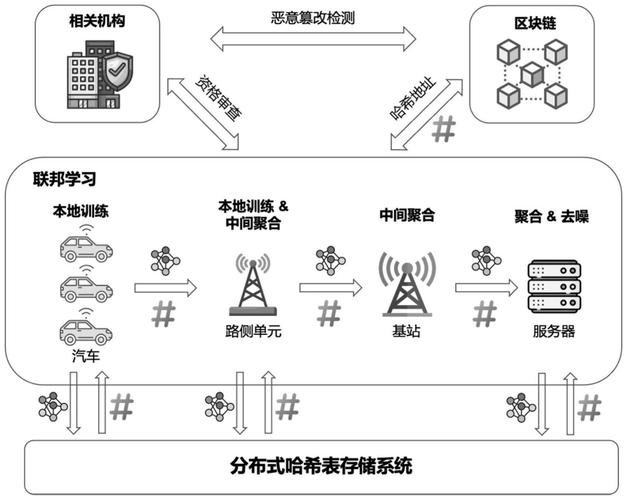 隐私计算联邦学习数据联合训练示意图
我前阵子跟一个做政务数据开放的朋友吃饭,他说之前每年最头疼的就是企业申请开放数据,团队三四个月天天抠脱敏规则,抠完还是睡不好觉,就怕哪条数据漏出去出事故。现在用隐私计算平台,企业提交计算需求,直接在平台上跑,原始政务数据一步都不出去,结果拿了就走,他每天到点下班,甚至能准点接孩子放学。
就这一点,已经值回票价了。
现在隐私计算技术落地,都走到哪一步了?
说实话,三年前我跟圈里人聊隐私计算,十个有八个说这是资本炒出来的概念,实验室里玩玩还行,商用根本慢得要死,成本还高,中小公司根本用不起。
今年再跑行业会,全是落地案例。没人再跟你扯参数性能了,开口就是我跟某城商行做了多少亿笔的联合风控,跟某药企做了三期临床的数据分析,跟某头部互联网做了营销联合建模。
金融是现在落地最多的领域,城商行跨区域联合做风控、信用卡中心做多头借贷识别,不少已经跑了快两年,没出过一起隐私泄露的事故。医疗领域更爽,之前药企找合作医院拿病例数据,伦理审查能卡你大半年,甚至直接过不了,现在用隐私计算,所有数据都不出去,只交换分析结果,审查一个多月就能下来,进度直接快了两倍都不止。
 隐私计算医疗数据联合分析落地场景图
不过话说回来,现在行业确实还有一堆毛病。首先就是标准不统一,不同厂商的框架不兼容,你用安全多方计算,我用联邦学习,对接起来要改大半个月的代码,折腾死个人。其次就是鱼龙混杂,有些啥技术没有的小公司,把十年前的脱敏算法换个包装就敢叫隐私计算,转头去圈投资人的钱,吃相难看至极,说白了就是蹭热点割韭菜。
好在工信部去年已经出了统一的技术标准,头部厂商也在推互联互通的方案,再过个一两年,乱象应该就能清得差不多了。
隐私计算技术接下来,会改变什么?
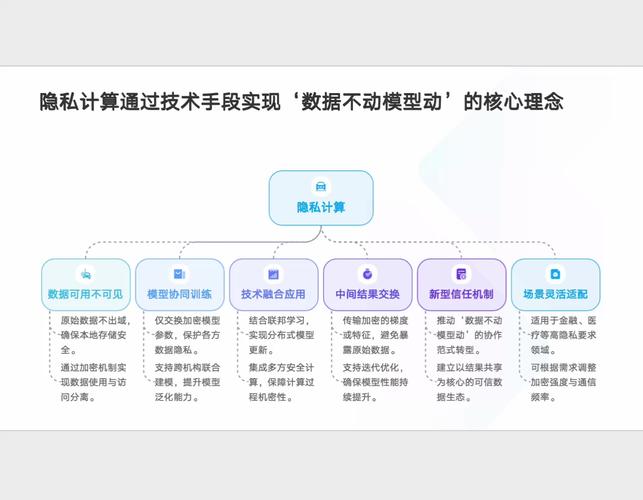 隐私计算技术接下来,会改变什么?
现在全国都在推数据要素市场化,说白了就是让数据像商品一样合法交易流通。可数据这东西跟别的商品不一样,你卖一块猪肉给我,猪肉就是我的了,数据你卖一份出去,原持有者还留着一份,还能再卖十次,买的人也不敢保证自己买的是独一份,原持有者还怕拿到数据的人拿去乱造,责任全算自己头上。
隐私计算刚好戳中了这个痛点,它能把数据的所有权和使用权彻底拆分:买家买到的只是计算结果的使用权,拿不到原始数据,既不会泄露隐私,原所有者也能一直持有所有权,按使用次数分润,完美解决了数据交易的核心矛盾。
我上个月去南方某省级数据交易所参观,看到现在上线的交易产品,超过六成都是用隐私计算做的,这渗透率涨得真的吓人。三年前全中国隐私计算的商业化项目加起来不到一百个,去年已经破一千个了,资本砸进去的钱早过千亿了。
也别把它吹得太神,隐私计算不是万能的。它解决的是隐私保护和数据流通的矛盾,解决不了数据本身的质量问题,你拿一堆错的原始数据进去,它也算不出对的结果,这点拎清楚就不会被割韭菜。
就说现在火得一塌糊涂的大模型,各家都在抢高质量数据训模型,谁敢随便拿用户的原始数据训?去年不少厂商因为这个被罚了多少?国内现在一堆大模型厂商都在布局隐私计算的联邦训练,各家的原始数据都不出域,一起训模型,既合规,又能用到多方的数据,这不就是未来的方向吗?
说白了,互联网过去二十年的发展,本质就是数据流动带来的红利。可流动到后来,大家都怕了,随便一个小APP都敢偷你通讯录偷你位置,整个行业对数据隐私的神经都绷断了。隐私计算不是要把数据锁起来,它是给数据流动安了一道锁,一道只有授权才能开的锁,该流的价值流出去,该藏的隐私藏起来,这才是健康的数据生态该有的样子。