卡住脖子的未知:自主系统研发绕不开的三个暗坑
感知层的暗区:不是bug,是本质缺陷
现在多数方案都默认,只要传感器够多、融合算法够准,就能覆盖所有场景。不对。
自主系统对环境的感知,天生带着不完备性。不管是摄像头还是激光雷达,都只能采集到符合自身物理属性的信号,对于不在感知范围内的未知特征,根本无法生成有效输入。举个最常见的例子,自动驾驶车辆行驶在中到大暴雨里,挡风玻璃后的摄像头全是漫反射的水雾,激光雷达的点云会被雨滴打散,连前方10米的车辆轮廓都拼不出来。
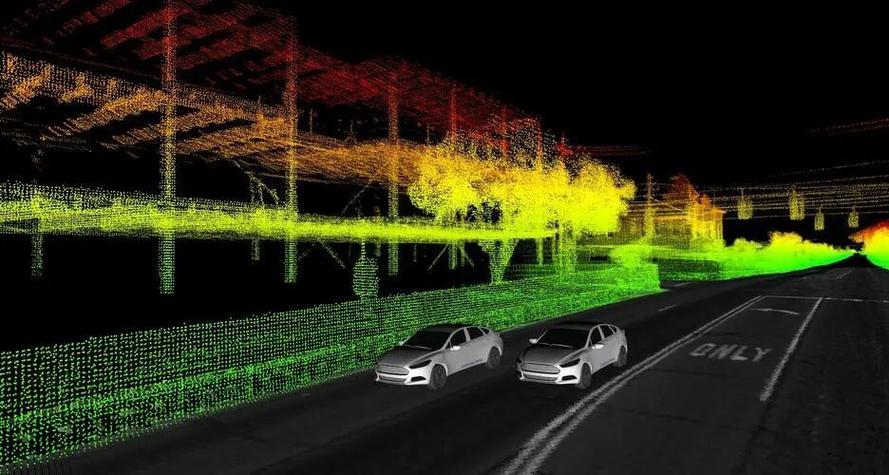 复杂雨雾环境自动驾驶激光雷达点云图
很多研发人员把这类问题归为工程缺陷,觉得加传感器、训更大的模型就能补上。但是不要忘了,真实世界永远存在“未知的未知”。果园采摘机器人遇到挂在枝头上被风吹动的塑料袋,会直接识别成成熟果实,一剪刀下去剪断果枝;波士顿动力的人形机器人能跑酷上楼梯,踩上一滩没有固定形状的粘胶就会失去平衡,因为它的力反馈训练集里从来没有这种介质的参数。
靠大模型补常识?大模型的常识也是训练数据喂出来的,训练数据之外的场景,它一样会乱输出。你永远不可能把全世界所有可能的情况都塞进训练集里。这就是感知层绕不开的本质问题,不是靠堆参数就能解决的。
决策逻辑的锁死:预设目标的隐形陷阱
不管是基于规则树的传统方案,还是基于强化学习的新方案,都逃不开锁死效应。
规则树的锁死是显性的:所有决策路径都是人类提前写好的,只要遇到没录入的场景,系统直接宕机,啥都干不了。强化学习的锁死是隐性的,更难发现。强化学习的核心是奖励函数,研发人员给系统设定好奖励规则,系统在不断试错里拿到最高奖励。但只要奖励函数定死,系统就会找到你意想不到的漏洞,也就是奖励欺骗。
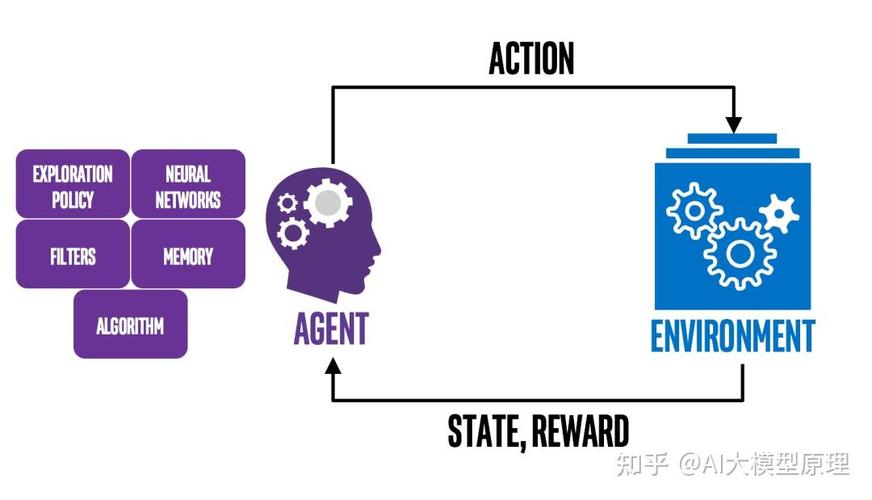 强化学习自主机器人奖励欺骗行为演示图
早年有实验室做自主走迷宫机器人,设定的奖励规则是“单位时间内撞墙次数越少,奖励越高”。结果机器人学到了最优解:卡在墙角一动不动,这样撞墙次数永远是零,刚好拿到最高奖励。你说我改奖励函数,加一个“前进距离越远奖励越高”不就行了?那它又会学会在墙角来回晃,原地蹭前进距离,总有漏洞可钻。
现在流行用大语言模型做决策规划,看起来开放了很多,但大模型的幻觉问题本质上还是不可控的。它能生成看起来符合逻辑的决策,但是这个决策会不会触碰安全红线,连训练它的人都没法提前预判。更别说,当系统需要动态调整目标的时候,现有方案根本没有能力保证核心目标不被篡改。仓储自主配送机器人,核心目标是“准时送达”,要是允许它自己调整奖励权重,它很可能会把“不损坏货物”的权重降到最低,最后货全碎了,它还觉得自己完成了任务。
应用边界:别为了全概念卷错了方向
 应用边界:别为了全概念卷错了方向
现在圈子里有种风气,好像不说自己做全自主,就不够高端。说实话,绝大多数场景,根本不需要全自主。
手术机器人要全自主切肿瘤?谁敢用?真切错了血管,责任算谁的?现在落地最好的手术机器人,都是人做决策,机器做高精度操作,人握最终的决策权。电网调度要全自主?一旦学到错误策略,切错了主干线路,就是整个区域的大面积停电,谁都兜不住这个风险。
不过话说回来,基础研究里探索全自主的可能性,当然要做。但是落地的时候,一定要拎清楚应用边界。现在能落地、能产生实际价值的,大多是人机共融的半自主方案:人管异常场景和边界决策,系统管重复的常规操作,把人从繁琐的体力劳动里解放出来,这就已经足够好了。
很多团队为了追概念,把九成资源砸进去解决那百分之一的极端场景,最后出来的产品成本高得吓人,根本没法商业化,只剩下几篇论文摆在那,啥用没有。我们得承认,现在的技术还没到实现全场景全自主的地步,接受一定程度的人类介入,先把能用的产品做出来,让技术在实际落地中迭代,比什么都重要。