藏在数据里的暗坑:重新认识合作满意度调研
上个月0923南京江宁的产学研对接茶歇上,碰到一个做汽车零配件的生产厂长,吐了一肚子苦水。
去年找第三方做了一轮,拿到的结果很漂亮,均分快88分,大部分供应商都勾选了满意或非常满意。结果年底开供应商大会,三个核心配套商当场说,明年给你们的产能降25%,你们账期太长,我们垫不起。他当时整个人懵了。
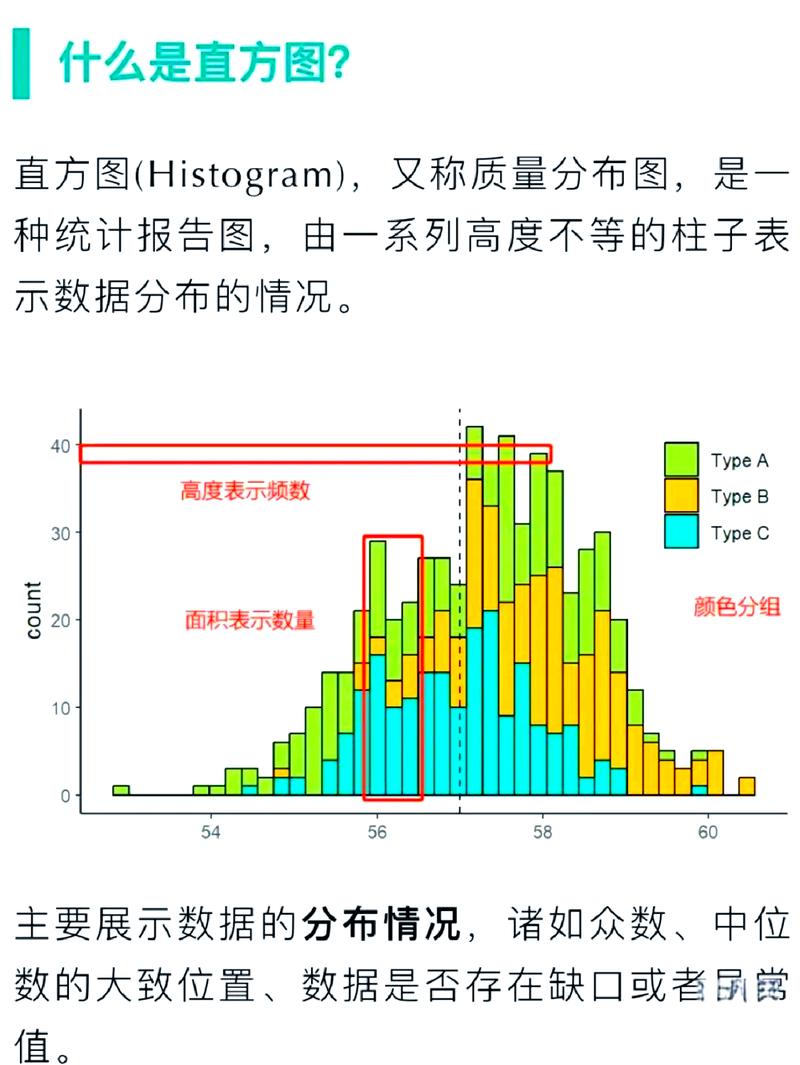 制造业供应商合作满意度虚假数据分布直方图
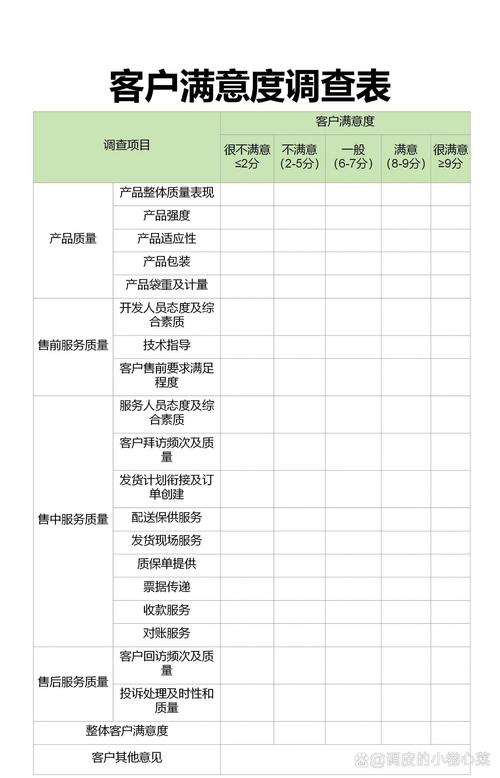 产学研合作节点满意度拆分调研表示例
 落地时容易踩的三个隐形边界
第一个边界,不要拿一套量表套所有合作类型。To B供应商合作最在意的是账期、交付稳定性、质量合格率;异主体产学研合作最在意的是权利分配、信息透明度、经费及时性;项目制外包合作最在意的是需求变更灵活性、验收标准清晰度。你拿给供应商的问卷去问产学研合作的对象,关键问题没问到,出来的分数再好看也没用。
第二个边界,不要刻意回避负面问题。很多调研设计的时候,怕得罪合作方,全是正向题,连开放式提问都不敢放,就怕收回来一堆抱怨不好交差。说实话,调研本来就是来找问题的,不是拿好看的分数做PPT给老板看的。上次那个厂长,后来翻当时回收的问卷,开放题里三个要走的供应商都写了「付款流程长达60天,远超行业平均水平,现金流压力过大」,当时负责整理数据的人觉得这是小问题,没放进汇总报告里,最后闹到产能砍半才追悔莫及。
第三个边界,不要把调研结果当终点。太多机构做完调研,算完分数,把报告往文件柜一锁,这事就结束了。调研本身不产生任何价值,针对低分节点的调整才是。
不过话说回来,也不是说分数完全没用,分数可以做长期对比,今年比去年低了,说明哪里出问题了,单一年份的绝对分数,没多大意义。
现在有个新趋势,用客观行为数据辅助主观调研,比如统计双方对接的平均响应时长,需求变更的次数,合同履约的偏差率,这些客观数据不会骗人,比受访者打出来的分数靠谱很多。但也不能完全替代主观调研,比如合作双方的信任度,对接过程中的顺畅感,这些软感受,还是要通过主观提问才能拿到。
别为了好看的分数做调研。那些藏在模糊数据里的小不满,攒得多了,就是掀翻合作的大浪。
我们拿到的大多是虚假满意数据
为什么会出现这种情况?绝大多数调研从设计阶段就错了。默认受访者会说真话,默认满意度可以用一个总分概括,默认满意等于愿意继续合作。这三个前提,没一个站得住脚。 第一个,人情社会里,给长期合作的伙伴打低分,本身就是需要勇气的事。对接人拿的是对方对接人递的烟,一起吃过好几次饭,怎么好意思勾选不满意?哪怕真有不满,也多半选个一般,给彼此留面子。 时机也不对。刚完成一个项目,双方还在客气阶段,你转头就发调研,谁会对着刚喝完庆功酒的伙伴扎针?等过半年,问题攒了一堆,没人想起再问一句。 还有题目设计的坑。几乎所有通用问卷,都是模糊化的正向设问,把沟通、交付、付款、售后所有问题揉成一团,最后出来一个模糊的分数,具体哪出问题了,根本看不到。制造业供应商合作满意度虚假数据分布直方图
锚定真实感受的核心:拆分而非汇总
要拿到真实结果,第一步就要扔掉「总得分」这个执念。把合作拆成一个个具体的、可落地的节点,每个节点单独测感受,不要揉在一起。 比如产学研合作,不要问笼统的整体感受,要拆成:课题立项阶段目标沟通清晰度、合作过程中月度对接及时性、经费拨付节点准点率、知识产权分配约定清晰度、成果转化阶段配合度,每个节点单独问,谁好谁坏一眼能看到。 反例随处可见。去年接触过一个地方高校的合作处,每年做一次年度调研,汇总满意度常年在90分以上,整理旧档案的时候翻开放题栏,才看到有五个课题组都提了「企业经费经常拖3个月以上,课题组买试剂都要垫钱」,汇总的时候这些负面信息被平均掉了,没人当回事,最后三个课题组直接终止了和这家企业的所有合作,校方才后知后觉。 拆分还要分主体。对接岗的感受和决策层的感受,完全是两码事。对接岗天天和你方人员对接,改方案改到崩溃,对你方的沟通效率一肚子火;决策层只看最后有没有拿到符合要求的成果,觉得一切顺利。如果把两类人的问卷混在一起统计,低分被高分稀释,最后得到的还是虚假结果。 当然,拆分也有边界,不是拆得越细越好。拆到具体合作节点就停,拆到每个对接人员的个人喜好就过度了,那不是调研,是内部八卦,对改进合作没任何用。产学研合作节点满意度拆分调研表示例
落地时容易踩的三个隐形边界
落地时容易踩的三个隐形边界
第一个边界,不要拿一套量表套所有合作类型。To B供应商合作最在意的是账期、交付稳定性、质量合格率;异主体产学研合作最在意的是权利分配、信息透明度、经费及时性;项目制外包合作最在意的是需求变更灵活性、验收标准清晰度。你拿给供应商的问卷去问产学研合作的对象,关键问题没问到,出来的分数再好看也没用。
第二个边界,不要刻意回避负面问题。很多调研设计的时候,怕得罪合作方,全是正向题,连开放式提问都不敢放,就怕收回来一堆抱怨不好交差。说实话,调研本来就是来找问题的,不是拿好看的分数做PPT给老板看的。上次那个厂长,后来翻当时回收的问卷,开放题里三个要走的供应商都写了「付款流程长达60天,远超行业平均水平,现金流压力过大」,当时负责整理数据的人觉得这是小问题,没放进汇总报告里,最后闹到产能砍半才追悔莫及。
第三个边界,不要把调研结果当终点。太多机构做完调研,算完分数,把报告往文件柜一锁,这事就结束了。调研本身不产生任何价值,针对低分节点的调整才是。
不过话说回来,也不是说分数完全没用,分数可以做长期对比,今年比去年低了,说明哪里出问题了,单一年份的绝对分数,没多大意义。
现在有个新趋势,用客观行为数据辅助主观调研,比如统计双方对接的平均响应时长,需求变更的次数,合同履约的偏差率,这些客观数据不会骗人,比受访者打出来的分数靠谱很多。但也不能完全替代主观调研,比如合作双方的信任度,对接过程中的顺畅感,这些软感受,还是要通过主观提问才能拿到。
别为了好看的分数做调研。那些藏在模糊数据里的小不满,攒得多了,就是掀翻合作的大浪。