拆解当下推荐系统技术:从刷视频到点外卖,藏着你不知道的进化与坑
你有没有过这种经历?
本来打开短视频只想搜个宫保鸡丁的做法,结果一划就是三个小时,最后看完了一整辑猫咪拆家合集。
打开外卖软件,首页第一个推的刚好就是你上周想吃没敢点的烧烤。
逛电商搜了一次婴儿车,接下来半个月打开首页全是母婴用品,烦得你想拉黑。
这些全都是推荐系统的功劳——或者说,锅。
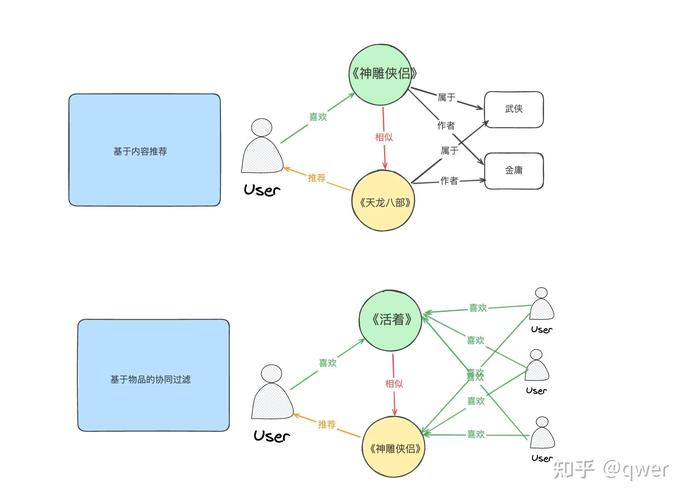 传统推荐系统协同过滤用户物品矩阵图
那时候的算法,现在看来粗糙得很,数据少的时候推不准,数据多了算不动,性能卡得要死。
后来慢慢进化成了“多路召回+精排”的经典架构,这个架构用到现在,绝大多数互联网公司的核心推荐链路还是它,哪怕是抖音淘宝这种顶流,也没完全换掉。
什么是多路召回?简单说就是先从全量商品库里,用不同的策略快速筛出几百个你可能感兴趣的,比如从历史浏览里捞一批,从同类用户喜欢的里捞一批,从热门内容里捞一批,先把范围缩小。然后再交给精排模型,挨个给这些候选打分排序,把分最高的十几个放到你首页。
现在吹的大模型推荐,根本不是把整个架构全换了。
绝大多数落地的方案,都是大模型做召回阶段的语义理解,或者冷启动的兴趣挖掘,该用传统精排的地方还是用,毕竟全用大模型跑一遍,一个请求几秒出结果,用户早划走了,成本也扛不住。
之前见过不少创业公司拿“全大模型推荐”吹牛逼,说白了就是割投资人的钱,真上线跑两天,GPU账单就能把公司拖垮。
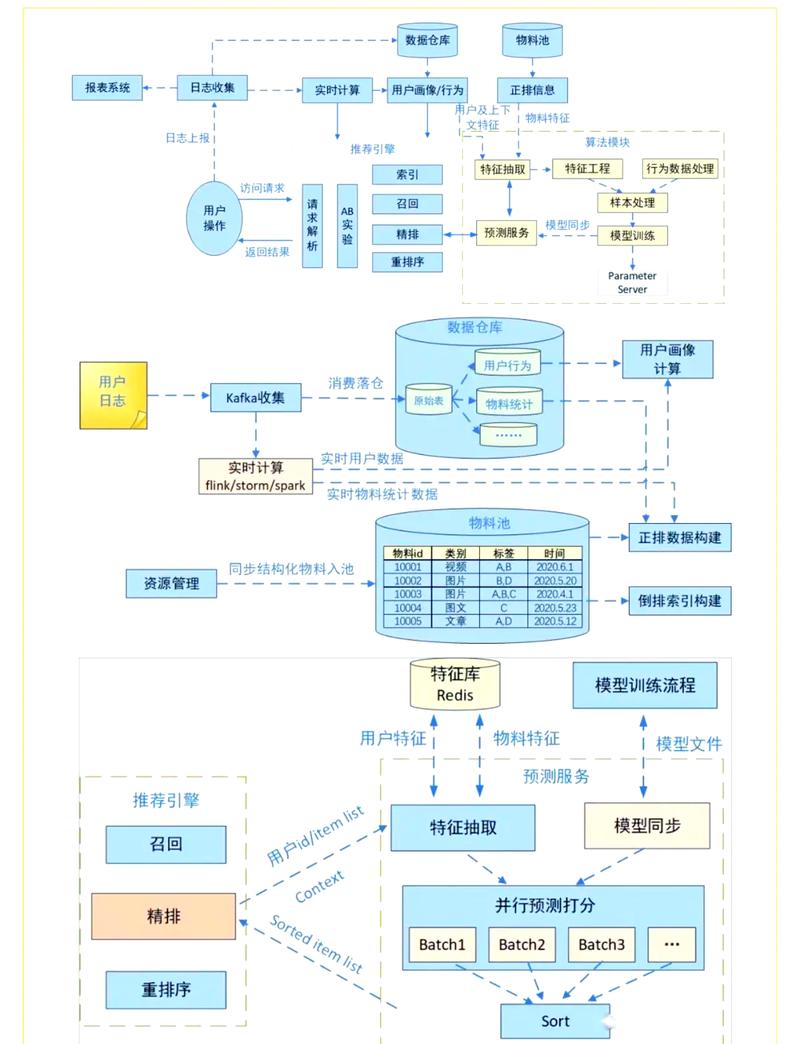 现代推荐系统多路召回精排架构流程图
这张图很多人都在论文里见过,可真到落地调参的时候,每个公司的坑都不一样,哪有什么通用的完美方案。
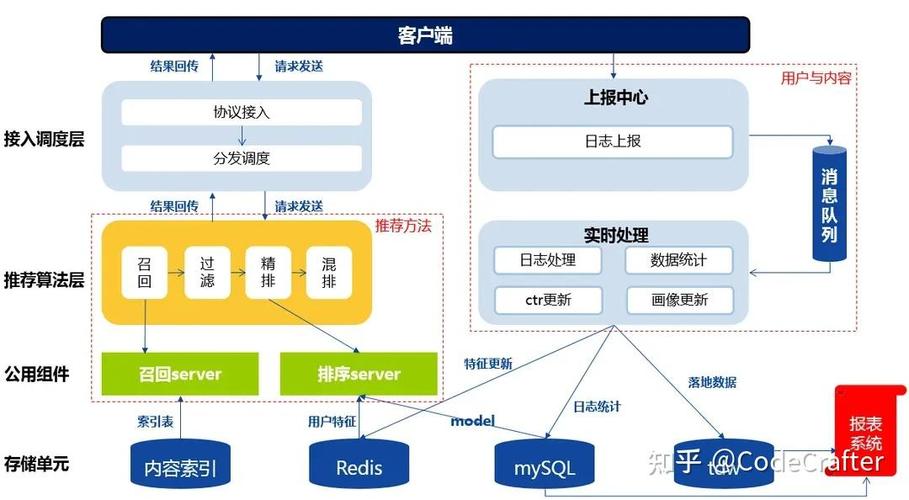 接下来推荐系统技术会往哪儿走?我看好两个落地方向
很多论文吹的花里胡哨的方向,其实十年内都落不了地,我反倒觉得两个方向接下来会很快普及。
第一个就是大模型和传统推荐架构的深度耦合。
不是替换,是互补。大模型擅长语义理解,擅长从零散的用户行为里挖潜在兴趣,那就让大模型干这个,多路召回阶段帮忙筛更准的候选,冷启动阶段帮忙快速打标签。传统的精排模型擅长点击率转化率预估,速度快成本低,那就还是干精排。
这种玩法现在已经在大厂落地了,效果确实比纯传统架构好,成本也比纯大模型推荐低太多,接下来一两年,中大型公司都会跟上。
第二个方向就是用户可控的推荐。
之前算法都是黑盒,你不知道为什么给你推这个,也改不了,只能被动接受。现在越来越多产品开始做开放控制了,比如你可以直接说“我不想再看这类内容”,甚至可以调整推荐的探索比例,“我今天就想看点新鲜的”。
不过话说回来,这个方向也难,让用户控制多了,点击率下降,KPI不好看,所以很多公司不愿意做。但用户的抱怨已经越来越多了,早做早抢用户,对吧?
我之前跟一个算法总监聊天,他说做推荐这么多年,最大的感悟就是,推荐系统不是要把用户拴在你的产品里,是要帮用户找到他真正想要的东西。
说真的,我挺认同这句话。你现在能看到这篇文章,本身就是推荐系统技术发挥作用的结果——它猜对了你想看点有意思的技术内容,对吧?
别再迷信大模型万能论,现在的推荐系统早不是十年前的协同过滤了
说实话,很多外行人提起推荐系统,第一反应要么是“不就是给人贴标签推同类吗”,要么就是“现在都全换大模型了对吧”。 真不对。 最早的推荐系统确实简单,十年前淘宝刚做个性化推荐的时候,主流用的就是协同过滤,核心逻辑就是“和你兴趣差不多的人喜欢什么,就给你推什么”。传统推荐系统协同过滤用户物品矩阵图
那时候的算法,现在看来粗糙得很,数据少的时候推不准,数据多了算不动,性能卡得要死。
后来慢慢进化成了“多路召回+精排”的经典架构,这个架构用到现在,绝大多数互联网公司的核心推荐链路还是它,哪怕是抖音淘宝这种顶流,也没完全换掉。
什么是多路召回?简单说就是先从全量商品库里,用不同的策略快速筛出几百个你可能感兴趣的,比如从历史浏览里捞一批,从同类用户喜欢的里捞一批,从热门内容里捞一批,先把范围缩小。然后再交给精排模型,挨个给这些候选打分排序,把分最高的十几个放到你首页。
现在吹的大模型推荐,根本不是把整个架构全换了。
绝大多数落地的方案,都是大模型做召回阶段的语义理解,或者冷启动的兴趣挖掘,该用传统精排的地方还是用,毕竟全用大模型跑一遍,一个请求几秒出结果,用户早划走了,成本也扛不住。
之前见过不少创业公司拿“全大模型推荐”吹牛逼,说白了就是割投资人的钱,真上线跑两天,GPU账单就能把公司拖垮。
现在推荐系统技术最头疼的三个痛点,全行业都在啃
推荐系统做了几十年,至今还有一堆解决不了的问题,每个做算法的都挠头。 第一个就是冷启动。 新用户刚注册,啥行为数据都没有,你给人推什么?推热门内容吗,那个性化等于没有,用户留不住。靠注册时选的兴趣标签吗?绝大多数用户注册的时候都是随便点,根本不准。 现在主流的玩法是靠大模型做语义冷启动,你填个个人简介,或者搜了一个关键词,大模型直接给你挖出潜在兴趣,比之前的规则匹配准多了,但还是达不到老用户的推荐精度,对吧? 第二个就是所有人都骂的信息茧房。 你喜欢看养猫的内容,算法就一直给你推养猫的,推到你最后刷不出任何别的东西,烦都烦死了。 现在行业里的解法是做探索-利用(EE)平衡,说白了就是每天固定拿出一部分流量,给你推一点你没接触过的内容,碰对了,就抓住了你新的兴趣,碰错了,你最多划走,损失也不大。 之前抖音内部测过,把探索内容的占比从5%提到15%,整体用户停留不跌反涨,你说有意思不?很多人其实潜意识里也想看点不一样的,只是自己不说。 第三个就是多场景兴趣对齐。 你上周出差搜了一次上海的酒店,你说算法该不该接下来半个月一直给你推酒店? 大多数时候不该,因为你搜酒店是一次性需求,不是你真的喜欢酒店。但如果你是做酒店采购的,天天搜酒店,那又该推。 怎么区分不同场景下的真实意图?现在的算法还做不到百分百准确,不然也不会有那么多人吐槽“搜了一次就推一辈子”。现代推荐系统多路召回精排架构流程图
这张图很多人都在论文里见过,可真到落地调参的时候,每个公司的坑都不一样,哪有什么通用的完美方案。
接下来推荐系统技术会往哪儿走?我看好两个落地方向
接下来推荐系统技术会往哪儿走?我看好两个落地方向
很多论文吹的花里胡哨的方向,其实十年内都落不了地,我反倒觉得两个方向接下来会很快普及。
第一个就是大模型和传统推荐架构的深度耦合。
不是替换,是互补。大模型擅长语义理解,擅长从零散的用户行为里挖潜在兴趣,那就让大模型干这个,多路召回阶段帮忙筛更准的候选,冷启动阶段帮忙快速打标签。传统的精排模型擅长点击率转化率预估,速度快成本低,那就还是干精排。
这种玩法现在已经在大厂落地了,效果确实比纯传统架构好,成本也比纯大模型推荐低太多,接下来一两年,中大型公司都会跟上。
第二个方向就是用户可控的推荐。
之前算法都是黑盒,你不知道为什么给你推这个,也改不了,只能被动接受。现在越来越多产品开始做开放控制了,比如你可以直接说“我不想再看这类内容”,甚至可以调整推荐的探索比例,“我今天就想看点新鲜的”。
不过话说回来,这个方向也难,让用户控制多了,点击率下降,KPI不好看,所以很多公司不愿意做。但用户的抱怨已经越来越多了,早做早抢用户,对吧?
我之前跟一个算法总监聊天,他说做推荐这么多年,最大的感悟就是,推荐系统不是要把用户拴在你的产品里,是要帮用户找到他真正想要的东西。
说真的,我挺认同这句话。你现在能看到这篇文章,本身就是推荐系统技术发挥作用的结果——它猜对了你想看点有意思的技术内容,对吧?