从“上系统”到“改闭环”:智能化升级方案的隐性成本与可行路径
谈智能化升级方案,容易滑向设备清单和模型选型。实际约束更棘手:数据契约、组织权限、时延预算、责任归属。一个模型准确率提升三个百分点,未必能抵消一次误报造成的产线停机。于是问题从“买什么”变成“闭环在哪里断”。
把智能拆成可验收的零件
工业场景里的智能,通常由四段构成:感知、判断、执行、反馈。感知层负责把物理量变成可计算信号;判断层做分类、预测或优化;执行层把结论落到PLC、机器人、工单或阀门;反馈层记录结果并回流。缺一段,智能化升级方案就会退化成演示系统。比如预测性维护,若没有维修工单闭环,预警只是一条未读消息。
可验收的零件意味着每个环节都要有指标:感知层看采样完整率与信噪比,判断层看精确率、召回率、校准误差,执行层看指令成功率与响应时延,反馈层看回流周期与标注一致性。这里有一个常被忽略的条件:置信度阈值必须与业务成本挂钩。漏报成本高,阈值调低;误报成本高,阈值调高。没有这个映射,算法指标再漂亮也无法落地。
反例并不少见。某注塑车间试图用模型自动调整模温,算法侧训练得不错,现场却卡在执行层——模温机通信协议不开放,参数写入需要人工确认。结果系统只能给出建议,无法形成闭环。此时继续优化模型没有意义,先解决接口和数据主权更划算。
 工厂车间OT与IT系统融合架构示意图
因此,方案设计的第一步不是选大模型,而是画接口清单:谁提供数据,频率多少,谁有权写入,失败如何回退。接口清单越清楚,后期返工越少。
数据不是石油,更像需要维护的路网
“数据是石油”这个比喻容易误导。石油采出来可以储存,数据却会过期、漂移、被错误标注。它更像路网:需要持续养护,否则今天能走的路径,明天可能因为施工或塌陷而中断。OT数据高频、噪声大、时间戳格式各异;IT数据业务语义强,但更新滞后。两者对齐时,单位、时区、设备编号、批次号都可能成为陷阱。
一个可操作的概念是数据契约。字段含义、采样频率、质量阈值、责任方、变更流程,都要写清楚。没有数据契约,智能化升级方案往往变成一次性数据清洗项目,上线后三个月又回到原点。特征存储和数据版本管理不是大厂专属,边缘侧同样需要轻量方案:关键特征做版本快照,推理时记录模型版本和输入摘要。
限制也要说明。不是所有数据都值得采集。增加一个传感器,意味着供电、布线、标定、维护和隐私合规成本。边际收益递减出现得比想象中早。某设备振动监测项目把采样率从1kHz提高到20kHz,故障识别率没有显著提升,存储和传输成本却翻了数倍。后来回退到5kHz,配合事件触发采样,反而更稳。
 基于数字孪生的产线智能化升级仿真界面
数据质量还有一个社会维度:现场人员愿不愿意如实录入。若系统把异常记录用于惩罚,数据就会迅速失真。设计反馈回路时,需要把“上报异常”与“追责”适度分离,否则再好的采集架构也会被博弈行为掏空。
人在回路不是补丁,而是责任分配
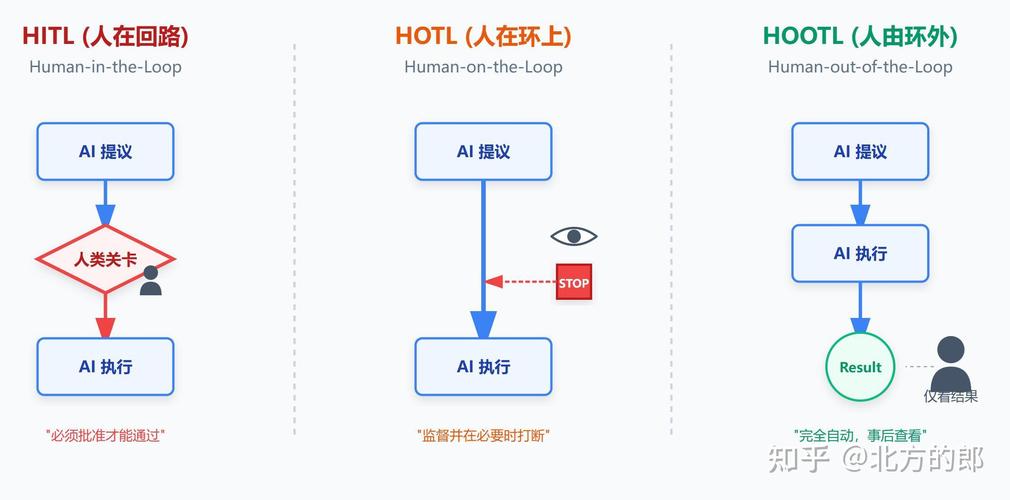 人在回路不是补丁,而是责任分配
自动化与自主性不是一回事。自动化按规则执行,自主性在不确定环境中做选择。高风险场景里,把选择权完全交给模型,既不经济也不合规。人在回路的价值不只是提高准确率,更是把责任分配到可审计的节点上。
具体设计可以这样:模型输出附带置信度和证据片段;低置信度触发人工复核;人工修改结果回流为训练样本;所有决策留有版本记录。这里的关键是异常升级路径,而不是简单弹窗。弹窗太多,操作员会习惯性点击确认,系统反而制造虚假安全感。某化工企业曾把报警阈值设得过密,操作员逐渐忽略警报,直到一次真实泄漏才暴露问题。阈值管理因此也是人机交互设计。
知识助手类应用同样如此。检索增强生成可以给出引用来源,但引用不等于正确。若知识库本身存在过期文件,模型会自信地复述错误。可行做法是给文档打时效标签,回答时标注生效日期,并允许一线人员一键纠错。模型幻觉在工业场景不是趣味问题,而是安全边界问题。
影子模式与反事实验证
 影子模式与反事实验证
验证智能化升级方案,不能只看离线准确率。更冷的做法是影子模式:新模型并行运行,不直接控制执行层,只记录它与现有策略的差异。差异积累到统计显著后,再讨论是否放量。数字孪生可用于反事实推演,但仿真与现实总有缝隙,缝隙大小本身需要评估。
业务指标要提前绑定。设备综合效率、单位能耗、缺陷逃逸率、平均修复时间,这些指标比F1分数更接近决策语言。一个反例是AI质检:离线测试准确率很高,上线后因为光照变化和产品换型,假阳性激增,复检工作量反而上升。后来加入在线校准和拒识机制,把不确定样本交给人,整体成本才下降。
停止规则同样重要。若三周内未达到预设阈值,应回退或缩小范围。无限试点会消耗组织信任。试点不是目的,学习才是。每次回退都应留下可复用的接口、数据和经验。
边界与反例:哪些场景不该急着升级
有几类场景需要谨慎。样本极少且长尾严重,流程尚未标准化,责任无法转移,规则频繁变动。比如病历质控,编码规则更新快,模型刚上线就可能过期;法律文书生成涉及责任归属,错误代价高。此时更合理的路径是先做规则引擎和流程数字化,等数据分布稳定后再引入学习模型。
趋势层面,边缘智能、联邦学习、智能体编排都在推进。边缘推理降低时延,联邦学习缓解数据孤岛,智能体可以协调多个工具。但风险同步放大:供应商锁定、模型漂移、数据泄露、组织能力空心化。架构上应保留可替换性,数据主权不能外包,关键模型要有可解释输出和人工接管开关。
说到底,智能化升级方案的终点不是无人化,而是可恢复、可审计、可演进。系统会出错,问题在于出错后能否快速定位、回退、修复。把升级当作持续运维,而不是一次性验收,很多隐性成本才会提前显形。