科研成果转化率上不去?聊聊数字化转型路径里最脏最累的活
先别买中台。科研数据这关,先过
先撂个判断:很多科研院所的数字化转型,败因不是缺钱,也不是缺博士。是缺一个愿意蹲在实验室里,跟仪器、协议、Excel表死磕的人。听起来不高级?对。可这活最要命。
我见过一个材料实验室,花了三百多万买自动化平台。结果数据导不出来。工程师说接口不开放。学生说手动抄。PI说先发论文。三年后,平台吃灰,售后都换了两拨。
科研成果要变成生产力,第一步不是模型,是把实验记录、仪器日志、样品编码、测试图谱这些“脏数据”接进来。接不进来,AI4S就是空中楼阁。行业里这两年热炒科学智能,AlphaFold、材料基因组、机器人化学家,听着很燃。可底层还是那句话:数据不通,一切白搭。
 高校科研实验室仪器数据自动采集与LIMS对接场景图
怎么接?别一上来就搞大一统。先做最小闭环:选一台高频仪器,打通协议,自动落库,生成电子实验记录。OPC UA、Modbus、RS232、厂商API,能用的都用。实在不行,RPA加人工校验。土,但有效。
数字化转型路径,别照抄互联网那套
互联网公司讲中台、讲敏捷、讲增长黑客。科研呢?课题周期长,数据异构,合规还严。GLP、GMP、数据完整性、审计追踪,一个都躲不开。照抄,会死得很难看。
我偏见的路径是:仪器互联→数据标准化→语义化标注→研发过程数字化→AI辅助假设→自动化实验闭环→成果转化数字档案。七步。每一步都可以单独见效,别等大平台上线才动。
标准化是苦活。样品ID怎么编?单位怎么统一?阴性结果存不存?元数据填哪些字段?这些事没人爱干。可它们决定了你后面能不能做跨课题检索,能不能训练模型。FAIR原则喊了这么多年,真正做到的实验室,少。说实话,太少。
语义化更麻烦。一个“温度”,有人写℃。有人写C。有人写摄氏度。还有人写“室温”。机器看了想报警。得建本体、做映射、上知识图谱。不然,大模型再强,也会被垃圾数据带沟里。
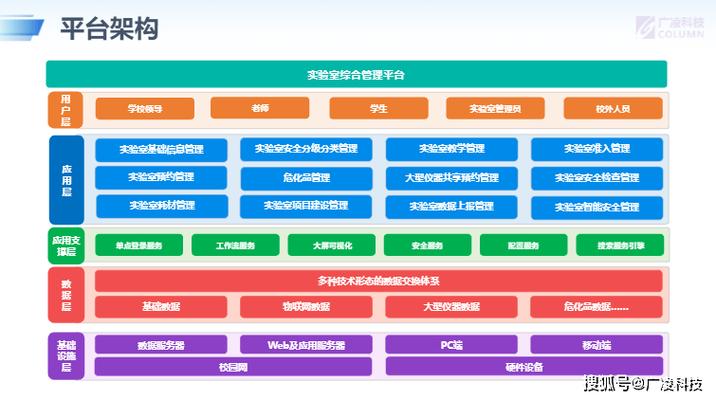 材料基因组高通量实验数据闭环数字化平台架构图
不过话说回来,也别把知识图谱当万能药。小团队先别碰。几十个人的实验室,把ELN和LIMS用明白,比啥都强。
真正拉开差距的,是“自动化闭环”
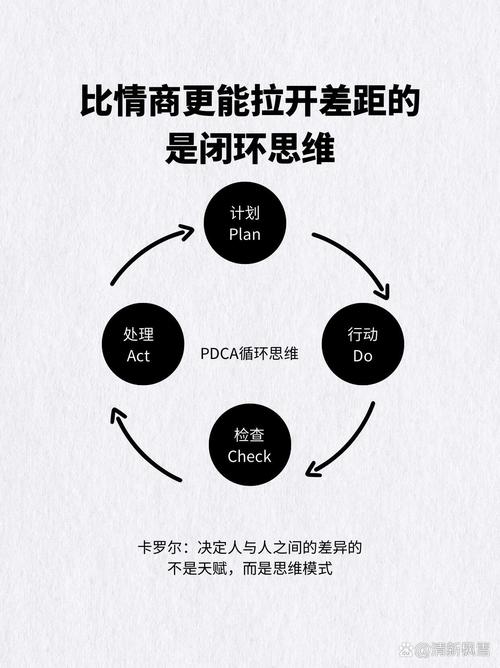 真正拉开差距的,是“自动化闭环”
科研成果的数字化,终点不是报表。是让实验自己跑起来。设计-合成-测试-分析,一轮一轮。人只负责定目标、审异常。这个方向,行业里叫自驱动实验室,或者机器人化学家。听着科幻?已经有不少案例了。
关键在于主动学习+贝叶斯优化。模型提出下一批候选实验,机器平台执行,结果回流,模型更新。循环越快,发现越早。某类催化材料、电池配方、药物晶型,尤其吃这套。
但它有前提。数据质量得稳。实验重复性得高。否则模型学的是噪声,不是规律。烧钱,烧时间,烧博士生。哎,这坑我见过太多次。
还有一个常被忽略的点:科研成果转化需要数字档案贯穿全程。从立项、实验、专利、中试到融资,每个节点留痕。投资人问数据,你拿不出。企业问工艺窗口,你找不到。技术经理人再厉害,也变不出证据。
组织不动,数字化就是IT部门的独角戏
系统好买,流程难改。PI关心论文,学生关心毕业,工程师关心稳定,转化处关心KPI。谁关心数据标准?没人。所以得设一个角色:数据管家。不是CTO,也不是图书管理员。是懂科研、懂数据、能协调的人。
机制上,把数据贡献纳入考核。哪怕只占5%。不然,没人愿意多填一个字段。再搞内部数据接口人,每个课题组一个。定期对齐。别开会念PPT,直接看脏数据案例。哪张表又断了,哪个仪器又离线了。现场解决。
行业动态也在推。国家数据局推动“数据要素×科技创新”,多地建科学数据中心、概念验证中心、中试平台。政策有风,但风不会替你填元数据。对吧?
最后说句掏心窝子的:数字化转型路径没有标准答案。有人从LIMS切入,有人从知识图谱切入,有人直接从自动化平台切入。都可以。但别自欺欺人。如果数据还在Excel里流浪,如果样品ID还有三种写法,如果阴性结果被扔进垃圾桶——那所谓的转型,只是买了几块屏。
先干脏活。再谈智能。