DevOps实践的边界条件:当流水线自动化无法解释交付结果
某团队季度复盘,部署频率从每周一次升至每日四次,变更失败率没有下降,平均恢复时间从48分钟变成51分钟。问题不在流水线。或者说,不只在流水线。
部署频率的迷信与它的反例
DORA四项指标常被当作DevOps实践的仪表盘。可它们描述结果,不提供因果。把部署频率单拎出来,容易变成目标。工程组织会优化这个数字:拆分提交、空变更、预发布环境反复触发。于是流水线绿灯,生产稳定性没有变化。反例:一个交易系统,每次发布都是极小改动,但数据库schema迁移必须停机。部署频率提高,恢复时间不变,因为回滚路径被DDL锁死。条件缺失时,自动化只加速了不可逆动作的发生频率。
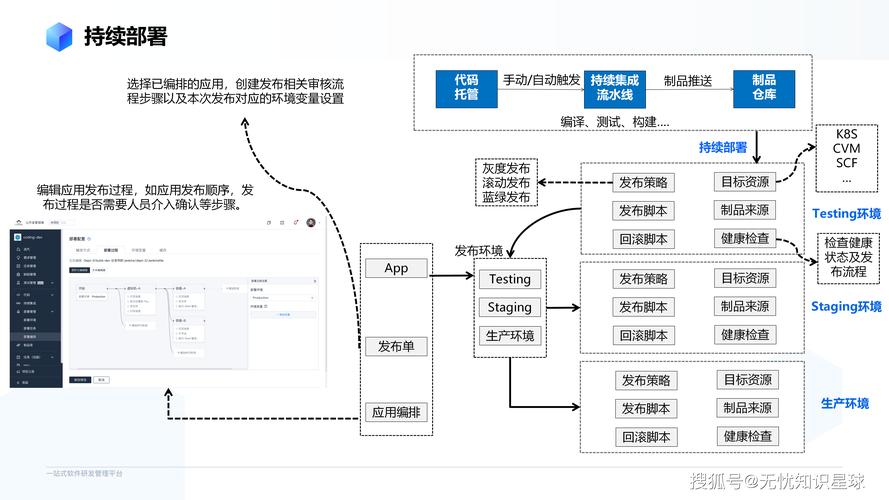 DevOps持续交付流水线代码提交到生产部署阶段示意图
再看变更前置时间。它从提交到生产,但很多组织把需求澄清、架构评审、安全审批排除在外。度量口径变窄,数字变好,交付周期没有变。这不是工具问题。是价值流边界被切坏了。
流水线不是反馈回路
CI/CD擅长重复执行确定性步骤:编译、单元测试、制品签名、部署。它不擅长回答“这个变更对用户是否安全”。后者依赖可观测性、灰度策略、实验设计和on-call反馈。把流水线当反馈回路,会产生一种幻觉:测试通过等于风险可控。测试通过只说明已知断言未被违反。未知未知仍然存在。
可观测性需要三类信号关联:指标、日志、链路。单看CPU或错误率不足以定位发布引起的问题。发布事件必须进入同一时间轴。否则事故复盘只能靠猜。没有发布事件关联的可观测性,在故障中接近噪声。
 可观测性链路追踪与指标日志关联面板示意图
另一个常见错配:把SRE的error budget当作发布闸门,却没有明确服务等级目标。预算耗尽后停止发布,看似理性,实际可能惩罚了正确变更。条件:SLO必须覆盖用户关键路径,且由服务所有者维护。否则它会退化成审批借口。
平台工程能替代什么,不能替代什么
平台工程试图把基础设施能力做成产品:自助环境、黄金路径、策略即代码。它能降低认知负荷。它不能替代责任归属。平台团队提供Kubernetes集群、流水线模板、密钥管理。应用团队仍然要定义SLO、容量模型、数据保留策略。把平台当外包,故障时会出现责任真空。
IaC也是如此。Terraform或Pulumi管理声明式状态,但漂移检测和权限边界需要持续维护。IaC的收益来自可审计变更,而非文件数量。如果生产变更仍由控制台完成,代码库只是文档。
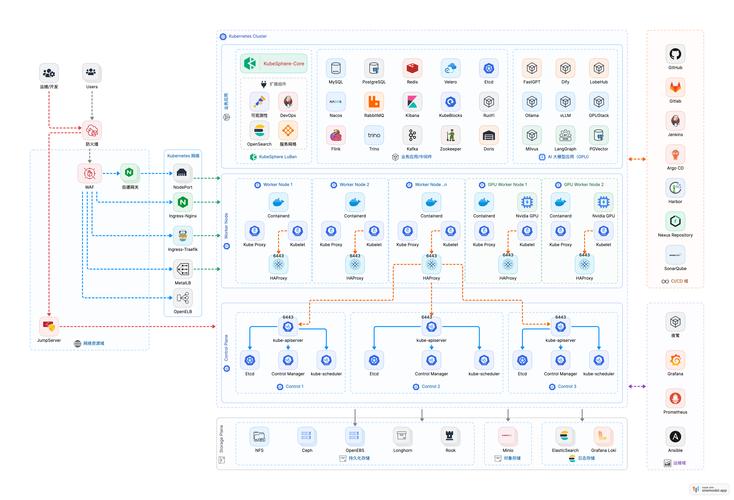 Kubernetes生产环境金丝雀发布流量切换与回滚示意图
金丝雀发布需要流量路由、指标判定、自动回滚三件套。缺少自动回滚,灰度只是延长故障窗口。缺少业务指标,灰度只看延迟和错误率,可能放过资损。条件:回滚必须幂等,数据迁移必须向前兼容。否则版本回退会触发数据不一致。
把度量放回约束条件里
 把度量放回约束条件里
DevOps实践没有统一模板。强监管行业需要审批证据链,遗留单体需要防腐层,外包团队需要接口契约。有效的做法通常从约束识别开始:不可逆变更有哪些,数据一致性边界在哪,故障影响半径多大。然后决定自动化层级。能自动回滚的,提高部署频率;不能自动回滚的,先投资迁移策略和特性开关。
度量也要分层。团队层看前置时间和恢复时间;平台层看环境就绪时间和流水线稳定性;组织层看价值流效率和风险暴露。把不同层指标混在一个看板,会引发局部优化。比如平台团队追求流水线成功率,应用团队被迫减少小批量提交,前置时间反而恶化。
趋势方面,供应链安全正在改变流水线。SBOM、制品签名、SLSA等级要求构建过程可验证。这会增加复杂度,但也把“谁构建了什么”变成可追溯事实。另一个方向是eBPF与OpenTelemetry降低观测成本,但采样策略和基数控制仍是工程问题。工具越强,治理边界越需要明确。
风险在于把DevOps实践变成合规表演。流水线必须绿,工单必须关,审批必须留痕。真实交付能力没有提升。判断标准可以很朴素:一次生产变更从决定到验证需要多少人、多少等待、多少不可逆操作。数字不会撒谎,但选错数字会。
如果部署频率上升而恢复时间不变,不宜过早庆祝。去看回滚路径、数据迁移和on-call反馈。那才是DevOps实践的承重墙。