技术伦理讨论:我把风控阈值调低0.02,南京那晚的雨就下大了
晚上十一点半,软件大道。雨砸在梧桐叶上,像有人在窗外倒豆子。我盯着屏幕上一行代码:if score > 0.62: reject。旁边产品经理问,能不能把 0.62 调到 0.58?就 0.04。轻飘飘。可我知道,这 0.04 背后,是几百个真实的人——有的会被拒贷,有的会被叫去人工复核。技术伦理讨论,很多时候不是课堂上的电车难题。是一行阈值。
 南京软件大道深夜办公楼加班场景
技术伦理讨论,落到地上就是“谁疼”
 技术伦理讨论,落到地上就是“谁疼”
先别急着上价值。很多技术伦理讨论一开口就是隐私、尊严、人类未来。都对。但在我干活的地方,这些大词得翻译成小问题:模型给谁打分?分数怎么用?被拒的人知不知道?能不能申诉?多久给答复?没人回答,伦理就悬着。
拿信贷风控举例。模型输出一个 0 到 1 的分数,你可以把它理解成“违约概率”。分数越高,风险越大。系统不会自己决定拒谁,它只给分。真正做决定的是阈值。阈值是技术伦理讨论里很值钱的旋钮。 往左拧一点,通过的人变多,坏账可能变多。往右拧一点,坏账少,但有人会被错杀。
模型不坏,它只是太听话
有人觉得算法歧视是因为工程师写了坏代码。真不是。大多数时候,模型只是在复制历史。历史数据里,某类人过去被拒得多,违约记录显得高;或者他们更少用某些信用产品,数据就少。数据少,分数就不稳。分数不稳,阈值一卡,他们就更容易掉出去。
模型不会自己知道什么叫公平。 它只会优化你给的损失函数。你告诉它“坏账损失大”,它就宁可错杀。你告诉它“用户体验重要”,它就可能放进来更多风险。这里没有道德自觉,只有目标函数。
更麻烦的是,假阳性和假阴性不是同一拨人在扛。 假阳性,是把好人误判成坏人。假阴性,是把坏人放过去。前者可能是一个急着交房租的年轻人,后者可能是公司账上的窟窿。技术伦理讨论如果只看整体准确率,就像看一锅汤的盐度,却不管有人碗里全是盐,有人碗里没味道。
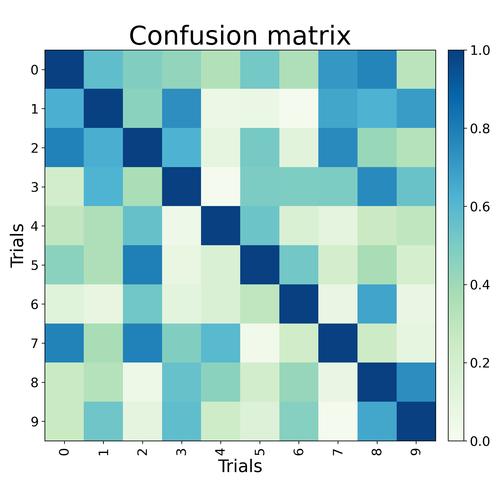 机器学习风控模型阈值混淆矩阵示意图
公平有很多张脸,它们在打架
有人会说,让通过率在各群体一样,不就行了?这叫人口统计均等。听起来很对。但如果某个群体违约率确实高呢?你强行拉平,可能让未来违约更多,公司撑不住,到头来大家都没贷款。另一种思路:机会均等,真正能还钱的人,不管属于哪个群体,都该通过。还有预测均等,分数代表的风险要准。
麻烦来了。这些公平指标,在数学上经常没法同时满足。不是工程师偷懒。是约束打架。你想保护这个群体,就可能让另一个群体承担更多成本。你想让分数准,就可能让通过率差距继续存在。技术伦理讨论不能只有“要公平”三个字。 得追问:我们优先保护谁?愿意牺牲多少效率?谁来拍板?拍板的人懂不懂模型?不懂也行,但要能听懂代价。
上线之后,伦理才开始真的疼
 上线之后,伦理才开始真的疼
评审会开完,PPT 很漂亮。然后呢?流量进来,分布漂移,昨天合理的阈值,今天可能变成筛子。欺诈团伙换策略,用户行为变,政策、季节、疫情,都能把模型搞偏。技术伦理讨论如果只在上线前发生,那叫仪式。上线后的监控、申诉、回滚,才是伦理的日常。
我们后来加了三件事。一是分层监控:不只看整体通过率,还看各年龄、地区、职业的通过率差异。二是申诉通道:被拒的人可以补充材料,人工复核。三是阈值变更日志:谁改的,为什么改,影响哪批人。别小看日志,出事时它是救命的。没有日志,你说不清,说不清就没人信。
还有一点,别把复核岗当摆设。给复核员时间,给他们看原始材料,给他们否决模型的权限。如果他们的 KPI 是“处理速度”,那申诉通道就会变成橡皮图章。快,不等于对。
别把伦理外包给“道德模块”
常见误解之一:给 AI 装个道德开关。没有这种东西。道德不是插件。它是目标函数、数据、阈值、流程、权限、激励的组合。你给团队定 KPI 是“坏账率降 0.5%”,那阈值自然往严里走。你定“投诉率降 20%”,那可能往松里走。技术伦理讨论,到头来会撞上组织伦理。
误区二:伦理等于合规。合规是底线,不是天花板。法律没写的地方,用户已经在承受代价。误区三:工程师能搞定一切。搞不定。工程师能看见指标,看不见全部社会后果。需要产品、法务、运营、外部专家,甚至用户代表。
误区四:技术中立。代码不中立。选择用什么特征,就是选择看什么世界。用“邮编”预测信用,可能是在用种族和阶层的影子。用“停留时长”推荐内容,可能是在奖励愤怒。不是代码有恶意,是优化目标太窄。
说点能落地的笨办法
 说点能落地的笨办法
我自己的做法很土:把技术伦理讨论塞进需求评审,而不是等上线前补材料。每个模型卡要求写四句话:决策是什么;谁可能被误伤;误伤后怎么申诉;多久回滚一次。 不写,就不排期。很粗暴,但有效。
另外,留一个“伦理预算”。别笑。调阈值、人工复核、申诉处理,都要钱。你预算为零,伦理就是口号。给复核团队排班,给他们权限,给他们反馈闭环。
还有,把指标拆开看。整体准确率 99% 很漂亮。但如果某个小群体准确率只有 80%,整体数字就是遮羞布。看混淆矩阵,看分组,看尾部。尾部的疼,才是真疼。
那天晚上,阈值还是从 0.62 调到了 0.60。没调 0.58。产品经理骂骂咧咧。我请他吃了碗鸭血粉丝。他问我,差 0.02 能有多大区别。我说,可能几十个人不用打客服电话,也可能多几个坏账。我们选了前者少一点,后者多一点。没有完美答案。技术伦理讨论,本来就不是找标准答案。它是在没有标准答案的地方,留下记录,留下申诉,留下改错的机会。
南京的雨停了。软件大道的路灯把水洼照得发亮。我关电脑时想,伦理这东西,可能不是让机器变成好人。是让我们这些做机器的人,别太容易睡着。