混沌工程不是玄学:从杀Pod到可控实验的硬核真相
凌晨两点,值班群里有人甩了一张图:核心交易链路P99飙到3秒。第一反应是回滚。第二反应,谁又在生产环境跑混沌实验?先别急着骂。混沌工程这事,干得好是疫苗,干不好就是投毒。真的。
先别把混沌工程当成随机破坏
很多团队第一次接触混沌工程,脑子里就三个字:杀Pod。真事。我在几个云原生团队见过,脚本一跑,随机挑一个Pod删掉,然后盯着监控看五分钟。没炸,鼓掌。炸了,骂娘。这不叫混沌工程,这叫手滑。
稳态假设才是起点。你得先定义什么是正常:错误率低于多少、P99低于多少、订单成功率高于多少。没有这个基线,故障注入就是往黑箱里扔石头,听个响。混沌工程的核心不是制造故障,是用可控实验验证系统韧性。实验有假设、有变量、有观测、有结论。对吧?
再说爆炸半径。这个词听着像炸弹,其实更像安全绳。生产环境实验,先从1%流量开始,从非核心链路开始,从只读副本开始。最小权限、熔断开关、自动回滚,一个都不能少。我见过最离谱的配置,实验范围直接选了整个命名空间,结果把支付回调也卷进去了。冷汗。真的冷汗。
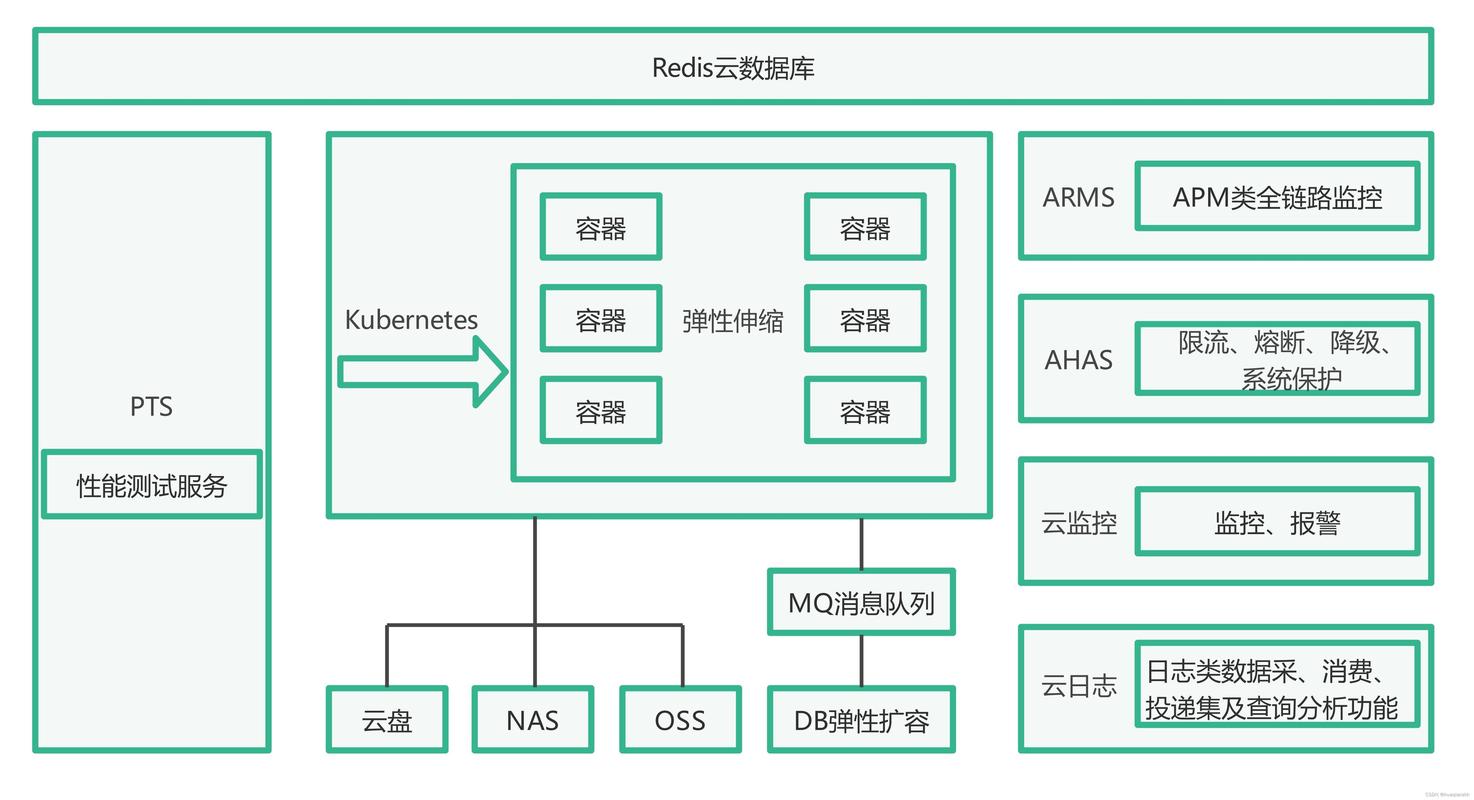 云原生Kubernetes混沌工程故障注入实验架构图
所以别一上来就搞生产全链路。先在预发环境跑通实验剧本,再把爆炸半径切成小片。实验不是越猛越好,是可解释、可复现、可回滚。这三条比杀一万个Pod都值钱。
科研成果在解决什么:从故障注入到因果推断
学术圈这几年没闲着。早年的混沌工程偏工程实践,Netflix的Chaos Monkey算开山怪。后来论文开始补理论:故障注入模型、实验设计、安全护栏、自动化编排。说白了,大家想让混沌实验从经验驱动变成证据驱动。
一个有意思的方向是因果推断。系统出故障时,指标一片红,相关性满天飞,但到底哪个是根因?混沌实验可以当干预手段:控制变量,注入特定故障,观察因果效应。比单纯看监控曲线靠谱。另一个方向是贝叶斯优化和强化学习,用来搜索最有可能击穿系统的故障组合。人工枚举太慢,机器自己找。当然,前提是安全护栏够硬,不然优化器能把系统优化没。
可观测性也在升级。传统三支柱——日志、指标、链路——够用吗?高并发下不够。eBPF这类低开销采集,服务网格里的故障注入,Kubernetes原生的CRD编排,让实验粒度细到单个请求。科研和工业的边界在这块越来越模糊。好事。
 生产环境混沌实验爆炸半径与SLO护栏示意图
不过话说回来,论文里的漂亮模型落到企业里,第一关不是算法,是组织。谁批准实验?谁值班?炸了算谁的?这问题不解决,再好的因果推断也白搭。
工具链和行业动态:别只盯着杀Pod
工具这块,Chaos Mesh、LitmusChaos、AWS Fault Injection Simulator、Gremlin、Azure Chaos Studio,各有各的活法。Kubernetes原生生态里,Chaos Mesh和Litmus用得挺多,CRD一写,实验剧本能版本化。云厂商的托管服务省心,但爆炸半径和权限模型得看清楚。别把生产账号直接给实验平台,真的。
行业动态也明显:混沌工程正在往平台工程里塞。以前是SRE小分队手工跑脚本,现在是把实验能力做成内部开发者平台的一个按钮。开发提交代码,流水线自动跑一轮小爆炸半径实验,失败了就拦。这叫左移。听着挺美,落地时最怕没有SLO基线和没有回滚预案。没有这两样,自动化就是自动闯祸。
还有安全合规。金融、电信这些行业,生产实验不是不能做,是要有审批、有审计、有隔离。最小权限原则不是口号。实验平台能删Pod,不代表它能删数据库。权限切细,审计留痕,否则出事连锅都找不到。
落地时最容易踩的坑
第一个坑,把混沌工程当测试。测试找bug,混沌实验验证韧性。两码事。第二个坑,只做单点故障。现实里的故障是连锁的:网络抖动导致超时,超时导致重试风暴,重试风暴打垮数据库。单点实验测不出来。依赖关系图得先画清楚。
第三个坑,忽略组织文化。实验失败被当成事故追责,下次没人敢提假设。混沌工程需要无责复盘,需要把实验当学习,不是当考核。第四个坑,没有观测。实验跑完,指标没对齐,结论全靠猜。这不叫实验,叫抽奖。
我个人的建议?先从一个非核心服务开始,写清楚稳态假设,设好爆炸半径,配好自动回滚,跑一次。把实验报告留下来。然后再谈平台化。别急着买工具,先想清楚你要验证什么。工具是放大器,不是脑子。
先写到这里。值班群又响了。这次不是混沌实验,是真实的网络抖动。你看,现实从不缺故障,缺的是可控的实验。