隐私计算:当安全假设撞上工程现实
去年冬天,某省政务数据平台牵头做中小微企业信贷风控试点。银行想把税务、社保数据拿进来,但数据不出域。隐私计算被写进方案,预算批了,供应商也选了。半年后,系统还在POC阶段。不是算法跑不通,而是业务方问了一个问题:如果参与方在计算过程中偷偷篡改输入,你凭什么保证结果可信? 这个问题把很多人问住了。
对。就是这个问题。隐私计算的核心承诺是“数据可用不可见”,但工程上这个承诺有前提。前提没写清楚,承诺就是一张空头支票。
技术路线不是选择题,是约束条件
市面上常把多方安全计算、联邦学习、可信执行环境、差分隐私并列成几条技术路线。这种分法在科普文章里没问题,在工程方案里会误导人。它们解决的不是同一层问题。
多方安全计算(MPC)用密码学协议把计算拆成碎片,参与方各自算一部分,谁都不看到原始数据。听起来很美。代价是通信开销。两方百万级样本的联合统计,MPC可能跑几个小时。三方以上更复杂。联邦学习更像一个分布式训练框架,它不保证中间梯度不泄露。差分隐私是在查询结果里加噪声,隐私预算 ε 越小,噪声越大,模型精度越差。可信执行环境(TEE)把计算放进硬件隔离区,性能接近明文,但信任边界从算法转移到了芯片厂商。
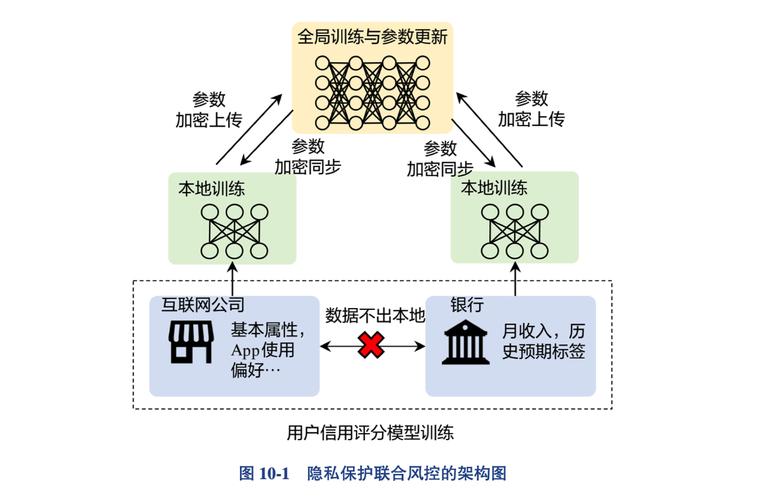 银行与政务数据联合风控隐私计算架构图
所以选型时先问的不是“哪个技术更强”,而是“我的安全假设是什么”。参与方是半诚实还是恶意?网络是同步还是异步?数据规模多大?延迟要求多少?这些条件决定了技术组合。没有一种路线能同时满足所有条件。
半诚实模型是个温柔的假设
 半诚实模型是个温柔的假设
很多商用隐私计算方案默认半诚实模型。意思是参与方会按协议执行,但会尝试从收到的中间结果推断别人的原始数据。这个假设在学术论文里很常见,在商业合同里很危险。
现实中的参与方有动机作恶。比如联合风控里,一方可能想虚报自己的客户质量,或者故意构造输入来反推对方数据分布。半诚实模型不防这些。恶意模型能防,但性能下降不是一点半点。恶意模型下的MPC协议通常比半诚实模型慢几个数量级,通信轮数也更多。对实时业务来说,基本不可用。
那怎么办?把安全假设写进合同,而不是藏在技术白皮书里。 如果方案只防半诚实攻击,就明确告诉业务方:输入真实性需要靠数据审计和业务规则保证,隐私计算只解决计算过程中的信息泄露。这不是甩锅,是工程诚实。
还有一个容易被忽略的点:TEE的信任边界。TEE依赖硬件厂商的根信任。侧信道攻击、固件漏洞、供应链污染,这些风险不在密码学协议的安全证明里。用TEE做隐私计算,等于把一部分信任从参与方转移到了芯片厂商。这个转移是否可接受,取决于场景。金融行业对硬件信任的接受度,和医疗行业不一样。
性能账本:别拿实时风控硬套MPC
说个具体的。某银行想做信用卡实时反欺诈,要求单笔决策延迟低于100毫秒。合作方是运营商,提供号码风险标签。这个场景用MPC做隐私求交,理论上可行,工程上不划算。隐私求交的通信开销和集合大小相关,百万级号码的PSI,跨公网跑一次可能要几秒到几十秒。实时风控等不了。
不是技术不行,是场景错配。隐私计算适合离线批量、对延迟不敏感、数据量可控的协作。 比如联合建模、联合统计、批量黑名单匹配。实时性要求高的场景,TEE或者“数据不出域但集中计算”的沙箱模式更现实。沙箱模式也有问题:集中计算意味着数据在物理上汇聚,只是逻辑隔离。合规上是否算“出域”,各地监管口径不一样。
 隐私计算医疗数据联合建模合规边界示意图
差分隐私的账本更微妙。加噪声会损失精度,精度损失又会影响业务效果。隐私预算 ε 的取值没有通用标准。一个在论文里看起来合理的 ε,放到信贷审批里可能直接让通过率掉几个百分点。业务方不会接受“为了隐私牺牲效果”这种笼统说法,他们要看具体的ROC曲线变化。所以差分隐私落地时,隐私预算必须和业务指标一起调,不能由技术团队单方面定。
有些场景,隐私计算不该出场
 有些场景,隐私计算不该出场
反例摆在那里。单一机构内部数据,本来就不出域,不需要隐私计算。有些项目为了“技术先进性”硬套联邦学习,结果增加了系统复杂度和运维成本,收益为零。
另一个反例:参与方之间没有信任基础,且输入数据本身不可信。隐私计算保护的是计算过程中的数据隐私,不保护输入的真实性。如果一方故意输入假数据,MPC协议会忠实地算出错误结果。这种场景需要的是数据审计、可信接入和博弈机制,不是密码学。
还有数据量极小的场景。几万条记录的联合统计,MPC的通信开销可能比直接脱敏共享还大。工程上要算总账,不能只看安全属性。
不过话说回来,隐私计算的价值恰恰在那些“不该共享原始数据但又必须联合计算”的灰色地带。比如跨机构的反洗钱、跨区域的医疗研究、供应链金融里的多方对账。这些场景的共同点是:数据敏感,协作必要,监管关注。隐私计算提供了一种技术上的“可验证的克制”。但克制到什么程度,需要和合规、业务一起定边界。
趋势与风险:工具越热,越要问信任从哪来
 趋势与风险:工具越热,越要问信任从哪来
趋势层面,互联互通是明确方向。不同厂商的隐私计算平台之间要能互相通信,否则每个合作方都装了不同平台,协议不兼容,协作成本极高。标准化组织在推互联互通规范,但落地进度取决于厂商意愿。性能优化也在继续,硬件加速、协议剪枝、异步通信,这些工程改进让MPC的可用性在提升。
风险同样明显。合规套利这条路最隐蔽。有些方案把“用了隐私计算”当成合规免责牌,忽略了数据来源合法性、授权范围、出境限制等更根本的问题。安全假设被忽略则是另一重风险。销售材料里写“全程加密”,技术文档里写“半诚实模型”,两者之间的差距可能就是风险敞口。厂商锁定也值得警惕。隐私计算平台的技术栈差异大,迁移成本高,一旦选型失误,后续替换很麻烦。
回到开头那个问题:如果参与方篡改输入,隐私计算能保证结果可信吗?不能。它保证的是计算过程中不泄露原始数据,不保证输入真实。这个区分很重要。隐私计算解决的是“计算中的信任”,不是“数据本身的信任”。 把后者也压给隐私计算,技术会被压垮。
所以下次有人跟你说“上了隐私计算就安全了”,你可以反问一句:安全假设是什么?恶意模型还是半诚实模型?性能损耗多少?输入真实性靠什么保证?这几个问题答不上来,方案大概率还停留在PPT阶段。