自然语言处理里的“理解”难题:从词向量到生成式模型的一条暗线
流畅输出背后的概率账本
一个系统能续写合同、解释代码、模仿客服口吻,仍可能在否定范围上出错。这不是段子,是自然语言处理工程里反复出现的裂缝。流畅输出与语义可靠之间,隔着概率建模、数据分布和评测设计。得把“会生成”与“懂关系”分开看。
自然语言处理的核心长期是把语言对象映射为可计算表示。词袋、n-gram、词向量、上下文编码器、生成式Transformer,路径不同,共同点是把离散符号转成向量或分布,再用目标函数约束。词向量时代,语义相似性通过共现统计获得;上下文模型让同一个词在不同句子里有不同表示。问题在于,
概率高并不等于语义真。模型学到的是训练语料中条件分布的近似,遇到否定、指代、量词辖域、反事实,容易把表面搭配当成逻辑关系。举例,“不是所有A都B”和“所有A都不B”在字面共现上接近,逻辑差异却大。生成式模型用自回归分解联合概率,逐词采样,局部合理可能累积成整体漂移。温度、top-p等解码参数改变输出分布,工程上常被当作“调风格”,实际会改变事实一致性。这里没有魔法,只有目标函数与数据偏置的交换。模型越流畅,人越容易放松审查,这事挺拧巴。需要强约束:检索增强、结构化约束、可验证中间表示、后置校验。它们不是装饰,是边界条件。
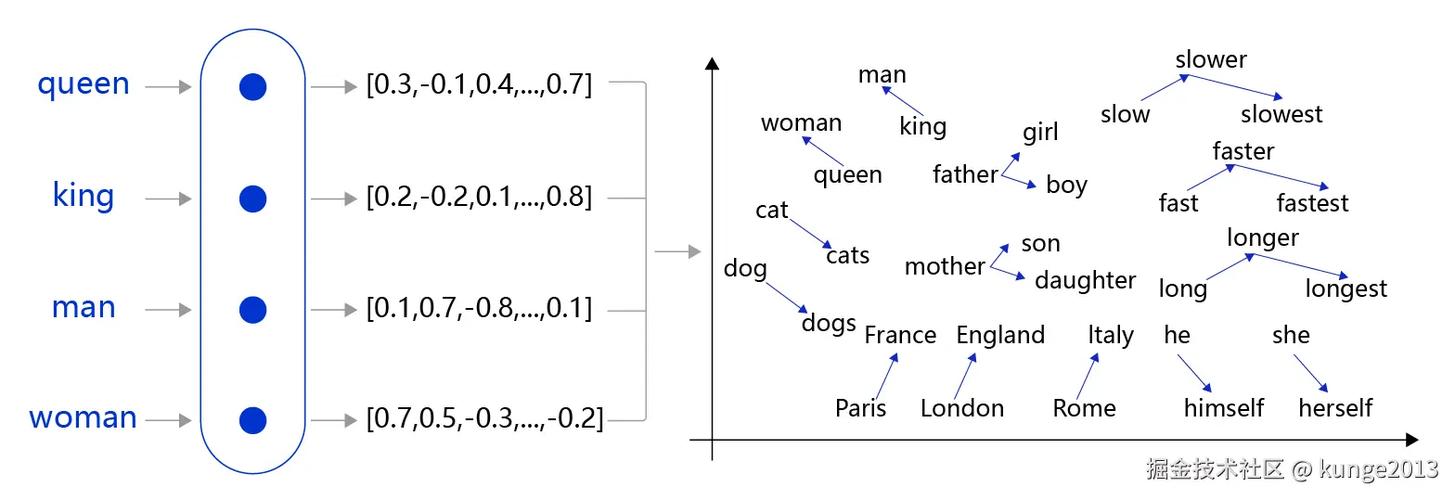
自然语言处理词向量空间语义聚类示意图
评测像一把有刻度的软尺
评测困境也绕不开。自然语言处理评测从准确率、F1到BLEU、ROUGE,再到人工偏好与基准题库。每个指标都在问一个窄问题。BLEU看n-gram重叠,不保证事实;人工偏好看整体可读性,受提示词和评委偏见影响;基准题库可能泄漏进训练语料。于是出现“榜上好看,线上翻车”。
评测不是裁判,是抽样协议。要说明抽样总体、提示模板、解码参数、拒答策略、错误类型分布。否则数字不可比。生成任务尤其需要分层:事实性、指令遵循、推理链一致性、安全性、鲁棒性。分层不是堆指标,是让失败模式可见。反例:一个模型在开放问答上准确率提升,可能只是更敢猜;拒答率下降会被误读为能力上升。工程团队应保留小规模高危集:否定句、多实体指代、数字单位、时间约束、权限边界。用混淆矩阵看误报漏报,比单一分数有用。
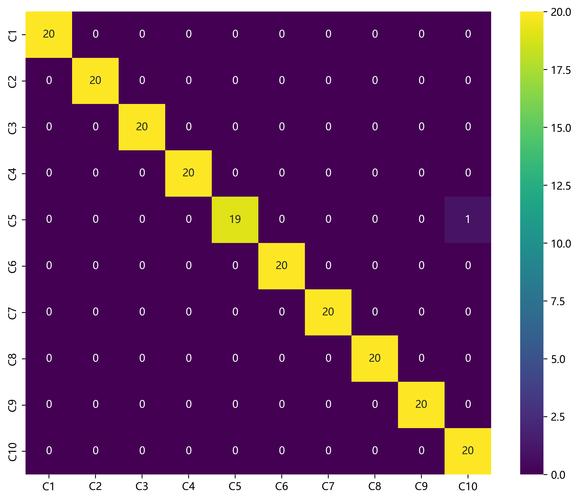
自然语言处理模型评测混淆矩阵与错误类型分布图
工程边界不在模型里

工程边界不在模型里
系统落地时,真正难缠的是接口与责任。输入来自用户,含错别字、方言、隐含意图;输出进入业务,可能触发退款、医疗建议、合同义务。模型只能给概率建议,业务规则要兜底。需要把任务拆成可验证子问题:意图分类、槽位抽取、检索、重排、生成、校验。每层有失败模式。分类器在长尾意图上弱;抽取器对嵌套实体和否定修饰敏感;检索器受切分与索引影响;生成器会补全不存在的信息。工程路径不是把大模型塞进所有环节,而是
让可验证环节承担硬约束,让生成环节承担表达。风险包括提示注入、数据污染、隐私泄漏、版权争议、偏见放大。边界条件也很实在:高风险场景需要人审与日志;低风险场景可用自动校验与灰度。趋势上,小模型蒸馏、工具调用、结构化输出、检索增强会继续分担压力。但别把“会调用工具”当成“理解工具”。有些演示很漂亮,一接真实工单就露馅。对吧。
语义的暗线还在延伸
语义的暗线还在延伸
自然语言处理的进展常被描述为规模定律,但规模不是唯一变量。数据质量、任务分解、评测设计、部署约束共同决定可用性。语义理解不是单点突破,而是表示、推理、验证三者之间的耦合。未来更可能出现混合系统:神经模型处理模糊匹配,符号规则处理硬逻辑,检索系统提供可追溯证据,人类审核处理剩余不确定性。这个方向不新,却更接近工程现实。要警惕一种偷懒叙事:把流畅当智能,把偏好当真理。语言是社会的,语料带立场,模型输出会放大这些立场。研究者需要报告数据来源与过滤策略,工程师需要记录失败案例,产品需要给用户可纠正的入口。否则系统越顺滑,纠错越困难。自然语言处理的热闹在生成,难点仍在约束。