98分的模型上线就翻车:深度学习技术落地时容易被忽略的那道沟
去年冬天,我在苏州一家做精密零件的厂里蹲了三天。产线班长指着屏幕骂:你们这个AI眼睛是不是散光?那个划痕明明在,它说没有;那个反光它非要标成裂纹。我当时还挺得意——模型在实验室测试集上准确率98.6%。结果呢?上线头一周,误检率飙到17%。班长差点把显示器给我掀了。
这不是段子。这是深度学习技术从notebook到产线之间那条暗沟。很多人以为模型训练完、指标好看就万事大吉。说实话,那只是拿到了入场券,离真正能用还差着十万八千里。
指标漂亮,不代表模型能打
先问一个反常识的问题:验证集准确率98%,线上表现一定好吗?不一定。甚至可能很糟。
为什么?因为你的验证集和线上数据,往往不是一回事。训练集是你从历史数据里挑出来的,清洗过、标注过、可能还均衡过。线上数据是什么?是用户随手拍的、产线灯光忽明忽暗的、摄像头镜头有灰的、样本分布每天都在变的。深度学习模型不懂“缺陷”这个概念。它只懂像素的统计规律。你把训练集里的划痕都放在左上角,它可能学会“左上角有白线就是缺陷”——这跟缺陷本身没半毛钱关系。这叫捷径学习。也叫特征泄漏。
我见过更离谱的。一个团队做医疗影像分类,训练集里阳性样本都是某台老机器拍的,阴性样本都是新机器拍的。模型学到的不是病灶,是机器型号的噪声指纹。离线测试AUC高得吓人。换家医院一跑,直接崩。你说这怪模型吗?它只是个老实孩子,你喂它什么它学什么。
 深度学习模型训练集与线上数据分布漂移对比示意图
上线那天,数据先给你一闷棍
回到那个零件厂。训练数据来自A产线,白天班,固定光源。上线到B产线,夜班,灯管老化,图像整体偏黄。模型把反光当成划痕。误检。还有数据管道的问题:训练时用离线特征,线上特征计算有延迟,导致同一个特征值差了一截。模型没变,输入变了。输出自然离谱。
我后来总结,深度学习技术落地很容易踩的坑,不是网络结构不够深,也不是GPU不够多,而是训练环境和线上环境的数据分布不一致。这个词听着学术,说白了就是:你在温室里养的花,突然扔到菜市场,风吹日晒,能一样吗?
再说一个推荐系统的例子。离线AUC 0.86,看起来挺美。上线后点击率反而跌了。为什么?因为训练用的曝光日志本身有位置偏差——排在前面的物品天然被点击得多。模型学的是“位置靠前=用户喜欢”,而不是“用户真的喜欢”。上线后排序策略一换,反馈回路变了,模型直接懵。这叫反馈回路偏差。你越用它的预测去决定展示什么,它就越只看到自己想看的东西。死循环。
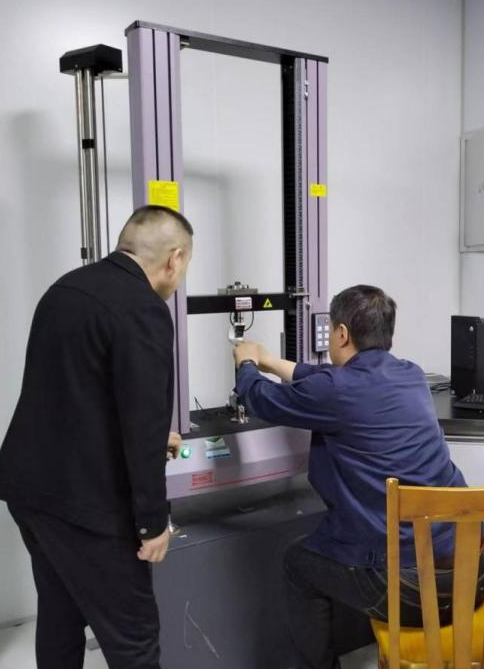 工业质检产线深度学习模型误检案例现场照片
模型不是唯一背锅的
 模型不是唯一背锅的
出了事,大家下意识反应是模型不行。但说实话,很多锅不在模型身上。工程链路里能出问题的地方太多了:预处理代码训练和线上不一致、特征版本没对齐、服务超时触发降级、监控面板没人看。我见过一个模型,精度98%,推理延迟200毫秒。业务等不了,直接降级到规则引擎。效果当然崩。你说是模型的问题吗?不是。是系统设计没把延迟当回事。
还有更隐蔽的:模型静默失效。上线之后,数据分布慢慢漂移,模型准确率从98%掉到70%,但没人知道。因为没人监控输入分布,也没人回捞bad case。模型就像半夜里悄悄死掉的哨兵。第二天大家还在用它的预测做决策。这挺吓人的,对吧?
所以我现在做深度学习技术落地,一定会先问三个问题:线上输入分布怎么监控?低置信度样本怎么处理?人工兜底的成本是多少?置信度校准比单纯追求准确率重要得多。模型说自己90%确定,实际可能只有60%。你把阈值设太高,漏检;设太低,误检。得用业务成本来算。漏检一个缺陷赔多少钱,误检一个良品浪费多少工时。这些账算清楚,阈值才有意义。
我后来怎么补窟窿
说回那个零件厂。后来我们没换模型。真的,网络结构没动。做了几件事:加了数据分布监控,每天对比线上和训练集的均值方差,漂移超过阈值就报警;把低置信度样本自动转人工复核,不硬撑;做了影子模式——新模型先不参与决策,只记录预测,跟老模型对比两周;重新梳理标注规范,把“反光”和“划痕”的边界写清楚;土但特别管用:定期把线上bad case回捞,人工标一遍,增量训练。
产线班长后来不骂了。因为系统会在不确定的时候喊人。模型不是替代人。它得知道自己什么时候闭嘴。
不过话说回来,深度学习技术确实厉害。高维感知、复杂模式、图像语音文本,传统方法啃不动的硬骨头,它啃得动。但它不是万能锤子。小样本、强因果、可解释性要求极高、数据分布天天突变的场景,你硬上深度学习,就是给自己找麻烦。有些缺陷检测,传统视觉阈值分割加形态学处理,稳得像老狗。你非要用大模型,参数翻十倍,延迟翻五倍,效果还不一定好。图啥呢?
最后说句掏心窝子的:实验室指标是门票,不是奖杯。别拿验证集上的98分去忽悠业务方。上线才是考试。而且这场考试,考的不只是模型,还有你的数据管道、监控体系、人机协同流程。深度学习技术再强,也强不过一个靠谱的工程闭环。