优化算法应用:别再把调参当玄学,科研和产业都在偷偷换打法
先别急着聊遗传算法、粒子群、贝叶斯优化这些名字。名字一多,容易装。看场景。科研里的黑箱函数,评估一次可能烧掉几小时机时,或者一炉子材料。产业里的排产表,改一行可能牵动整条线。不同场景,算法选型差得很远。对吧?
一、反直觉:优化算法最值钱的地方,常常不是“最优解”
 一、反直觉:优化算法最值钱的地方,常常不是“最优解”
我见过最常见的翻车,是把优化算法当“全局最优保证书”。可现实是,大多数科研和工业问题,连目标函数都写不干净。比如你要同时提高强度、韧性、导电率,还要压低成本。四个目标,互相打架。你拍一个加权和,权重怎么定?拍脑袋。拍完跑出来一个偏科怪物,强度上去了,韧性掉到没法用。然后大家说算法不行。算法冤不冤?冤。
贝叶斯优化为什么在实验科学里火?因为它承认评估很贵。代理模型先拟合一个大概地形,采集函数决定下一步去哪采。EI、UCB这些采集函数,本质上在“探索”和“利用”之间做交易。说白了,别在没希望的地方浪费实验次数,也别过早钻进一个小山包。但注意,代理模型不是算命。数据噪声大、先验乱设,它照样带你跳坑。
二、实验室里的优化算法应用:把“试错”改成“带记忆的试错”
这两年AI for Science很热,自驱动实验室、主动学习、高通量筛选,论文一抓一把。热闹归热闹,真正好用的优化算法应用,往往做了一件很朴素的事:把专家的先验塞进模型,而不是让算法从零瞎摸。比如材料配方,哪些元素不能碰、哪些区间工艺上根本做不到,这些约束不写进去,算法就会给你一堆“理论很美、炉子一烧就炸”的方案。
多目标优化也是。别老盯着单个最优点。帕累托前沿更有意思:你想要更硬还是更韧,自己挑。科研里没有免费午餐。还有多保真优化,低保真仿真先筛一遍,高保真实验再验。省钱,也省时间。吐槽一句:有些论文的收敛曲线漂亮得像P过,现实里可能被一台坏掉的炉子打断。实验记录不完整,失败数据不回流,优化算法应用就是垃圾进、垃圾出。真的。
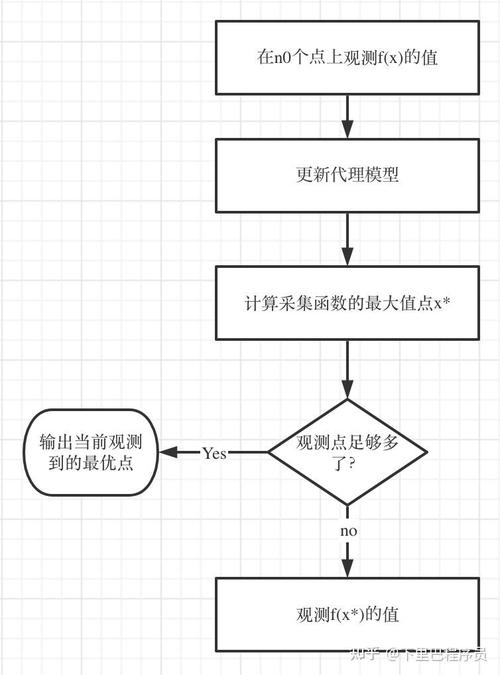 材料实验室贝叶斯优化算法实验流程图
三、产业现场的优化算法应用:约束才是主角,目标函数得靠边站
到了产业现场,味道又变了。约束才是主角,目标函数得靠边站。排产要考虑换型时间、设备能力、订单交期;物流路径要考虑时间窗、载重、司机工时;芯片布局要考虑布线拥塞、时序、功耗。你拿一个玩具目标函数上强化学习,上线后调度员一句“这个单必须优先”,模型直接傻眼。
所以别嫌混合整数规划土。很多场景,CP-SAT、列生成、邻域搜索,比花哨的深度强化学习稳得多。遗传算法也能用,但种群大小、交叉变异、惩罚项,哪个不是坑。更靠谱的路子:先做基线,再上学习型热启动或学习型分支策略。机器学习不是来替代运筹优化的,它是来给搜索树递小抄的。递得好,省时间;递不好,一起迷路。
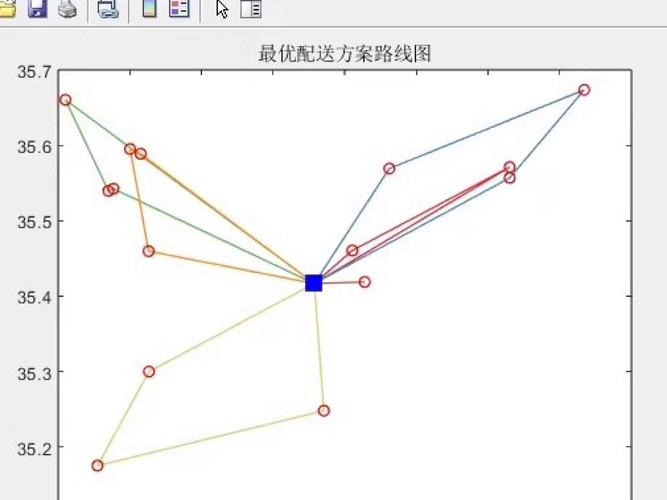 物流配送路径优化算法时间窗约束示意图
四、大模型时代的新麻烦:优化算法应用开始卷“评估成本”
大模型一来,优化算法应用又多了个新战场:调参、提示词搜索、Agent工作流。评估一次要跑benchmark,烧钱。网格搜索?那是真土豪。现在更常见的是贝叶斯优化、CMA-ES、进化策略、Bandit。核心没变:样本效率。每一次评估都得值回票价。
但这里有个暗坑:验证集污染。你优化优化着,分数上去了,上线一测,垮了。不是算法不努力,是评估尺子歪了。还有早停和多保真,别等全量跑完才知道不行。该停就停。心疼算力,也心疼电费。咳。
五、踩坑清单:别急着把算法名写进PPT
说几条我见过的坑。第一,目标函数没定义清楚,先跑起来再说。跑完发现优化的是错的东西。第二,约束漏了,方案不可行。第三,评估噪声大,把噪声当信号。第四,没有基线,不知道算法到底有没有用。第五,在验证集上反复调,过拟合得明明白白。第六,可解释性和落地成本没人管。算法说东,业务说西,最后PPT赢了,系统没上线。
优化算法应用,说到底是“在烂泥里找路”,不是“在PPT上找光”。预算有限,约束一堆,数据还脏。先问清楚评估一次多少钱,再问约束能不能写成硬约束,最后才选算法。顺序反了,神仙难救。别神化,也别一棍子打死。用对了,它真能省下大把实验和真金白银。用错了……那就当交学费吧。