硅光芯片与光互连:堵了十年的算力大门,终于要被推开了?
为啥现在硅光突然就火了?还不是电互连撑不住了
去年跟一个做AI算力的朋友吃饭,他拍着桌子吐槽,再找不到新的互连方案,英伟达再堆核心也没用,发热量能把机房的空调给干跳闸。
你想想现在的情况。大模型参数从亿级跳到了万亿级,单芯片不够用,就用chiplet堆多颗,数据要在核心之间、芯片之间、板卡之间疯狂跑。原来走铜线的电互连,早就到瓶颈了。
频率一上去,铜线里的电信号之间会互相串扰,每走一厘米功率掉一半,跑不到十厘米,传的信号就全成噪声了。能耗还高得离谱,传1比特数据要耗好几纳焦,整个机房一半的电费都给互连耗掉了。
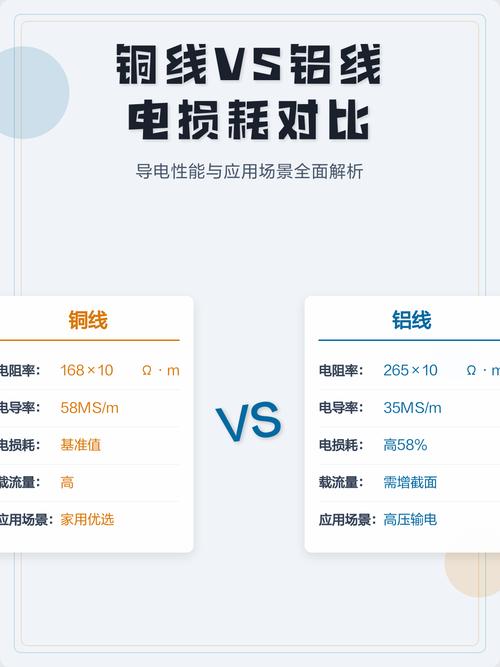 传统CPU电互连铜线损耗对比图
光互连不一样啊。光信号靠不同波长传,几十路信号能挤在一根光波导里跑,互不干扰。损耗不到铜线的十分之一,延迟低,带宽还能往上翻,能耗才是电互连的五分之一都不到。
需求摆在这,摩尔定律走慢了,算力需求每年翻十倍,你说硅光能不火吗?
硅光芯片到底解决了光互连的什么痛点?
其实光互连这个概念,几十年前就提了。为啥直到现在才落地?原来的光互连都是分立器件拼出来的。激光器、调制器、波导、探测器一个一个做,再手工对准粘到一块模块上,体积大,良率低,贵得要死,只能用在数据中心几十公里的长距传输,短距的板上、芯片间互连根本用不起。
硅光芯片不一样。它把所有光器件都集成在一块硅晶圆上,而且能用成熟的CMOS工艺加工。说白了就是能跟着电子芯片一起批量流片,成本一下就打下来了,体积还能做的极小。
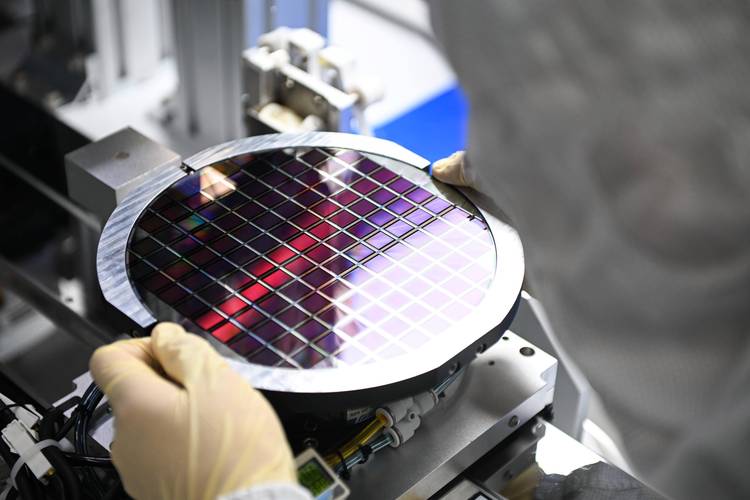 集成硅光芯片晶圆加工实拍图
说实话,这真的是思路上的转过来弯了。原来光就是光,电就是电,现在我把光器件做在硅基上,跟电芯片拼一块,完美解决高速数据传输的问题。
现在可不是PPT概念了。Intel去年已经把1.6T的硅光模块批量用到了谷歌的数据中心,国内华为、长飞也已经有800G硅光模块出货,英伟达下一代GB300的chiplet互连,传闻就是要用硅光方案对吧?
不过话说回来,之前不少炒概念的公司把硅光吹得玄乎,什么颠覆芯片行业,其实就是补了电互连的短板,原来的路走不通了,换条好走的路而已,没那么神。
行业落地还差最后几步?现在走到哪了?
 行业落地还差最后几步?现在走到哪了?
现在硅光已经过了技术验证的阶段,但是大规模普及,还有几个小坎要跨。
最大的问题就是硅基光源。硅本身是间接带隙半导体,发光效率低得可怜,现在主流方案还是把III-V族的激光器键合到硅光芯片上,工艺复杂,良率上不去,成本还是压不到最低。
最近两年其实已经有不少突破了。去年MIT的团队做出来硅基拉曼激光器,外量子效率比原来翻了十几倍,国内浙大、中科院也做出来异质集成的硅光源,良率已经能摸到量产的门槛了,不出五年,这个问题大概率能解决。
m还有一个问题是耦合损耗。光纤的直径是微米级,硅光波导是百纳米级,对接的时候稍微偏一点,损耗就上去了,批量生产的一致性不好做。现在主流的光栅耦合器已经能把单端损耗降到1dB以下,不少厂商已经摸到量产的标准了,这个问题其实已经不算卡脖子了,就是工艺打磨的问题。
今年国内800G硅光模块的出货量已经翻了三倍了,明年1.6T的产品都会批量上,所有做AI算力的厂商都在抢货,为啥?同样的带宽,硅光模块的能耗比传统铜线模块低30%以上,一个一万台服务器的机房,一年下来能省大几百万电费,谁算不动这笔账?
我前几个月去国内一家硅光初创公司的实验室,他们拿给我看一块指甲盖大的硅光芯片,集成了128路光通道,总带宽能做到3.2T,比原来整个板卡的带宽还大。当时看着那个亮晶晶的芯片,真的有点感慨,原来我们喊了十年的“光进铜退”,这次真的进到芯片里面来了。
之前整个行业都在说,算力增长碰到了内存墙、互连墙,墙就是电互连的那点带宽和能耗顶不住了。现在硅光给这堵墙开了个口子,接下来就看谁能把这个口子挖的更大了。
你说再过十年,所有高端算力芯片的互连,都会变成光的吗?我觉得大概率是的。毕竟我们对算力的渴望,没有止境。