小样本学习:大数据时代为何还需要极少数据训出可用模型
去年帮一个做汽车零部件的朋友解决缺陷检测的问题,翻遍了他们的标注库,整个生产线跑了三年,合格的缺陷样本一共才117张。全堆进去训大模型,出来的结果连新员工的肉眼都不如。
这不是个例。
很多垂直领域,从罕见病临床影像到古文物文字识别,再到小众工业零件的检测,能拿到的标注数据永远少得可怜。总不能因为数据不够,就停在原地不做智能化升级吧。
从场景痛点里长出来的方向
大数据时代喊了十几年“数据就是石油”,可真轮到细分领域挖油,大部分时候都是挖半天出来一点点。核心矛盾从来都不是故意要少用数据,是真的拿不出更多标注数据。
有人说,数据增强不行吗?一张变一百张,不就够了?可数据增强变出来的样本都是同一个母本的衍生,学不到新的特征分布,遇到稍微不一样的新缺陷,照样认错。
还有人说,无监督学习不需要标注,直接用不行吗?可无监督学习的准确率波动太大,工业医疗这些场景要的是稳定输出,差一个百分点都可能出大问题,容不得瞎蒙。
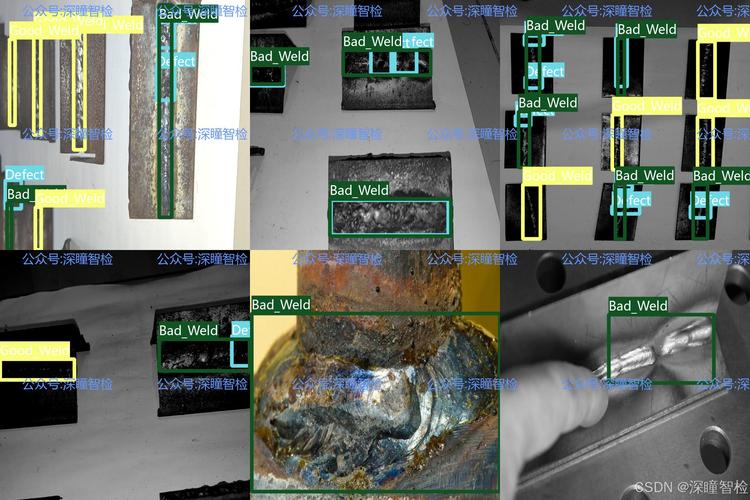 工业缺陷检测小样本标注数据集示例
从需求出发,它要解决的问题从来都不是“反大数据”,是给那些拿不出大数据的场景,找一条能用的出路。核心前提大家心里都有数,我们已经有了海量通用数据训练出来的基础模型,剩下的就是怎么把现成的知识挪过来,用极少的标注适配新任务。
核心逻辑:用先验知识搭梯子
你让一个从来没见过熊猫的人,只看三张熊猫的照片,他下次碰到活熊猫也能认出来。为什么?因为他早就知道什么是哺乳动物,什么是皮毛,什么是黑白花纹,这些都是几十年人生攒下来的先验知识,不需要从零学起。
现有主流方案的本质,其实和这个逻辑一模一样:把预训练阶段学到的通用先验知识,迁移到目标小样本任务上,本质是站在大模型的肩膀上摘果子,不需要从零搭架子。
现在走得比较远的两条路径,一条是提示学习,把目标任务转化成预训练大模型能理解的提示格式,只需要调整少量参数就能得到可用结果,大部分参数都锁死不动,既省算力又省数据。另一条是元学习,让模型提前在大量不同的小任务上训练,学会“怎么快速学习新任务”,碰到真正的目标小样本问题,只要几步微调就能到位。
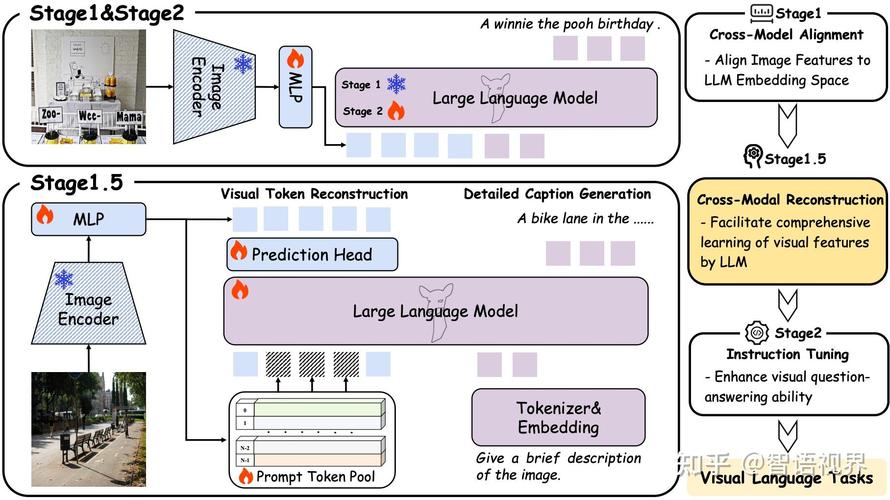 预训练大模型到小样本任务知识迁移示意图
没有任何一条路径是万能的。提示学习对提示词的质量要求极高,换个语序换个说法,最终结果能差十万八千里,调提示的功夫,有时候都够标几百份新数据了。元学习的训练过程对算力和任务库的要求不低,很多中小团队根本玩不起。
最核心的限制,还是分布偏移。如果目标任务和预训练用的通用数据分布差太远,先验知识不仅帮不上忙,还会帮倒忙。举个实际的例子:用互联网文本预训练的大模型,做甲骨文文字的小样本分类,效果还不如直接用少量数据从头训的简单CNN模型。因为互联网文本的字符特征和甲骨文完全不是一个分布,学到的先验全是干扰,反而帮倒忙。
清楚边界才好落地
 清楚边界才好落地
现在能落地的场景,几乎全都是刚好踩在“先验可用”的边界内。比如定制化大模型的风格微调,你要让大模型学会某个冷门作家的写作风格,找不到几百万字的公开语料,攒个几十篇代表作,用小样本方案微调就能出能用的结果。因为通用的语法、用词、表达逻辑这些先验,大模型早就学会了,只需要学这个作家特有的措辞习惯和行文节奏就行。
还有罕见病的影像辅助诊断,全球范围内也就几万份标注病例,刚好符合小样本的场景。通用的人体器官影像结构,预训练模型早就学会了,只需要学罕见病特有的病灶特征就行,实际用下来的准确率,比只拿这些病例从头训的结果高出十几个百分点。
说实话,现在行业里吹得太凶。不少团队拿这个概念炒,说“一个样本就能训AI”,大部分都是噱头。本质是预训练的时候早就见过差不多的样本,把现成的特征拿出来换个壳而已,换一个完全没见过的全新类别,照样歇菜。
还有一个容易被忽略的问题,就是泛化性波动。同一个方法在学术论文的标准测试集上能刷出很高的准确率,拿到工业真实场景里,效果直接跳水一半都不奇怪。因为学术测试集都是整理好的干净数据,真实场景里的数据千奇百怪,什么噪声都有,小样本模型本身扛干扰的能力就弱,很容易崩。
现在大家都在往多模态的方向挤,多模态预训练学到的先验更丰富,能适配更多不同类型的小样本任务,这确实是个值得探索的方向。也有一拨人在研究怎么降低对大预训练模型的依赖,毕竟不是所有团队都能 hold 住千亿参数的大模型,很多细分场景就只有小算力、少数据,能在这种条件下做出稳定效果,才是真正能落地的东西。
大数据堆出来的奇迹,大家已经看了十几年。接下来,也该看看少数据的角落里,能长出什么新东西了。对吧