黑箱拆骨:模型可解释性为什么不是玄学
很多人把这个词做成了圈钱的幌子。
张口闭口都是黑箱,转身就把旧算法包装成新解决方案卖。
你去问他,解释出来的结论到底对不对,他跟你扯行业标准。
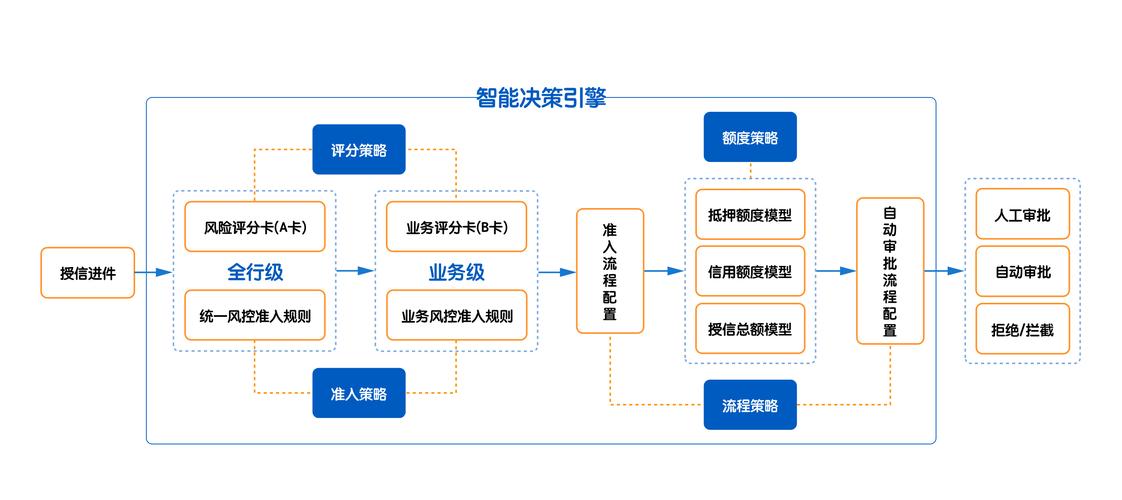 人工智能信贷审批黑箱决策流程示意图
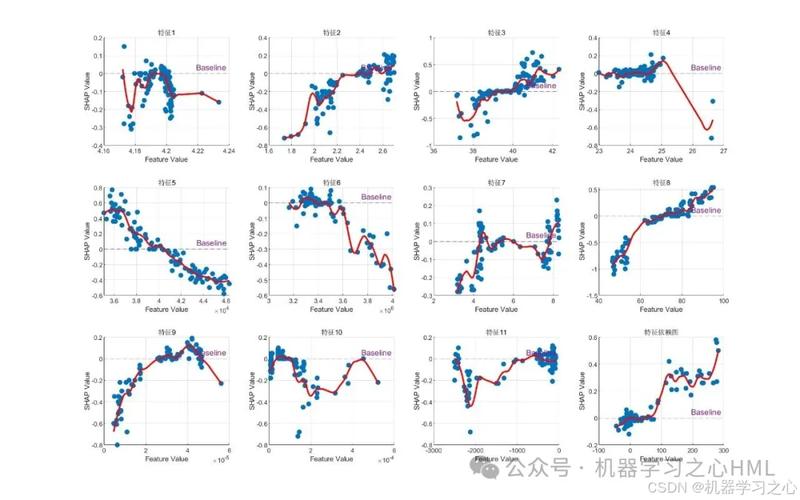 同一风控模型不同SHAP基线特征重要性对比图
不过话说回来,不是说这些方法没用。只是很多卖方案的故意不说这些限制,把近似结论说成是模型的真实逻辑,出了问题锅还是客户背。
全是生意。
 我们到底需要什么样的解释
很多人走进了一个误区,觉得解释就是要把模型的每一步都掰得明明白白,给每个输出说清楚一二三。
这根本不可能,也没必要。
当一个十几亿参数的大模型输出一段医疗诊断建议,你哪怕把每一层的注意力权重都打印出来,主治医生也看不懂,更不会用这个来改自己的诊断方案。
我们需要的,从来不是对模型结构的解释,是对决策依据的可追溯。
在医疗影像场景,模型只要说清楚,它判断为恶性的依据是左肺下叶这块边界不规则的结节,就够了。医生不需要知道第三层卷积提取了什么纹理特征。
在信贷场景,模型只要说清楚,拒贷的核心依据是近六个月连续三次逾期,就够了。不需要把每个特征的贡献度精确到小数点后两位。
反过来,现在很多伪解释就很可恨。为了满足监管要求,硬生生给每个输出凑一套符合人常识的规则,和模型真实的决策逻辑半毛钱关系都没有。比如用户明明是因为地址所属区域坏账率高被卡,解释的时候写成"征信查询次数过多",用户改都没法改,还侵犯了知情权。
至于风险,现在很多人谈偏见修复,都要靠可解释性来找模型里的偏见。如果你的解释本身就是错的,偏见根本找不到,最后带着歧视的模型一直跑,出了事就是大问题。
未来的方向没人敢说死,但至少有一点是明确的:我们不需要为了解释而解释,更不需要把这个概念做成割韭菜的工具。要解决真实场景里的问题,要给受决策影响的人一个明确的说法,这才是最根本的。
没人愿意碰的隐形雷
工业界落地,大家默认把准确率放在第一位。只要AUC能涨一个点,没人会纠结模型到底怎么出结果。 信贷审批卡了用户,甩出一句"综合评分不足"就完事,监管问起来就补一套规则,谁真的去挖模型内部的逻辑? 招聘用AI筛简历,筛掉了女性求职者,模型说自己是根据岗位匹配度算的,没人说得清到底是不是训练数据里的历史偏见被放大了。 说实话,越是影响人核心利益的场景,大家越喜欢用黑箱。反正出了问题,找不到具体责任人对吧。人工智能信贷审批黑箱决策流程示意图
拆箱的两条路,全带坑
现在主流的做法无非两类,一类是一开始就做可解释的模型,另一类是给训练好的黑箱补解释。 第一类好懂,线性回归、短决策树,每个参数的含义都清清楚楚,拿出来就能说清楚每个决策占了多少权重。但是限制也很明显,复杂非线性场景下,性能掉得离谱。你拿单棵决策树去做影像肿瘤识别,准确率连深度学习的边都摸不到。没人愿意为了解释,放弃准确率换个没人能用的模型。 第二类就是现在市面上最火的事后解释,SHAP、LIME这些名字,圈里人都听过。很多人觉得这就是终极答案了。 说实话,我上个月帮一家城商行调过风控模型的解释模块,同一个模型同一样本,SHAP的结论完全依赖你选的基线分布,选全量样本平均做基线,"近三个月征信查询次数"是排名第一的重要特征,换违约样本平均做基线,第一直接变成"月收入与负债比",排序直接反过来。你说哪个是对的? 没有人能拍胸脯保证。这些方法本质上是用一个简单可解释模型去拟合局部的输入输出,是近似,不是真相。同一风控模型不同SHAP基线特征重要性对比图
不过话说回来,不是说这些方法没用。只是很多卖方案的故意不说这些限制,把近似结论说成是模型的真实逻辑,出了问题锅还是客户背。
全是生意。
我们到底需要什么样的解释
我们到底需要什么样的解释
很多人走进了一个误区,觉得解释就是要把模型的每一步都掰得明明白白,给每个输出说清楚一二三。
这根本不可能,也没必要。
当一个十几亿参数的大模型输出一段医疗诊断建议,你哪怕把每一层的注意力权重都打印出来,主治医生也看不懂,更不会用这个来改自己的诊断方案。
我们需要的,从来不是对模型结构的解释,是对决策依据的可追溯。
在医疗影像场景,模型只要说清楚,它判断为恶性的依据是左肺下叶这块边界不规则的结节,就够了。医生不需要知道第三层卷积提取了什么纹理特征。
在信贷场景,模型只要说清楚,拒贷的核心依据是近六个月连续三次逾期,就够了。不需要把每个特征的贡献度精确到小数点后两位。
反过来,现在很多伪解释就很可恨。为了满足监管要求,硬生生给每个输出凑一套符合人常识的规则,和模型真实的决策逻辑半毛钱关系都没有。比如用户明明是因为地址所属区域坏账率高被卡,解释的时候写成"征信查询次数过多",用户改都没法改,还侵犯了知情权。
至于风险,现在很多人谈偏见修复,都要靠可解释性来找模型里的偏见。如果你的解释本身就是错的,偏见根本找不到,最后带着歧视的模型一直跑,出了事就是大问题。
未来的方向没人敢说死,但至少有一点是明确的:我们不需要为了解释而解释,更不需要把这个概念做成割韭菜的工具。要解决真实场景里的问题,要给受决策影响的人一个明确的说法,这才是最根本的。