从故障宕机到持续可用:系统可靠性设计的破局路径
为什么99.9%可用性还是留不住用户
很多团队对可用性的理解,还停留在堆硬件、加备份的层面。服务器做双机热备,数据库做主从同步,光纤拉两根,看起来万无一失。
真出问题的时候,一抓一个准。总有你没考虑到的环节跳出来捅刀子。
我见过创业公司为了做高可用,把核心系统拆成了二十多个微服务,每个服务都做了多实例部署,结果上线第一个月,因为一个服务的配置更新错了版本,所有依赖它的上游全挂了。回滚花了一个多小时,那段时间新用户根本注册不了。
说实话,大部分故障从来都不是单点失效引发的。是一个小问题顺着调用链一路蔓延,从一个模块拖垮整个系统。
 大型电商分布式系统故障根源定位热力图
用户不会管你哪个点出了问题,只要他用不了,你的可用性就是零。对外承诺的五个九,在用户遇到故障的那个时刻,毫无意义。
失效链:被忽略的隐性风险
可靠性的核心矛盾,从来都不是如何让每个节点不失效,而是如何控制失效带来的影响。
哪怕每个节点的可靠性做到0.99,十个节点串联起来,整体可靠性就降到了0.904,一百个节点串联,整体可靠性直接跌到0.366。换句话说,一百个99%可靠的节点串起来,你有超过六成的概率会遇到整体故障。
这就是失效链的累积效应。越复杂的系统,节点越多,串联路径越长,整体可靠性越低。很多人拼命提升单点可靠性,却从来没切断过失效的传播路径。
刚才说的第三方短信验证的例子,就是典型的串联失效。交易流程把短信验证当成了必要环节,短信服务一挂,整个交易流程跟着停。如果设计的时候把短信验证做成异步可降级的,哪怕短信发不出去,交易先完成,后续再补发短信,根本不会出现大故障。
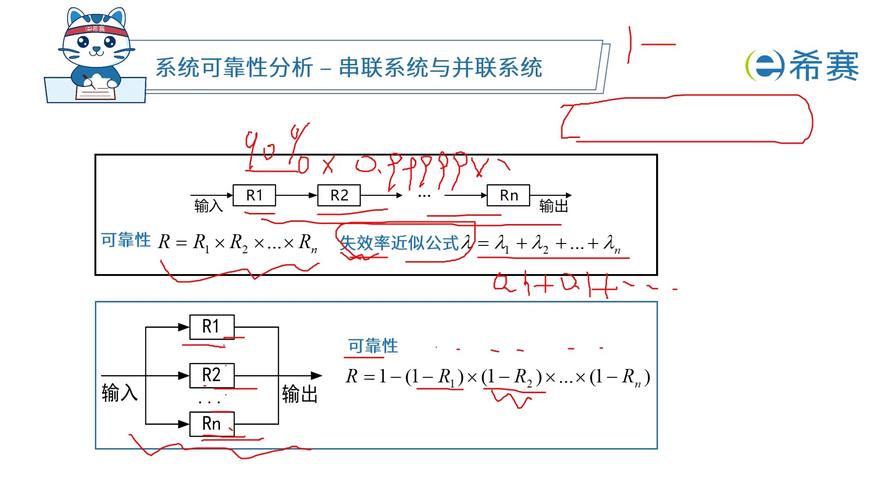 分布式系统串联失效链概率计算示意图
不过话说回来,也不是所有团队都不懂这个。我见过不少团队,为了避免单点失效,做了全链路冗余,结果可靠性反而更低了。为什么?冗余越多,系统越复杂,配置错误、网络分区、一致性同步出错的概率就越高。每加一层冗余,就是多了一串可能失效的新节点。
之前有个国企的项目,核心系统做了三层异地冗余,结果一次例行切换演练,因为三个节点的数据同步差了三秒钟,硬生生把用户的订单重复扣了三次款,最后赔了上百万才解决。
有限冗余与动态容错的平衡
有限冗余原则,是我见过最实用的设计思路。不追求所有节点都不失效,不堆不必要的备份,只需要把失效控制在有限范围内,不扩散。
怎么做?核心是故障隔离域切分。把整个系统按照业务、物理区域、优先级切成多个互相隔离的域,每个域的失效不会影响其他域。比如把不同地区的用户流量分到不同的隔离域,一个地区的域出问题,其他地区正常用;把核心交易和非核心的通知、统计分到不同的域,非核心出问题不影响核心。
给所有依赖都做降级预案。任何外部依赖都可能挂,你要提前想好,依赖挂了之后,要不要等它恢复,能不能用缓存代替,能不能直接跳过这个环节。大部分非核心依赖,都可以设计成异步或者可跳过的,没必要绑死在主流程里。
混沌工程本质就是主动找失效链。定期主动关掉一个节点,拔掉一条光纤,停掉一个依赖,看故障会不会扩散,提前把可能的坑填上。很多团队只有出了事才找问题,主动找问题的,出大事的概率低太多。
这里要说清楚应用边界。不是所有系统都需要做五个九的可靠性。内部OA系统,就算每天停一小时,也不会影响核心业务,花几十万做高可用完全是浪费钱。面向C端的核心交易系统,哪怕多一分钟故障都可能损失百万,这个钱必须花。
过度设计的危害,不比设计不足小。复杂度每提升一倍,出故障的概率就翻好几倍。适合当前业务规模的,才是对的。
现在云原生普及之后,整个思路变了。以前我们追求基础设施不出错,现在我们承认基础设施本来就不可靠,服务器会坏,网络会断,代码总会有bug,我们要做的不是消灭错误,是在错误发生的时候,让用户感受不到。
这种思路转变,才是真正提升整体可用性的核心。很多人搞了好几年架构,都没转过这个弯来。