漏洞之后与攻击之前:网络安全技术研发的可验证性困境
安全行业内部有一个不太体面的共识:大量防御技术的有效性,从未被真正检验过。发布会的拦截率、实验室的检出率、白皮书里的覆盖率,数字都成立。真正麻烦的地方在于——没人知道对手换一版工具之后,这些数字还剩多少。
这不是态度问题。它源于一个结构性事实:攻击者只需要找到一条可行路径,防御者却要为所有路径负责。网络安全技术研发的工作,本质上是在一个开放、对抗、持续变化的系统里,试图把“不确定性”压到某个可接受的阈值之下。压得下去多少,取决于方法,也取决于我们敢不敢承认方法的边界。
时间差:防御为什么总慢半拍
先看一个常被忽略的变量——时间。
漏洞从被发现到被利用,窗口期正在压缩。公开披露到野外利用活跃,中间可能只有几天甚至几小时。而一个检测规则的研发流程——样本采集、特征提取、回归测试、灰度上线——通常以周为单位。两者的时间尺度不在一个量级上。研发节奏与威胁演化节奏的错配,是许多安全能力“上线即落后”的根源。
有人会说,那就用行为检测、用机器学习,摆脱特征依赖。方向没错。可行为模型的训练同样依赖历史数据,而历史数据描述的永远是过去。一个在半年语料上收敛良好的模型,面对语义等价、编码变形的同类样本时,衰减有多快?这个问题在工程上很少被量化,因为它需要长期、连续、同分布的红队数据——恰恰是最难拿到的资源。
所以第一个判断是:网络安全技术研发的核心矛盾,不是算法不够新,而是“对抗条件下的能力保持”缺少可测量的抓手。
能力从哪长出来:从盯屏到自动化挖掘
过去十年,漏洞发现的技术路线经历了一次明显的迁移。人工审计、静态规则匹配,逐步让位于覆盖率引导的模糊测试、符号执行、污点分析,以及近几年的智能变异与种子调度。逻辑其实朴素:把程序的执行状态空间当作搜索空间,用反馈信号引导输入生成,让崩溃尽量早、尽量多地出现。
工程上真正卡人的地方有三处。
一是状态爆炸。符号执行在遇到循环、指针别名、外部库调用时,路径数量会以不可控的方式膨胀,约束求解器随之失去效率。很多工具在中型二进制上表现良好,换到大型闭源组件就退化成一个昂贵的随机测试器。二是可达性。触达深层代码需要绕过校验、加密、协议握手,这些“门槛逻辑”本身成了最难自动化的部分。三是误报。一个静态分析工具报出上千条告警,其中真问题可能只有个位数,剩下的成本全部转嫁给研判人员。
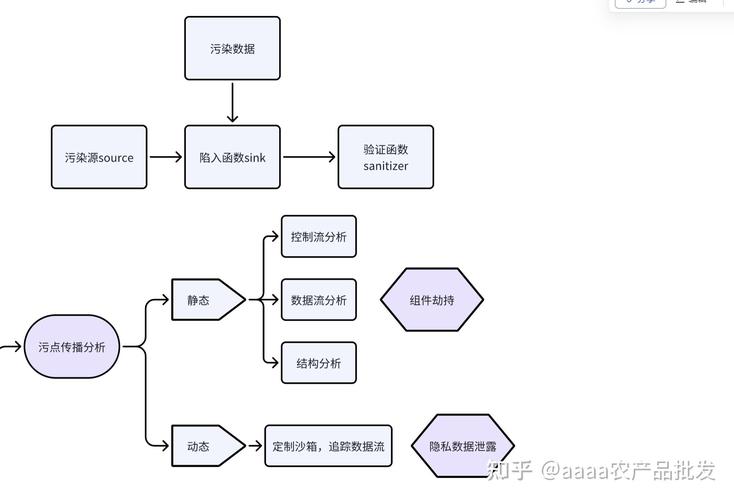 覆盖率引导模糊测试插桩执行流程图
值得说一句的是,把大模型引入种子生成与语义变异,确实在部分场景下提升了探索效率。但它的作用是局部的:能降低构造合法输入的门槛,无法替代对程序语义的理解。把它当成一个更聪明的变异算子,比当成一个会思考的审计员要务实得多。
验证的泥潭:基准、复现与度量
一个安全能力被研发出来,如何证明它有效?这个问题比研发本身更难。
公开数据集的问题由来已久。语料发布之初代表真实分布,三五年后就成了过时样本的集合,模型在其上刷出的高分,说明的是记忆能力而非泛化能力。更隐蔽的是污染:训练语料与评测集的重叠,往往连作者本人都不完全清楚。
红队演练提供了另一种验证途径,可它天然不可复现。同一支队伍、同一套目标,换一天执行,结果可能完全不同。演练暴露的是“当时能不能打进来”,而不是“防御能力稳定在什么水平”。要命的是,这两种结论在汇报里长得几乎一样。
那么可行的做法是什么?大致有三条约束条件:
第一,环境可重建。 靶场、流量回放、依赖版本,都要能按脚本重新拉起。任何无法复现的验证结果,只能当作线索,不能当作依据。
第二,对手要动。 评估必须包含主动规避行为——混淆、分片、合法工具滥用、低频慢速。静态样本上的高分不构成承诺。
第三,指标要带代价。 只报检出率不报误报率,等于没报。在低误报约束下,很多方案的性能会塌陷一个台阶,这个台阶的高度,才是真正需要写进文档的数字。
 安全运营中心威胁告警研判工作台实景
边界的自觉:有些问题不该指望技术解决
 边界的自觉:有些问题不该指望技术解决
技术乐观主义在安全领域很常见,也很危险。
举个例子。某类横向移动检测方案在实验室环境的检出率相当可观,但部署到真实办公网后效果大幅下滑。原因不是算法退化了,而是资产台账不准、服务账号共享、运维通道本身与攻击行为高度同构。检测逻辑没错,环境不支持。这类失败在复盘时经常被归因于“调参不到位”,其实是边界被误判。
还有性能开销。端侧采集越细,主机负载越高;旁路镜像越全,网络改造越重。安全能力最终必须服从业务的可用性约束,这不是妥协,而是前提。一个要求停服才能部署的方案,在多数生产环境里等于不可部署。
供应链是另一个经常被低估的维度。第三方组件、开源依赖、外包开发的代码,构成了攻击面里相当大的一块,而这部分能力往往不在自家研发团队的视野之内。你能加固自己写的代码,很难约束别人写的构建脚本。
所以,与其追求“全场景覆盖”,不如把量化的适用条件写清楚:在什么网络形态、什么资产规模、什么误报容忍度下,这个能力成立;超出范围,它大概率不成立。承认这一点,比多写三页技术亮点更有价值。
回到工程:一点不那么激动人心的期待
网络安全技术研发走到今天,缺的早已不是新概念。缺的是把能力钉在可复现的证据上,缺的是在方案里主动写出失效条件,缺的是把长期投入放在那些短期内答不出漂亮数字的地方——数据管道、资产治理、评测基建、样本脱敏与共享机制。
这些事情做起来很慢,也没有戏剧性。但它们决定了下一次对手换工具的时候,你手上还剩多少。
慢一点,稳一点。安全这个行当,本来就不奖励速胜。