智能装备研发中的验证债务:为什么样机搬进车间就“变笨”
一台六轴机械臂在实验室连跑两周,重复定位精度稳定在 ±0.02 毫米。搬到客户车间第三天,位置超差报警。研发团队连夜排查,最后的原因有点荒谬:下午两点,车间东侧三台空调外机同时启动,局部环境温度上升约 4℃,臂体热膨胀改变了末端坐标系的标定参数。
这就是智能装备研发的日常。不是论文里那条平滑收敛的曲线。
一、先把“智能”两个字拆掉
装备研发的历史比“智能”这个词长得多。车床、注塑机、贴片机,它们的研发逻辑早已成型:确定功能—分解机构—分配公差—做样机—跑工况—改设计。加进传感器、控制器和算法之后,这套逻辑并没有作废,只是多了一个麻烦的变量:软件的时间尺度比机械短两三个数量级。
机械结构的疲劳寿命按年算,控制算法的迭代按周算,现场工况的变化按分钟算。三种节奏叠在一起,研发管理就很容易失控。常见的一种失败模式是:算法团队每周发版,硬件团队每季度改一次结构,双方在同一个测试台上互相掩盖问题。软件调参把机械装配误差补掉了,机械改结构又把算法的标定作废了。
所以比较务实的做法,是在项目早期就把接口冻结和自由迭代的边界划清楚。电气接口、机械安装面、坐标系定义、时间同步机制,这些一旦确定就别轻易动,改动成本按指数走。至于上层路径规划、参数寻优、模型结构,可以放开。这话说起来轻,做起来需要一点组织上的狠劲。
 工业机器人关节谐波减速器装配公差测量现场
二、仿真跑得漂亮,不等于能交付
 二、仿真跑得漂亮,不等于能交付
关于数字孪生,行业里有一种过于乐观的默认前提:仿真足够逼真,实物试验就能省下来。这个前提在特定条件下成立,比如刚性件、低速、环境可控的搬运场景。一旦涉及接触、摩擦、柔性变形、流体,仿真的可信区间会迅速收窄。
具体一点。一个接触力模型里的库仑摩擦系数,在干摩擦、边界润滑、微量油膜三种状态下数值可能差 30% 以上。仿真里取一个常数,实物上它随温度、湿度、磨损量持续漂移。模型误差不是噪声,是有结构的偏差,它会在特定工况下集中爆发,而不是均匀分布。
更麻烦的是 sim-to-real 的迁移。强化学习在仿真环境里训练出来的策略,往往过度拟合了仿真器的动力学细节。仿真里关节阻尼是线性的,实物上减速器回差带迟滞。这种差异用域随机化能缓解一部分,代价是策略保守、动作变钝。工程上通常的折中是:关键安全动作由规则兜底,性能优化部分交给学习算法,两层各管一段,谁也别越界。
三、仿真与实物之间那段路,得靠专门的台架
硬件在环测试台架的价值,往往在项目后期才被真正认识到。它解决的是一类很具体的问题:控制器代码在真实时序约束下的行为。1 ms 控制周期、抖动允许 50 μs,这个约束在纯软件仿真里几乎测不出来,因为桌面操作系统本身就做不到确定性调度。
台架能做的事很实在。注入传感器故障,看系统是否进入安全状态。人为制造总线丢包,观察位置环是否振荡。把编码器信号延迟两个周期,量一下末端轨迹偏差有多大。这些测试不需要破坏真实设备,成本可控,重复性好。
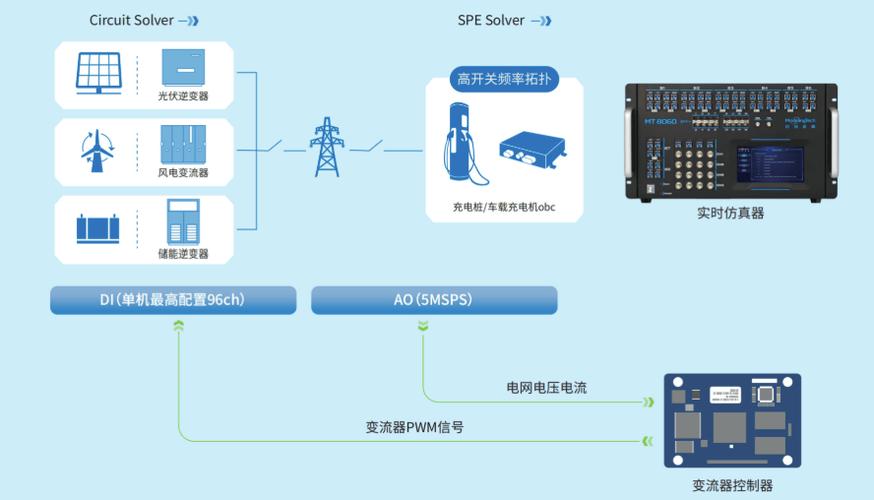 智能装备硬件在环仿真测试台架电气接线图
不过台架也有边界。它难以复现的是长期退化:润滑脂老化、密封件蠕变、线缆疲劳。加速寿命试验能覆盖一部分,但加速因子本身需要实验标定。标定不准,结论就是失真的,而且是那种看起来很像回事的失真。
四、把“验证债务”当成一笔要还的账
 四、把“验证债务”当成一笔要还的账
软件行业有个说法叫技术债。装备研发里对应的东西,我更愿意叫验证债务。为了赶节点,先跳过某项工况测试,先不做某项故障注入,先用临时方案绕过某个标定流程。这些决定在当时看起来都挺合理,成本也低。问题是它们不会消失,只会在量产后以另一种形式回来:现场故障、批量返工、售后成本。
一个可操作的做法是给验证项打标签。哪些必须在上线前完成,哪些可以放到小批量阶段,哪些可以在版本迭代中补。关键是这个标签要有人签字,要能追溯。没有明确责任归属的“待办验证”,等于没有验证。
五、数据闭环的边界在变,但没那么快
 五、数据闭环的边界在变,但没那么快
现场运行数据回传,理论上能让算法持续变好。现实中卡在三个地方。数据传输的合规与安全,尤其是在涉及工艺参数和产线节拍的时候。数据标注的成本,工业现场的数据分布极度不均衡,故障样本稀少且难以复现。还有就是模型更新的责任边界,算法升级导致设备行为变化,出了问题算谁的。
比较稳的路径是分级更新。低风险场景下的参数自适应可以直接在线做,模型结构变更走离线验证加灰度放量,涉及安全功能的逻辑修改必须走完整回归。这个分级不需要多复杂,但必须事先定义。事后补是补不上的。
六、几个正在松动的判断
传感器数量这件事,行业里的直觉在变。每增加一个通道,就多一份标定工作、多一条故障路径、多一份数据处理成本。在精度已经够用的场合,减少冗余往往比增加冗余更有利于可靠性。这话听着反常识,做过现场的人都懂。
边缘算力的增长也确实改变了一些取舍。以前因为算力受限而不得不简化模型的地方,现在可以上更复杂的结构。但延迟约束还在。控制回路里的推理时间必须可预测,这一点上,小模型加规则往往比大模型更实用——大模型在一次推理上快,不代表它在最坏情况下也快。
还有一件事被普遍低估:元器件替代带来的重新验证成本。同一型号的电机,不同批次的反电动势常数可能有几个百分点的差异。换供应商,意味着整套控制参数要重新标定。这在供应链波动的时期是实打实的负担,而且它不出现在任何一张项目进度表上。
回头看那台下午两点报警的机械臂。解决方案其实不复杂:在标定模型里加入温度补偿项,用臂体上已有的温度传感器做输入,参数靠一周的现场数据拟合出来。真正花时间的不是算法,是发现问题的过程。
装备研发里很多工作都是这样。技术难度不高,但它要求你待在现场,而不是待在会议室。