大数据技术研发:从堆机器到拼脑子,这行到底卷成啥样了?
说实话,前阵子跟一个做数据平台的老哥吃饭。他端着杯子叹口气——“我们现在最大的敌人,不是业务方,是自家那套跑了两年、谁也不敢动的血缘系统。”
哈。这话听着像段子,但你还真别笑。
大数据技术研发这摊事,早过了“拉几百台机器跑个Hadoop集群就能吹半年”的年代了。现在拼的是什么?是细节。是那些看起来不起眼、但一崩就让你半夜爬起来加班的鬼东西。
存储这层:湖仓一体终于不像PPT了
先聊存储。
几年前各路大会都在喊“数据湖”“数据仓库”“湖仓一体”,听多了人是真烦。但你回头看这两年,Iceberg、Hudi、Delta Lake 这几个开源项目的迭代速度,确实吓人。为啥?因为大家真被“存两份数据、维护两套元数据”给折磨够了。
存算分离这个词也一样。以前听着像营销话术,现在?对象存储加弹性计算节点,成本账一算,真香。
不过话说回来——坑也不少。小文件问题至今没被根治,元数据服务在超大规模下的性能瓶颈,还是各家自己填坑。你去看那些大厂的开源方案,几乎每家都在元数据层做了魔改,没一个敢用原生的。
有个细节挺有意思:现在做实时入湖,很多人不再无脑追求“秒级”,反而开始权衡延迟和成本的平衡点。秒级就比分钟级高贵吗?不一定。多花的钱和那点时效收益,得算明白。
 数据湖仓一体存储元数据分层架构图
计算引擎:批流一体喊了这么久,真统一了吗
再聊计算。
Flink 封神好几年了,Spark 也没死。这俩现在的关系挺微妙——不像对手,更像两条路各自走到了岔路口,然后偶尔还得互相借道。
批流一体的“理想”,是让一套代码同时处理历史数据和实时数据。听起来很美。实际做过的都懂,SQL 写起来是爽,可一旦你的场景里混进了状态管理、乱序处理、背压……调试起来那叫一个酸爽。
我自己踩过最深的坑是什么?状态后端选型。RocksDB 吧,性能好,但调优麻烦得要命;用内存吧,一到高峰期就 OOM。没有银弹,真的没有。
现在有个趋势我挺看好:计算引擎开始往“无服务器化”方向飘。就是说,你不想管集群了,扔个 SQL 上去,资源自动扩缩。这玩意儿对中小团队简直是救命稻草——你想想,谁愿意专门养一个调 YARN 参数的运维?招人贵不说,还留不住。
 Flink批流一体任务DAG执行拓扑图
大模型一来,向量数据库卷成新战场
然后就是这两年最躁的一块——向量。
RAG 火了之后,向量数据库直接从边缘角色变成了 C 位。Milvus、Qdrant、Weaviate……融资的融资,开源社区拼命迭代,热闹得不行。
但我想泼盆冷水。
很多人以为“向量检索”就是装个库,把 embedding 塞进去,完事。错。大错特错。真正的难点在检索质量:分块策略、召回精度、重排序,每一步都是玄学。你分块分得不好,再牛的 embedding 模型也白搭,出来一堆牛头不对马嘴的结果。
还有个被低估的问题——成本。向量的存储和检索,尤其在高维、大规模场景下,算力开销是真金白银。很多团队一开始拍脑袋上向量库,跑着跑着发现账单比预期高了三倍。有的是六倍。
所以我现在一看到“我们用了向量数据库”这种话,第一反应不是羡慕。是想问一句:你的召回率多少?冷启动怎么处理?混合检索做了吗?
 向量数据库HNSW近邻索引构建示意图
最容易被忽视的:数据治理才是那道坎
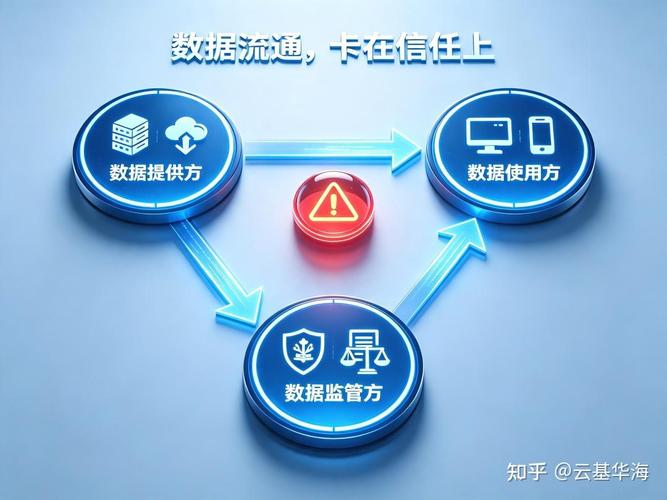 最容易被忽视的:数据治理才是那道坎
最后说个扎心的。
技术栈再花哨,数据质量不行,一切都是空中楼阁。
我见过太多团队,架构图画得漂亮,湖仓一体、实时链路、向量检索全齐活。结果呢?上游埋点乱成一锅粥,字段口径三个月换一次,血缘关系靠 Excel 维护……
这时候你跟他们聊什么湖仓、什么批流统一,都是对牛弹琴。
数据治理这事,没有技术奇迹。就是脏活累活,就是一个个字段对、一条条血缘理。谁肯下这个笨功夫,谁的数据资产才真能用起来。偷懒的结果,早晚会在某个凌晨两点找你算账。
哦对了,还有元数据管理。现在很多团队开始上 Data Catalog,但你千万别指望它自动帮你理清一切。工具是工具,规矩是规矩。没人定规范,Catalog 也就是个好看的花瓶,摆着好看,查起来想哭。
说到底,大数据技术研发这行,拼的已经不是“谁家组件多”,而是“谁家链路稳”。稳定性、成本、可维护性——这三个词,才是真正拉开团队差距的地方。
凌晨三点的告警,才是最好的老师。真的。