人工智能辅助创新:卡住我们的从来不是点子,是验证太贵
去年秋天,我在江北一家做特种胶黏剂的小厂待了两天。车间里那股氨味到现在还记得,混料间一台老搅拌机嗡嗡转。带我的是个五十来岁的老师傅,姓陈,手背上全是烫出来的旧疤。他说调一个耐高温配方,正常得走小试中试,一轮三个月。三个月,还得运气好。
后来他们上了套东西。不是什么大模型,就是一个带约束的贝叶斯优化脚本,配一台能自动称量、自动测粘度的实验台。陈师傅一开始特别不屑,说机器懂个屁的胶。
第四周,脚本给的配方他看都没看懂,两个组分的比例在他三十年经验里属于“乱来”。他骂骂咧咧地做了,结果玻璃化转变温度比他自己调的那版高了十几度。
我问他服不服。他嘬了口烟,说,服一半。因为它不懂为什么。
创新真正的成本,藏在“验证”这两个字里
我们平时聊创新,总喜欢聊灵感、聊灵光一现。扯淡。真的做过研发的人都知道,点子从来不缺,纸上画一画,谁都能蹦出七八个想法。真正把你拖死的是验证:一次实验要多少钱、多少时间、多少人盯着。
这里有个特别朴素的估算。假设一个配方有十个组分,每个组分的比例只取一百个档位——听着不多吧?那组合空间就是一百的十次方,写成数字是1后面二十个零。宇宙里的星星加起来也没这么多。你拿人肉去试,试到地球毁灭都试不完一小角。
所以问题的本质变了。它不再是“我能不能想到好方案”,而是“在有限次实验的预算下,我怎么能更快地逼近那个好方案”。
这就是人工智能辅助创新真正发力的地方。它干的第一件事,不是替你产生灵感,是替你省钱。
 材料实验室自动配方称量实验台机械臂
具体怎么省?说一下那套脚本的逻辑,其实不复杂。你先随便做十来个实验,哪怕瞎做也行。模型拿到这十几个点,拟合出一张“地形图”——哪些区域看起来有戏,哪些明显是坑。注意,这张图是猜的,准确度有限。然后它不急着去图上的最高点,而是算一个叫“采集函数”的东西,专门挑那种“要么很可能是好的,要么我特别没把握”的点让你去试。
这俩动机是打架的。一个叫利用,一个叫探索。前者是赶紧去挖已知的好矿,后者是冒点险去没人去过的地方看看。采集函数干的就是在这两者之间找平衡。
我常拿大雾天爬山打比方。你在一座看不见顶的山里,能见度二十米。你不可能直接看到峰顶在哪,只能走一步、测一下脚下高度、更新一下脑子里那张地图,再决定下一步往哪迈。走得越多,地图越准。贝叶斯优化的精髓就是:每一轮实验的信息量,都被榨干了用。传统的正交实验或者单因素轮换,试完一个点,这个点得到的信息基本就扔了。
这里插一句,很多人以为这套东西要大数据,要几千几万条记录。恰恰相反。它最强的时候,是数据少到可怜的时候——十几个点就能起步。但代价也很直接:你的先验假设得靠谱,模型得选对。如果物理规律本身不光滑、一锅胶里冒出一堆离散的相变,那高斯过程那张光滑的曲面就彻底骗了你。
生成模型那一半,是完全另一码事
上面说的这类是“搜索型”的:候选空间已经给定,模型负责高效地翻找。还有一类是“生成型”的,模型直接给你造出新东西。蛋白质设计就是典型。自然界里存在的蛋白质序列,跟所有理论上可能的序列比起来,少得跟没有一样。扩散模型干的事,是从噪声里一步步“去噪”出一段能折叠成特定形状的氨基酸链。
这两类的脾气完全不同。搜索型靠的是评价函数,它关心“这个有多好”;生成型靠的是分布,它关心“这个像不像真的、合不合理”。
 蛋白质扩散生成模型去噪折叠过程示意图
麻烦也在这儿。生成模型最容易犯的错,是给你一堆“看起来很美”的东西。它学会了训练数据里的审美,于是产出的分子、序列、结构,全都长得规规矩矩、似曾相识。你想要的是惊喜,它给你的是平均值。
这就引出一个挺反直觉的观察:让模型一味追求“合理”,恰恰会扼杀创新。很多突破性的分子或者结构,在当时的认知里都是“不合理”的。所以真正做设计的人,会在采样的时候故意留一点温度,故意让它稍微“跑偏”一点,然后再用物理模拟去筛。
生成和筛选,得配合着来。单靠任何一边都是瘸的。
我见过最容易踩的三个坑
说点扫兴的。
坑一,评价函数写错了,后面全白搭。这是最常见也最致命的一种。你嘴上说要耐高温,实际代码里优化的是某个温度点下的模量,模型就会精准地把你带到一个模量爆表、但一遇热就软掉的鬼地方。指标和真目标脱钩,模型越聪明,跑得越偏。这就是所谓的“一旦某个指标变成目标,它就不再是好指标”。做研发的都知道,很多性能指标之间是互相打架的,你把一个拎出来当靶子,别的就塌了。所以评价函数往往得是一个多目标的东西,还得带一堆硬约束,写起来相当啰嗦。
坑二,数据分布太窄,模型只会原地打转。你厂里过去十年都是那几条工艺路线,数据全挤在一小块区域。模型学完之后,给你推荐的“新方案”,全都在老方案的裙边附近晃。它不敢往远处跳,因为远处它一无所知。想让它真的跳出框,要么你主动喂一些刻意离谱的实验点进去,要么换一种探索策略。指望它自己开悟,很难。
坑三,也是最隐蔽的一条:人会把模型当预言机。点一下按钮,等它吐一个“最优解”,然后照着做。这么用,你很快就会发现效果一般。真正跑得好的团队,是把模型当探针——它给的每一个推荐,背后都带着一个“为什么是这个”,那个理由本身才是最有价值的产出。它会告诉你,它其实对某个变量的作用方向完全没把握,或者它觉得两个变量之间存在一个它没见过的强耦合。这些信息,比那个配方数字值钱多了。
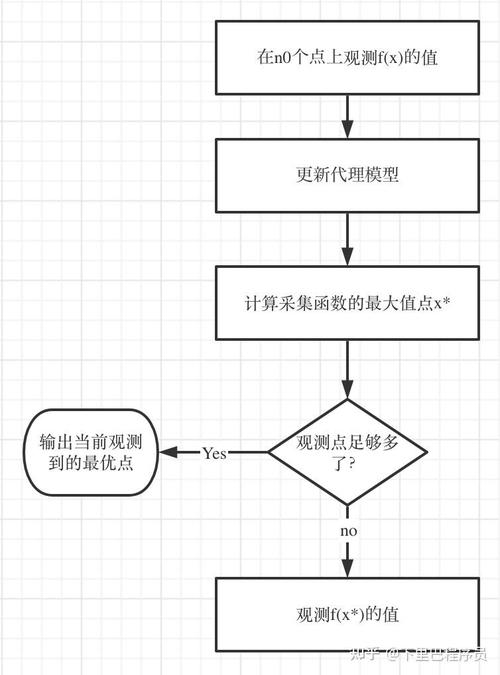 贝叶斯优化代理模型采集函数迭代采样流程图
那条线划在哪儿
 那条线划在哪儿
我自己的判断标准特别简单粗暴:看验证一次要多少钱。
验证便宜的地方——跑一段代码、算一个仿真、做个几小时的实验——AI辅助创新简直是降维打击。它能一天迭代上千轮,把人类几十年的经验空间一天翻完。芯片的布局布线、算法的超参、催化剂的初筛,都是这个逻辑。
验证昂贵的地方,比如电池要做几百次循环充放、新药要过临床,AI的角色立刻变了。它不能替你砍掉验证,只能帮你把有限的实验名额花在刀刃上。从“帮你找答案”退回到“帮你排优先级”。这个退步听着不大,实际价值天差地别,很多宣传里故意把这两件事混着说。
还有一层边界,比成本更根本:谁来定义问题。模型能在一个给定的目标函数上翻山越岭,但它不会告诉你这山是不是你真正想爬的那座。你把问题问错,它只会更快地给你一个错误的答案。陈师傅那句“它不懂为什么”,戳的就是这个地方。他三十年积累的手感里,藏着很多还没被写进任何目标函数的约束——什么情况下会析出、什么批次原料有猫腻、什么工艺窗口一到夏天就漂移。这些隐性知识,模型拿不到,因为它没被写下来过。
所以我现在越来越觉得,人工智能辅助创新这件事,真正的门槛不在算法,在于你有没有能力把你脑子里的隐性判断,逼成一条条能写下来的目标、约束和先验。这个过程极其痛苦,比调模型本身痛苦十倍。
但恰恰是这个被逼着写清楚的过程,往往就是创新真正发生的地方。
陈师傅最后跟我说,他现在每周会花半天时间,把那些“凭感觉”的判断一条条记下来。写得很糙,错别字一堆。他说,先记着,谁知道哪天用得上。
我觉得这可能是他这辈子做过的最聪明的一件事。