数据可视化技术:从数据映射到认知陷阱,中间隔着多少个想当然
一张图,两种真相
先聊个真事。去年秋天,帮一个做城市交通的课题组看稿子。里面有一张散点图,密密麻麻的GPS轨迹点,蓝色代表早高峰,橙色晚高峰。他们想说明晚高峰的拥堵范围更广。看图,确实,橙色的点铺得更开。但等等,橙色点的总数本来就比蓝色多出近三成——这到底是范围更广,还是采样更密?
没人说得清。因为图没告诉你。
这就很要命了。数据可视化技术,说到底是一种翻译——把数字映射成视觉元素。问题是,翻译过程中,信息会丢,也会加。丢的是语境,加的是制图者的预设。而我们读图的时候,默认图是“客观”的。恰恰是这种默认,构成了大多数误读的起点。
视觉编码不是中立的,它受知觉系统约束,也受设计者意图左右。你看到的“趋势”,可能只是坐标轴截断的产物;你感知的“差距”,也许源于色阶的不均匀分段。
这不是个技术bug,这是认知层面的系统性偏差。

散点图坐标轴截断导致趋势误判对比示意
人眼不是测量仪,是模式探测器
人眼不是测量仪,是模式探测器
搞清楚一件事:人眼对图形的感知,从来不是精确读取。
格式塔学派那帮人早就发现了——我们倾向于把相近的元素归为一组,把连续的线条看作一个整体。这玩意儿在进化上是有用的,在丛林里能快速识别猎物轮廓。但用在看图表上,就经常翻车。比如,一张分组柱状图,如果组内柱子挨得太近、组间间距又不够突出,你的大脑会自动把它们编成一个新序列,读出来的“对比”和真实数据差了十万八千里。
再比如前注意加工。颜色、大小、方向——这些属性在200毫秒内就能被视觉系统捕捉,无需意识参与。听起来很高效对吧?但设计者经常滥用这个机制。在一张图里用彩虹色标表示连续变量,结果观众把颜色差异读成了类别差异。A是红色,B是蓝色,那它们肯定是不同类的东西——数据说它们是同一个维度上的两个值,但你的知觉已经替你做了分类决策。
老实说,这事不能全怪制图者。工具太顺手了。默认色板摆在那儿,谁不想让图好看点?
但好看和准确,有时候是打架的。
技术栈里的那些“默认值”
现在做可视化,选择多到令人发指。Python生态里有matplotlib、seaborn、plotly、bokeh;前端有D3.js、ECharts、Vega-Lite;商业工具Tableau、Power BI更不用说了。每个工具都有一套默认配置——默认色板、默认坐标轴范围、默认分箱策略。
默认值的问题在哪?它们是普惠的,不是为你的特定数据设计的。
我见过太多这样的图:直方图分箱数量用默认的10,结果双峰分布被抹平成一个宽包;箱线图用默认的1.5倍四分位距标记离群点,但实际上长尾数据里那些点根本不该被特殊标记;热力图用默认的线性色阶,可数据分布是幂律的,于是90%的方差被压缩在一个色块里。
默认值是一种隐性的分析决策,它替你做了判断,但没告诉你判断是什么。
更隐蔽的是坐标轴截断。柱状图从非零起点开始,视觉上放大了差异。这在商业报告里常见得令人发指。你去看那些“同比增长300%”的图,柱子的高度比可能也就1.5:1。从知觉上说,柱状图的长度编码应该对应数值比例,截断之后这个映射就失效了。但你不会注意,因为视觉冲击力太强了。
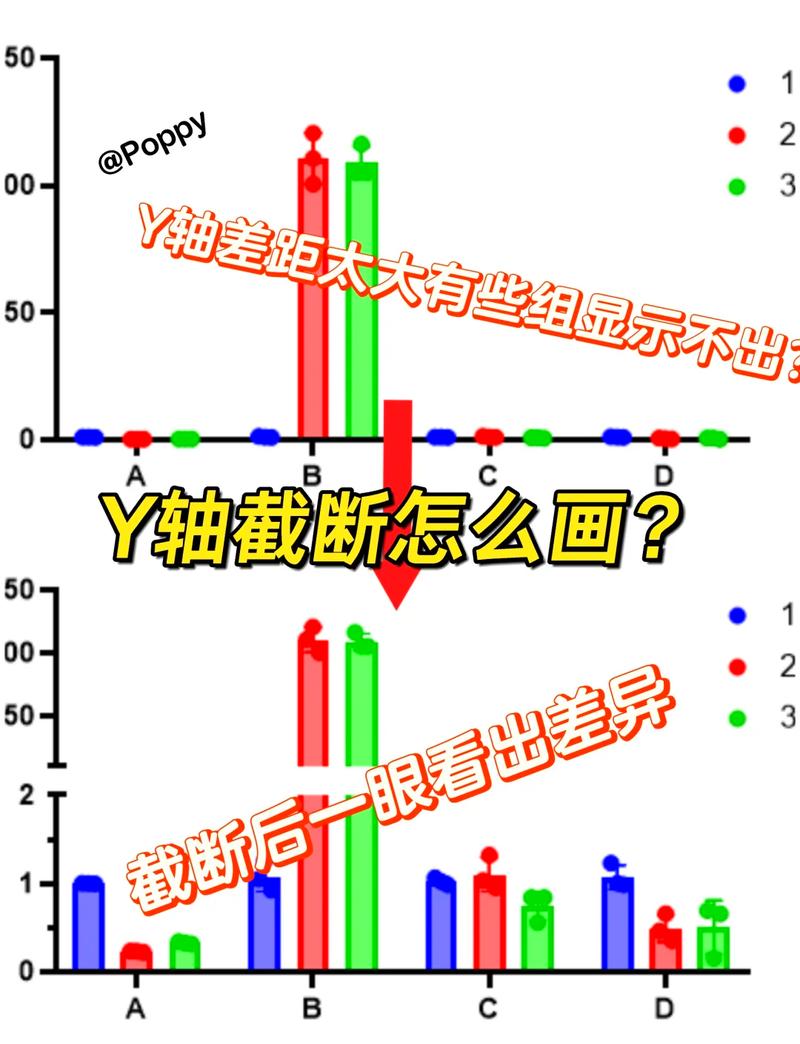
柱状图非零起点截断坐标轴放大差异示意
交互,是解药还是新问题
这几年交互式可视化越来越普及。鼠标悬停显示数值,拖拽缩放坐标轴,点击图例筛选类别。理论上,这能缓解静态图的很多固有问题——你可以自己探索数据,而不是被动接受制图者的剪裁。
但交互本身也引入了新的认知负担。
有个现象叫“交互盲区”:用户在拖拽、缩放的时候,注意力集中在操作上,对数据本身的感知反而变弱了。你玩过那些炫酷的3D散点图吗?转来转去,感觉探索了很多,但最后记住了什么?可能一个具体的数值都没记住。空间旋转带来的沉浸感,替代了对数据关系的理性分析。
还有个更实际的问题:交互式可视化的“默认视图”往往被当作结论来用。决策者打开仪表盘,扫一眼初始状态,就下判断了。他们不会去拖那个滑块,也不会去切换维度。于是
交互的灵活性成了一种摆设,实际影响决策的仍然是那个静态的初始画面。
这挺讽刺的。技术提供了更多可能,但人的行为模式没跟上。
那怎么办?几个不那么教条的思路
说实话,没有万能方案。但有些原则值得反复提醒自己。
第一,可视化之前,先做数据分布的诊断。看一眼直方图,看看偏度、峰度、离群值。这决定了你后面用什么编码方式。正态分布的数据用线性色阶没问题,长尾数据就得考虑对数变换或分位数分箱。别跳过这一步,直接选图表类型。那是本末倒置。
第二,坐标轴该截断就截断,但得说清楚。如果确实需要突出微小差异,那就截断,但在图注里明确标注,并同时提供完整坐标轴的版本。让读者有选择。遮遮掩掩的截断,比不截断更糟。
第三,颜色用感知均匀的色板。viridis、cividis、magma这些,在亮度上是单调变化的,对色觉障碍者也友好。Jet和rainbow色板看着鲜艳,但亮度不单调,会制造虚假的边界。这个坑,踩过的人都知道疼。
第四,交互设计要有引导。别扔给用户一个空白的仪表盘,让他们自己探索。给出预设的视图序列,或者高亮关键发现,让交互服务于叙事,而不是替代叙事。
这些做法,有些工具已经内置支持了,有些需要自己写代码。但核心思路是一致的:
把可视化当作一个论证过程,而不是一个装饰结果。
最后说个反直觉的
有时候,最有效的可视化技术,恰恰是减少视觉元素。
Edward Tufte那套“数据墨水比”的理论,虽然被批评过于极端,但核心洞察是对的:每一滴墨水都应该传递信息。去掉网格线、去掉背景色、去掉三维效果、去掉不必要的图例——剩下的,才是数据本身。
但别走火入魔。极简到失去语境,也是另一种误导。一张没有任何标注的散点图,谁知道X轴是时间还是温度?
分寸感。这东西没法量化,只能靠经验和对数据的理解去拿捏。
所以回到开头那个交通轨迹图的例子。后来我建议他们做了两件事:一是用密度等值线代替原始散点,消除采样密度的影响;二是在图注里说明数据采集方式,并标注早晚高峰的采样量差异。改完之后,结论确实变了——早晚高峰的拥堵范围差异,没有之前看起来那么大。
图还是那张图,数据还是那些数据。但认知的陷阱,被填上了一些。
这大概就是数据可视化技术最迷人也最危险的地方:它离真相很近,也离幻觉很近。