光在算,电在管:光学计算技术的现实折返
光计算又热了。不是第一次。上世纪八十年代的光学数字计算机、九十年代的光互连实验、近年的光子矩阵乘法芯片,潮汐来回。真正的新变量,是AI训练与推理把互连带宽和能耗推到铜线难受的位置。于是光被重新请回机房。它不是来替代电子的——更准确地说,光学计算技术正在寻找一块电子不擅长、光又付得起代价的地带。
算力焦虑撞上铜线的墙
电子计算的核心矛盾并不神秘:计算单元越快,数据搬运越像堵车。冯·诺依曼结构里,存储与计算分离,缓存层级越深,能量越多花在“搬”而不是“算”上。铜互连的带宽密度和距离衰减摆在那里,机架内、板内、芯片间都在承压。光的好处很直接:波长复用、低传输损耗、无源互连、并行度高。可光不是免费。激光器效率、调制器驱动、探测器、温控、封装,每一项都要记账。
很多演示只把光子核心的能效拎出来讲,把DAC、ADC、激光器和校准电路放进脚注。说实话,这像只算发动机油耗,不算油箱和传动。条件很关键:光互连的能耗优势只在特定距离和带宽密度下成立;片内短距、低批量场景,铜仍可能更便宜。反例也常见:小矩阵、低并发推理,光引擎的固定开销压不下来,端到端未必划算。
 硅光光学计算芯片光电共封装截面示意图
光不是万能开关
 光不是万能开关
把光计算粗分,大致有模拟光计算、数字光计算和光互连/光交换。模拟路线用干涉、衍射或微环做线性变换,乘加在光域完成,速度快、并行高。问题也集中:非线性难做,级联难,精度受噪声、插损、串扰和器件漂移限制。数字光逻辑门则面临级联困难、恢复时间和功耗问题。光缺少易失存储,缓存与权重更新怎么办?光电转换税怎么摊?相干系统对相位敏感,温度漂移会吃掉精度;非相干系统稳健些,权重表达又受限。
这些不是细枝末节。它们决定了光计算能做什么、不能做什么。可重构性、校准复杂度和软件栈,往往比单个器件指标更能决定系统是否可用。
真正先落地的,可能不是“光CPU”
工程上更现实的路径是光电混合:光做线性部分,电做非线性、存储、控制与调度。共封装光学先解决互连,光计算加速卡再切推理中的固定线性层、卷积或特定变换。MZI阵列、微环阵列、衍射光学网络各有适用条件,代工PDK、封装良率、测试方案和激光器寿命却绕不开。热管理是硬约束,温控不只是实验室里的旋钮。标准与生态也重要,缺少可复现基准,演示容易停在峰值指标。
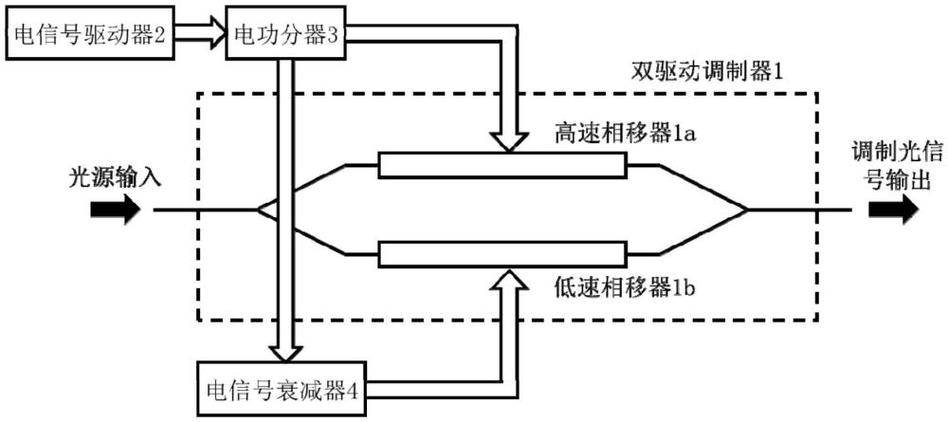 马赫-曾德尔调制器阵列光学矩阵乘法架构图
精度、噪声与转换税
模拟光计算的有效位数受信噪比、调制器线性度、探测器带宽和ADC分辨率共同限制。训练阶段可在数字端补偿,推理阶段却要面对温度、老化和批次差异。MZI阵列规模增大,校准复杂度上升;微环对温度敏感,需要锁定。权重写入慢,适合静态权重;频繁更新权重,电方案更稳。全光非线性有可饱和吸收、半导体光放大器等路径,功耗和噪声又回来了。所谓“零功耗”不成立,光计算更多是功耗搬家,不是功耗消失。
边界比愿景更重要
如果应用是固定矩阵、高吞吐、低精度容忍,光有空间;如果要求高精度通用计算、频繁权重更新、复杂控制流,电仍更稳。风险在于过度承诺:把互连优势说成通用算力优势,把核心功耗说成系统功耗。趋势大概率是渐进的——光互连先规模化,光计算核心在特定加速器里找位置。边界说清楚,比堆愿景更有用。光在算,电在管,这个分工可能比“全光计算”更接近工程现实。