量子算法研究:从Shor到表面码,论文热背后的冷思考
先泼盆冷水。量子算法研究这两年热得发烫,但热的是论文标题,不是机房里那台嗡嗡响的稀释制冷机。上周跟一个做超导的朋友吃饭,他说组里新来的学生张口就要“实现量子优势”,他差点把筷子放下:你先把读出错误率压到1%以下再聊。对吧,这就是现状。
我不反对乐观。可量子算法研究最怕两种人:一种把Shor算法当万能钥匙,一种把VQE当毕业捷径。前者以为量子计算机明天就能破RSA,后者以为跑个小分子就算落地。都偏了。
量子算法研究,不是只有Shor和Grover
先纠正一个常见误解。Shor算法解决的是大整数分解和离散对数,威胁公钥密码,但它需要容错量子计算机。不是现在这种带噪声的中等规模量子设备。资源估算摆在那儿:要分解一个2048位的RSA模数,物理比特需求是百万级甚至更高,具体数字取决于纠错码、门保真度和编译效率。别听发布会上的“量子优势”四个字就上头。
Grover算法给的是平方级加速。搜索N个条目,经典要N次,量子要根号N次。平方加速有用,但没到颠覆一切的程度。很多人把它吹成“指数加速”,这是误读。指数加速的算法当然有,比如量子傅里叶变换相关的那些,但条件苛刻。量子算法研究里,条件比结论重要。
还有一类被低估的方向:量子模拟。用可控量子系统模拟另一个量子系统,比如分子电子结构、材料磁性、高温超导模型。这类问题经典计算机算不动,量子计算机天然对口。不是所有量子算法研究都要冲着密码学去。量子化学和材料模拟,可能是更早摸到实际价值的赛道。
 量子算法研究变分量子线路噪声示意图
NISQ的真相:变分算法很香,也很坑
现在大部分实验组在做的是NISQ时代的混合算法。VQE、QAOA、量子机器学习,名字一个比一个响。核心思路差不多:量子线路负责制备态和测量,经典优化器负责调参数。听起来很美,对吧?
坑在噪声。变分量子算法对噪声敏感,线路一深,梯度就消失,优化器在平地里打转。这就是常说的贫瘠高原。更麻烦的是,你很难判断目标函数下降是因为算法找到了好解,还是因为噪声把信号抹平了。论文里漂亮的小规模结果,放到更大体系常常复现不了。
不过话说回来,这并不意味着变分算法没戏。错误缓解技术这两年进步很快。零噪声外推、概率错误取消、对称性验证,这些手段能把结果往真实值拉一拉。注意,是缓解,不是纠错。别把两者混为一谈。错误缓解是统计层面的补救,量子纠错才是根本性的容错。一个治标,一个治本。预算有限的时候,团队得想清楚先投哪边。
我个人的判断:短期看,变分算法在量子化学的小分子基态能量、某些组合优化的小规模实例上,还能出一些有价值的实验。但别指望它马上解决物流调度或金融风控。那些问题规模一大,线路深度和测量次数就爆炸。量子算法研究不是写个Ansatz就完事,资源账本得算到门级。
纠错才是分水岭:表面码、逻辑比特和工程账本
2024年底Google的Willow芯片让圈子兴奋了一阵。105个物理比特,表面码码距7,实验上展示了逻辑错误率随码距增加而下降,跨过了纠错阈值。这个结果的意义不在于比特数,而在于表面码把多个物理比特编码成一个逻辑比特,并且让逻辑错误率低于物理错误率。这是容错路线的关键一步。
但别急着开香槟。码距7只是小规模验证。要跑Shor算法,逻辑比特数量和码距都得往上翻很多倍。工程上还有布线、低温电子学、实时解码、门并行度一堆硬骨头。IBM、Quantinuum、中性原子阵营都在推路线图,离子阱的逻辑比特保真度漂亮,中性原子在规模和连接性上有想象力,超导在速度和集成度上占优。没有哪条路线已经稳赢。量子算法研究必须跟硬件路线一起看,脱离硬件的算法论文容易飘。
 量子纠错表面码逻辑量子比特阵列示意图
这里有个经常被忽略的点:资源估算是量子算法研究的硬通货。一篇算法论文如果只给渐近复杂度,不给物理比特数、门数、测量次数、运行时间,工程团队没法评估。现在好的工作都会做端到端编译,把算法映射到具体硬件拓扑,算上纠错开销。这个趋势是对的。别再拿“多项式加速”四个字糊弄人。常数因子和纠错开销能把优势吃干净。
行业动态:谁在领跑,哪些热闹别当真
超导这边,Google用Willow证明纠错阈值不是纸上谈兵。IBM走模块化路线,Heron处理器加上量子中心架构,强调可扩展和软件栈。Quantinuum的离子阱在逻辑比特和保真度上很能打,随机线路采样和逻辑门基准经常刷榜。中性原子方面,QuEra和哈佛、MIT的合作在256原子规模上做逻辑比特操作,重排和并行控制是亮点。中国团队在玻色采样、超导和离子阱上也有进展,九章系列和祖冲之系列值得跟踪。
热闹的地方也不少。量子机器学习被过度包装,很多论文在经典数据上做小规模实验,优势不明显。量子优势的采样任务有科学价值,但离实用还有距离。还有一类“量子启发算法”,本质是经典算法,别硬蹭量子。量子算法研究需要诚实:能做什么,不能做什么,资源多少,基准是什么。缺了这些,就是营销。
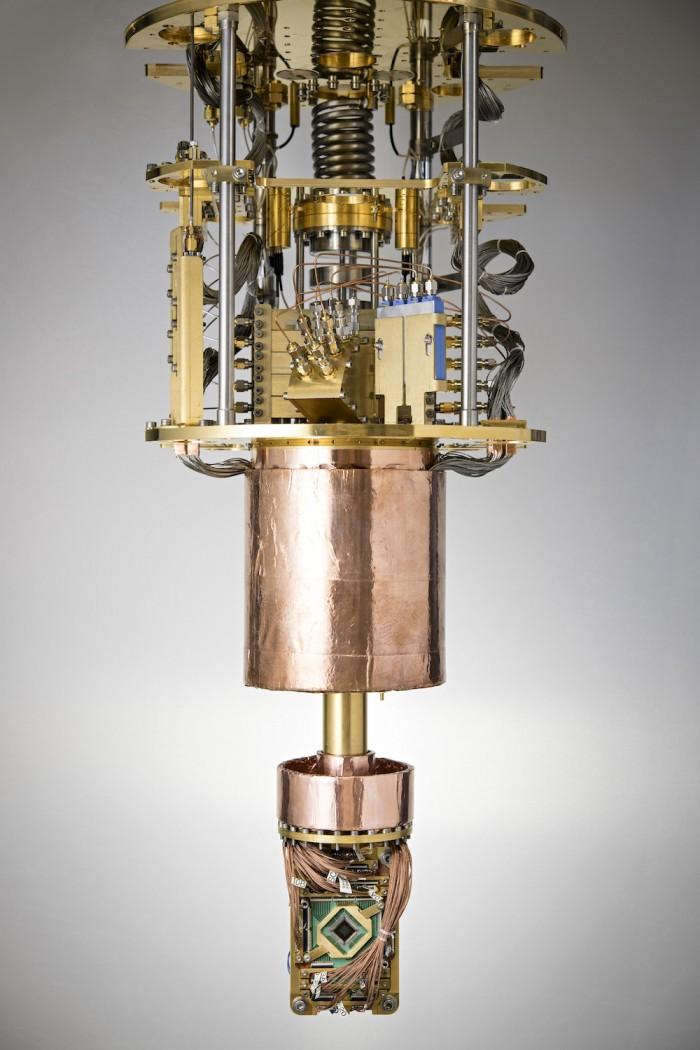 超导量子计算机稀释制冷机内部结构实拍图
如果你要做量子算法研究,先算三笔账
第一笔,问题账。你的问题经典算法真的算不动吗?还是只是慢一点?如果经典启发式能在可接受时间内给出够好的解,量子方案很难有生存空间。第二笔,资源账。需要多少逻辑比特、多深线路、多少次测量?纠错开销乘上去,还剩下多少优势?第三笔,基准账。跟谁比?比到什么规模?别只挑对自己有利的小实例。
说实话,量子算法研究现在最缺的不是新Ansatz,也不是新损失函数,而是可复现的基准和端到端资源分析。实验组和理论组得坐在一起,把噪声模型、编译策略、读取错误都摊开算。否则论文里的加速,到了机房就变成噪声。
最后给个不太讨喜的结论:量子算法研究正在从“找加速”转向“算成本”。这是好事。泡沫会挤掉一批,真正有用的东西会留下。你要问我现在值不值得入局?值得,但别冲着短期落地去。把线性代数、量子纠错、经典优化和硬件约束都啃一遍。剩下的,交给时间和实验。