软件工程开发:四十秒看完一个 PR,你在评审什么?
说实话,我以前挺怕代码评审的。
不是怕别人挑出 bug,是怕那种气氛——你提交了一百多行改动,结果评审的人花了三分钟看完,回了一句“看起来没问题”。你也不知道他到底看没看,反正“看起来”这个词就挺暧昧的。
后来我自己做评审,才慢慢明白这件事有多拧巴。今天想聊的就是软件工程开发里这个最容易被低估、也最容易被搞砸的环节:代码评审。
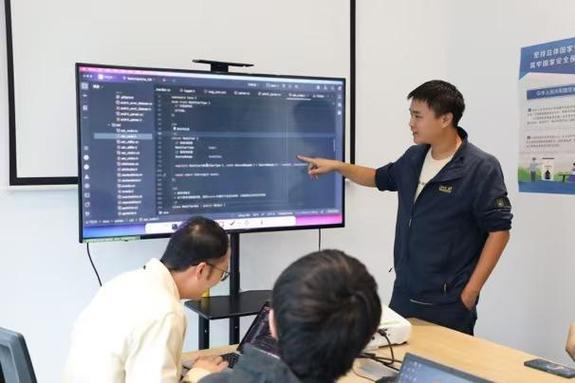 软件工程代码评审会议现场
那次上线前,我盯着评审记录看了十分钟
 那次上线前,我盯着评审记录看了十分钟
前东家有个项目,发布前照例要走评审流程。我打开记录一看,好家伙,二十多个文件,每个文件都有人点了“通过”,平均停留时间——我后来专门查了一下——不到四十秒。
四十秒。一个三百行的改动,四十秒看完,还给出了“LGTM”。
我问其中一个同事,你看了啥?他说,看了文件名和工作描述,觉得差不多就过了。
这不叫评审,叫打卡。
问题是,这种场景太普遍了。很多团队把代码评审当成软件工程开发里的一道工序——就像过安检,包往传送带上一放,人走过去,至于包里有什么,没人真关心。
但代码评审本该是软件工程开发里性价比很高的质量手段。你不花额外的机器成本,不增加构建时长,就是一个人看另一个人的代码,就能把不少问题挡在上线之前。
所以,问题不是“要不要评审”,而是“为什么评审总是失效”。
代码评审到底在评什么?
很多人以为代码评审就是找 bug。不全是。
我总结下来,代码评审大概在四个方面起作用(这四件事的重要性依次递减):
第一,防止“逻辑炸弹”。就是那种能跑、测试也能过、但某些边界条件下会爆的代码。比如空指针、资源泄漏、并发死锁。这类问题很难靠测试全覆盖,但人眼有时候能看出来。
第二,保证可读性。这是最容易被低估的。一段代码写得绕,三个月后连作者自己都不认识。代码是给人看的,顺带让机器执行。评审时发现“这段逻辑能不能拆分一下”“这个变量名是不是太抽象了”,其实比揪出 bug 更有长期价值。
第三,传递上下文。软件工程开发有个尴尬现实:很多决策的背景信息只存在于某个人的脑子里。评审时讨论“为什么这么改”,其实是在把这种隐性知识显性化。
第四,统一风格。这条最不重要,但最容易被当成评审的核心。tab 还是空格,函数名用动词还是名词——这些玩意有工具帮你管,不需要浪费人的精力。
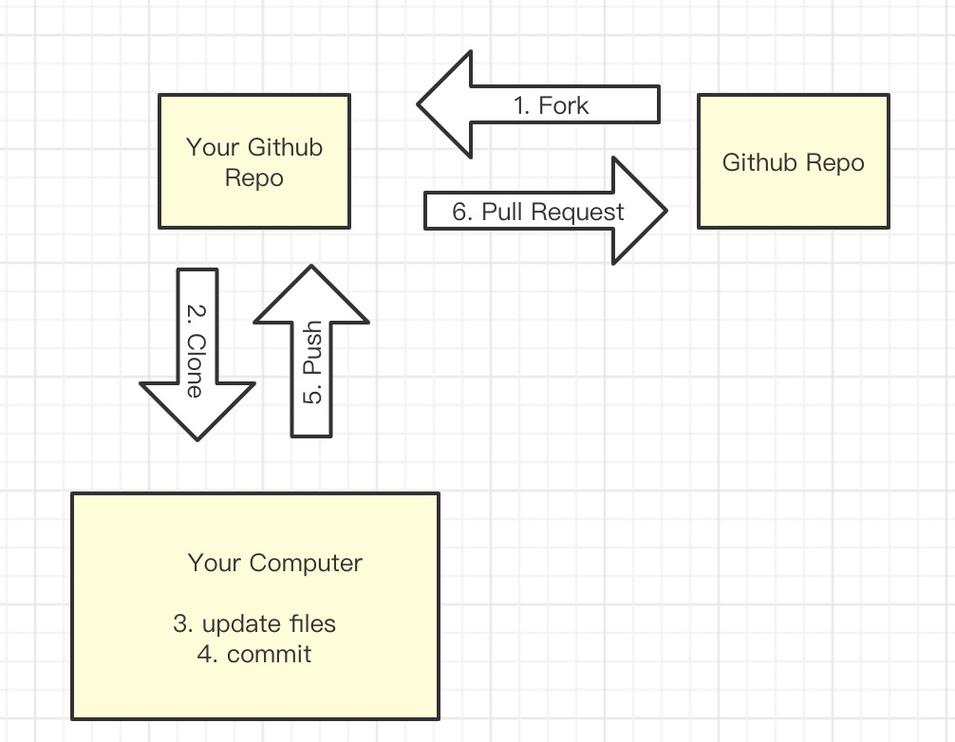 软件开发Pull Request代码差异对比截图
说到这里,得插一句:很多团队的评审之所以失效,就是把重心放错了地方。评审变成了“格式审查”,而真正该盯的逻辑问题、边界条件、可读性,反而没人看。
我见过一个团队,评审工具上挂了几十条 comment,点开一看,全是“这里多了一个空格”“这个换行不太对”。你说这种评审,除了让人不想再提 PR,还有什么用?
为什么大多数评审变成了走过场?
 为什么大多数评审变成了走过场?
这里有几个绕不开的原因。
第一,评审者和作者的权力关系不对等。
你让一个 senior 去评审 junior 的代码,junior 大概率不敢提什么反对意见,只能点头。反过来,junior 评审 senior 的代码,那就更难了——你让一个刚入职的人去说“你这个设计有问题”,他得有多大勇气?
所以很多时候,评审变成了“向上确认”而不是“双向讨论”。作者等一个“通过”,评审者给一个“通过”,双方都松了一口气。
第二,评审的颗粒度太大了。
一个 PR 改了八百行,你让评审者怎么认真看?人脑不是编译器,连续看八百行差异,到后面注意力必然涣散。我自己的经验是,超过三百行的 PR,评审质量断崖式下跌。
所以有些团队搞“小步提交”,每次只改一小块。这招有用,但前提是团队真的能忍住不攒大活。说实话,很难。尤其是赶进度的时候,谁还顾得上拆分?
第三,评审缺少明确的检查清单。
你打开一个 PR,对面写着“重构了用户服务”,你从哪看起?如果没有一个共识的清单,每个人的评审重点都不一样——有人盯命名,有人盯逻辑,有人干脆只看测试有没有过。
我觉得一个实用的评审清单大概长这样:
这段代码放在整个系统里,会不会引入意外的副作用?(这个最重要,但也最难判断)
边界条件有没有处理?空值、零值、超长输入、并发场景。
错误处理是不是完整?异常有没有被吞掉?
可读性:函数是不是太长?命名有没有歧义?
测试:改动有没有对应的测试?测试是不是在测真正的行为?
你看,这个清单里没有“格式”这一项。格式交给工具,人做工具做不了的事。
第四,评审没有反馈闭环。
很多团队评审完了就完了,没有统计、没有复盘、没有改进。哪个模块的评审 comment 最多?哪类问题反复出现?没人关心。评审变成了一个黑盒,进去的是代码,出来的是“通过”,中间发生了什么,没人知道。
评审的边界:有些事它管不了
这一点很多人不爱听,但我觉得必须说。
代码评审管不了架构问题。你盯着一个函数看,看不出整个模块的分层有问题。评审管不了性能问题——一段 O(n²) 的代码,人眼很难判断它在数据量涨十倍之后会怎样。评审也管不了需求本身的合理性——你评审的是“代码写得对不对”,不是“这个功能该不该做”。
所以,别把代码评审当成万能药。它是软件工程开发质量体系里的一环,但不是全部。单元测试、集成测试、静态分析、灰度发布——每一环都有自己的职责。评审的独特价值在于:它是唯一一个能在“人”的层面传递判断力和经验的环节。
换句话说,机器能帮你查语法错误,但机器没法告诉你“这段代码三个月后你会想杀了现在的自己”。
回到开头那个场景。四十秒看一个 PR,点个通过,然后继续干活。这件事的问题不在于某个人偷懒,而在于整个团队对评审的预期就是“走个流程”。
如果你想让代码评审真正起作用,可能需要做几件事:
把 PR 拆小。三百行以内,超过就拆。这不是为了好看,是为了让评审者能真的看进去。
写清楚描述。你在 PR 里写清楚“改了什么、为什么改、有哪些风险点”,评审者才知道该往哪看。
定一个轻量的清单。不用多,四五条就行,但每条都得是机器查不出来的东西。
评审完了聊两句。哪怕只是“这个地方我有个疑问”,也比默默点通过强。
代码评审不是仪式,是对话。软件工程开发里,很多问题不是技术问题,是协作问题。评审就是一个微缩的协作现场——你怎么对待别人的代码,别人就怎么对待你的。
所以下次评审的时候,别急着点“通过”。多看两眼。真的,多看两眼。