别把工业互联网平台做成大号看板:从数据入口到控制闭环的硬约束
一个很常见的现场:大屏上红黄绿闪烁,产线一停,值班工程师还是抓起电话找PLC厂商。平台在。数据也在。闭环没有。
说实话,这个画面我看过太多次。工业互联网平台进入生产系统时,绕不开的不是“上不上云”,而是数据能不能可信地进来、指令能不能安全地回去、出了事谁负责。这三个问题不解决,平台就很容易退化成一套昂贵的报表系统。
数据入口不是插上网线就完事
很多项目在采集层就埋了雷。车间里Modbus、OPC UA、私有串口协议、厂商加密协议混在一起,边缘网关能连通,不等于数据可用。时间戳来自不同时钟,量程和单位各自为政,设备状态字没有语义解释——这些脏活不干,后面的模型全是沙上建塔。
采集频率、时间戳、量程和单位不统一,后面的模型全是沙上建塔。比如一台关键轴承,只上传每分钟的振动均值,峰值信息丢了,故障特征也跟着丢了。反过来,所有测点都做毫秒级高频采集,网络和存储成本会迅速失控。工程上得做分级:关键设备高频、短缓存、边缘预处理;非关键设备低频、批量上传。断点续传和时钟同步不是可选项,是底线。
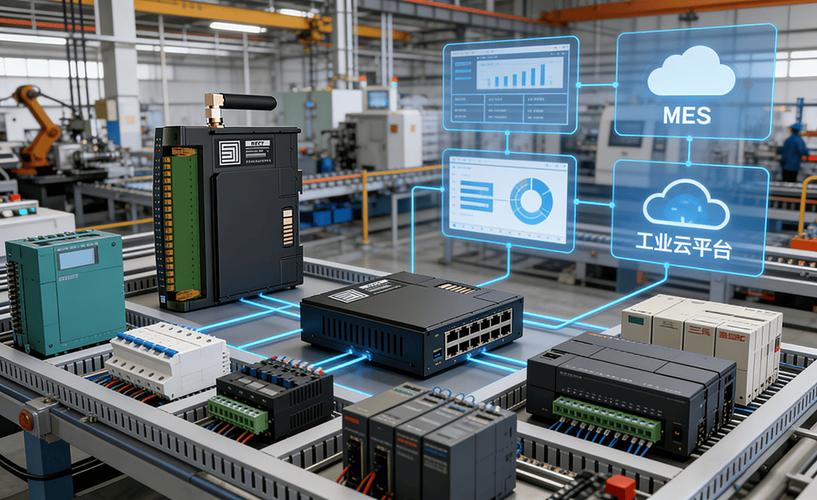 工业互联网平台边缘网关连接PLC与机床传感器的现场照片
还有一个常被忽略的点:数据入口必须带上下文。同一条产线换型后,工艺参数、物料批次、设备维护记录要能对齐。否则平台只能看到“电流升高了”,却说不清是刀具磨损、材料变化还是操作员改了配方。上下文缺失,分析结果就很容易变成猜谜。
控制闭环卡在毫秒和责任之间
把实时控制放到公有云上,听起来很顺,实际很险。网络抖动一次,指令晚到几十毫秒,高速产线可能已经撞了。不是云不能做控制,而是要看工艺窗口。运动控制、安全联锁、急停回路,这些场景对确定性和功能安全的要求,远高于普通数据上报。
实时控制更适合留在边缘侧,云侧承担训练、排程和跨厂优化。这个分工听起来不新鲜,难的是边界怎么划。比如视觉质检,边缘做推理,云上做模型迭代;AGV调度,边缘做局部避障,云上做全局路径优化。条件也很清楚:边缘节点要有足够的算力冗余,规则变更要能回滚,网络断开时产线不能跟着停。
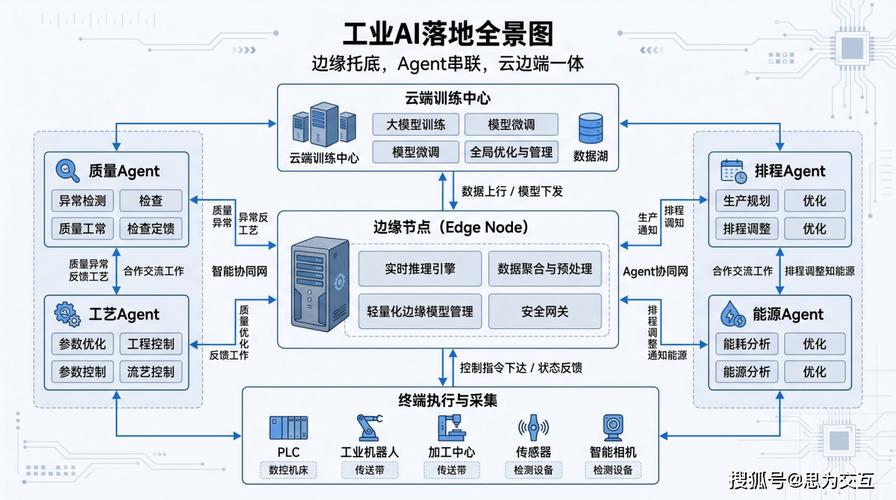 工业互联网平台云边协同控制闭环示意图
反例不少。某工厂把PLC逻辑改成平台下发规则,演示时很顺,换型时规则冲突,现场工程师不敢改,只能绕回原系统。问题不在平台笨,而在权限、版本和回滚机制没设计好。控制闭环不是“能发指令”就结束了,它要能证明:谁在什么条件下改了哪条规则,出了问题怎么切回安全状态。对吧?这部分很枯燥,但它决定平台能不能碰生产。
孪生模型别停在好看
数字孪生很容易做成三维动画。设备模型转起来,颜色跟着状态变,参观时很抓眼球。可一旦要它回答“当前偏差来自模型、传感器还是工况变化”,很多孪生体就哑了。
孪生要能回答“当前偏差来自模型、传感器还是工况变化”。这要求机理模型和数据模型一起校准:边界条件、材料参数、传感器漂移、维护记录,都得进入闭环。纯数据驱动在稳定工况下表现不错,工况一漂移,残差就放大。纯机理模型又可能太理想,现场粉尘、磨损、批次差异都不在方程里。比较务实的做法是混合建模,加上漂移检测和人工复核。别嫌慢。工业现场本来就不相信“一次训练永久有效”。
 工业互联网平台时序数据库与数字孪生模型校准流程图
不过话说回来,模型再准,也要有人用。很多平台把预测结果推给班组,班组看一眼就关掉,因为不解释、不给处置建议、不接入工单。模型的可信度不是靠准确率一个数字建立的,是靠一次次“它提醒对了,并且我知道下一步做什么”积累的。
谁为停机负责,决定平台能走多远
 谁为停机负责,决定平台能走多远
平台建设走到深处,技术问题会变成组织问题。OT工程师关心稳定,IT团队关心集成,采购关心单价,供应商关心锁定。停机损失一算,责任边界就浮出来了。平台合同里如果只写“可用性”,不写“控制权限、变更流程和故障切回”,停机时一定扯皮。
平台合同里如果只写“可用性”,不写“控制权限、变更流程和故障切回”,停机时一定扯皮。所以采购指标得改。少看连接了多少设备,多看关键回路有没有闭环、异常处置有没有记录、模型迭代有没有审计。安全上也别只做边界防火墙,OT网络分区、白名单、供应链准入,这些老办法仍然有效。趋势是边缘智能和行业信息模型标准化,但标准化不会自动解决责任归属。
说到底,工业互联网平台的价值不在大屏多亮,而在它能不能进入生产系统的硬约束里:数据可信、控制可控、责任可追。如果一个平台连“谁能在几点几分改哪条规则”都说不清,它的智能只是演示。