量子算法研究:别急着跑Grover,先看看线路编译的黑洞
模拟器里是天堂,芯片上全是收费站
上周三晚上十一点,南京仙林。实验室空调嗡嗡响,我盯着屏幕上一组QAOA的采样结果,心里发毛。模拟器里,MaxCut的近似比曲线漂亮得像教科书。切到真机,保真度啪一下掉到地板上。不是算法错了。是线路一编译,SWAP门像收费站一样排出来,深度翻了几倍,噪声顺手把相干性啃掉。我当场想把咖啡杯扣在键盘上。真烦。
这就是量子算法研究里经常被论文摘要藏起来的那层脏活:算法不是只在纸面上跑,它要变成门序列,落到具体芯片的耦合图上。说实话,很多demo在模拟器里能过,在硬件上过不了,不是物理不行,是编译和噪声账没算清。
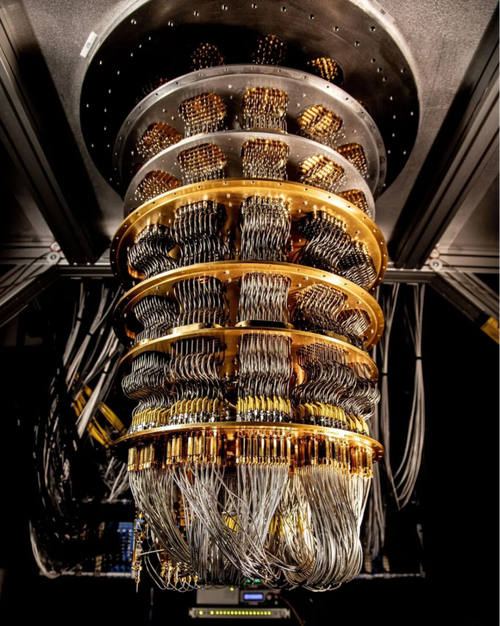 超导量子芯片稀释制冷机内部布线实拍
算法到底在算什么:干涉、测量、重复
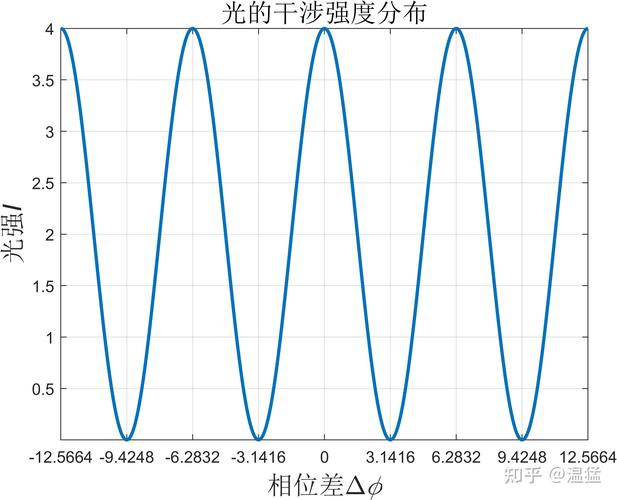 算法到底在算什么:干涉、测量、重复
先把话掰直。量子算法研究不是把经典代码加个q。量子比特可以处于叠加态,两个量子比特还能纠缠;算法通过一系列量子门让概率幅发生干涉,把想要的答案的振幅抬高,不想要的压低;测量只吐出一个经典结果,所以要重复跑。Grover搜索是平方加速,Shor分解利用周期查找,VQE和QAOA是变分路线。听起来很爽,对吧?
但干涉很娇气。门错误、退相干、读取错误,任何一样都能把干涉条纹抹平。... 量子算法研究真正难的,不是写一个哈密顿量,而是让线路在噪声下还能保留那点相位信息。
编译这层脏活,决定论文能不能落地
我拿一个具体切口说:把MaxCut映射到超导芯片。问题图往往是全连接或稠密连接,硬件耦合图是稀疏的,通常是近邻连接。怎么办?插SWAP。每插一个SWAP,三个CNOT起步,还增加深度。... 我见过一个玩具问题,逻辑线路几十个双比特门,映射完变成几百个,深度拉长,保真度从0.9几掉到0.6附近。这个落差,评审不会替硬件买单。
还有T门。表面码纠错里,Clifford门相对便宜,T门要靠魔态蒸馏,资源开销像滚雪球。资源估算一算,逻辑量子比特数、码距、蒸馏工厂、时间预算,全都要进模型。量子算法研究如果只报逻辑门数,不报物理资源,基本等于把账单藏起来。
 量子算法线路编译SWAP映射示意图
误区与边界:别把qubit数当战斗力
常见误解有几个。qubit多就强?不一定。耦合、保真度、连通性、读取、控制电子学,任何短板都能卡住。叠加就是并行?也不是。测量会坍缩,重复采样有统计成本。模拟器跑通就算量子算法成功?差得远。还有,量子计算机不是GPU加速卡,不是所有任务都能无脑搬上去。
边界也要说清。NISQ阶段,短深度、特定采样、含噪优化,可能先有实验价值;通用容错路线还要啃纠错阈值、码距扩展、实时解码。风险在密码学迁移、供应链、人才泡沫,也在过度承诺。... 我不反感炒作,我反感把编译和纠错成本藏起来。
收束:先把脏活写进论文
 收束:先把脏活写进论文
所以我现在看量子算法研究,先看三件事:线路深度、物理资源估算、噪声模型。没有这三样,曲线再漂亮我也不敢信。... 量子算法研究要往前走,得有人愿意蹲在编译器和控制软件里,把每个SWAP、每个T门、每次测量都算清楚。路还长。但总得有人先干脏活,对吧?