隐私计算技术的隐性成本:威胁模型错配与效用断崖
谈隐私计算技术,很容易滑进两种叙事。一种是合规口径下的万能钥匙,一种是工程现场里的性能灾难。两边都不太诚实。
麻烦之处在于:这套技术栈里没有哪一种是通用的。每一种都有明确的威胁模型,越界即失效。而实际选型往往反过来——先定名词,再补论证。顺序一旦颠倒,后面投进去的钱基本是沉没成本。
三条路线,回答的其实是三个不同的问题
多方安全计算处理的是“参与方互不信任,但仍要联合算出一个结果”这件事。秘密分享、混淆电路、不经意传输,这些原语把安全性做成了可形式化证明的东西,这是它最硬的地方。代价是通信。两方半诚实模型下的隐私求交,集合规模推到千万级,基于 OT 扩展的协议通信量轻松上到 GB 量级;换成恶意安全模型,开销再涨一到两个数量级,通信轮数也跟着涨。很多方案在半诚实模型下写得漂亮,一到恶意模型就没了脾气。
联邦学习严格说不是密码学技术。它的安全承诺建立在一个朴素假设上:只传中间量,原始数据不出域。这个假设在 2019 年被梯度反演击穿,图像级别的重建成为可能。后来的补丁是安全聚合、梯度裁剪、加噪,但每一个补丁都在拿效用换。得说清楚,这是工程约束,不是理论瑕疵。
差分隐私走的是另一条道。它不隐藏数据,而是给输出注入噪声,用隐私预算 ε 刻画泄露上界。数学上干净,组合定理也好用。问题出在 ε 的取值:ε=1 和 ε=10 在业务侧的感知差得非常远,在合规侧却同样可以自称“已采用差分隐私”。一个没有公认阈值的参数,很难承担审计功能。
还有一条常被混进来的:可信执行环境。它靠硬件信任根划出一块飞地,性能接近明文。但 Foreshadow、Plundervolt 这一串名字不是学术圈的自我消遣,它们说明飞地边界在微架构层面可以被绕过。远程证明证明的是“某段代码在某型号硬件上跑过”,不是“这段代码没有漏洞”。
把不同威胁模型下的技术拼进同一个方案,是落地失败最常见的原因。混淆电路默认半诚实,飞地默认硬件可信,差分隐私默认攻击者只看得到输出——这些假设之间的强度不可比,叠在一起不是取交集,而是各说各话。安全证明的链条断在接缝处,偏偏接缝最不容易被看见。
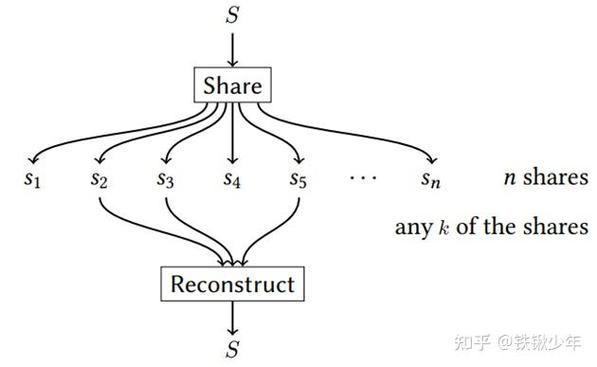 多方安全计算秘密分享协议数据分片流程图
效用不是线性衰减,是断崖
隐私预算会被组合消耗。同一份数据上跑十次查询,预算按基本组合定理叠加,要么 ε 迅速膨胀,要么噪声加到业务无法忍受。这个账在单次实验里看不出来,上线三个月之后才显形。
差分隐私在低维统计上表现相当好——均值、直方图、频次分布,加上合适的噪声校准,误差可控。但迁移到高维模型训练就完全是另一回事。梯度维度动辄上亿,要在这样的空间里保证 (ε, δ)-差分隐私,噪声尺度会把收敛直接打断。有人用维度约减、用小批量采样来缓解,本质仍是在效用和预算之间找一条很窄的缝。
联邦学习的问题更碎。客户端数据非独立同分布时,本地模型漂移,全局聚合震荡,几十轮不收敛是常态。通信压缩(量化、稀疏化)能省带宽,但压缩后的梯度与注入的噪声之间会相互作用,这种交互目前研究得并不充分——它可能放大噪声对收敛的伤害,也可能意外削弱隐私保证。没人敢给出普适结论。
密态计算的性能断崖则更直白。同态加密的密文膨胀与乘法深度限制,使得复杂模型的推理成本比明文高出数个量级;把模型转成电路的过程中,非线性激活函数是长期的技术债。
大量项目在验证阶段表现良好,原因是数据规模被压小了两个量级,参与方被假设为守规矩。这两条一旦放开,指标会掉得很难看。
 联邦学习梯度聚合安全通信架构示意图
合规说“匿名化”,技术说“不可能”
 合规说“匿名化”,技术说“不可能”
法律文本里的匿名化是一条结果标准:无法识别、不能复原。技术侧给不出这样的保证。k-匿名会被链接攻击破,差分隐私给出的是一个概率上界而不是“不可能”,去标识化与匿名化在监管口径中的边界,各国也不一致。
于是出现一个尴尬局面:合规需要一句确定的话,技术只能给一个带条件的判断。ε 取多少算匿名?“无法复原”在什么攻击能力下成立?这些问题的答案取决于威胁模型,而威胁模型不在合规文档里。
更现实的一层是责任划分。出了事,是算法提供方、数据持有方,还是集成方?可验证计算和零知识证明在这里有真正的用武之地——不是为了炫技,而是为了留下可被第三方核验的执行证据。这个方向的价值,眼下被严重低估。
能跑起来的方案长什么样
 能跑起来的方案长什么样
不是选一种技术包打天下。按数据敏感度和计算类型分层,是更务实的做法:高敏数据的高频统计走密态或飞地加速,跨机构的集合对齐走隐私求交,模型训练走联邦加安全聚合,对外发布的统计结果走差分隐私。层与层之间的接口要能说清楚各自的假设,别让强度不同的承诺混在一个安全声明里。
硬件信任根的定位也该改一改。把它当性能加速器可以,当安全边界不行。真正的边界还得由密码学协议来守,硬件负责把成本压到业务能接受的水平。
另一个容易被忽略的点:隐私计算保护的应当是跨界的那一小段数据流,而不是把整条数据链路都加密。范围划得太大,效用断崖会提前到来;划得太小,保护形同虚设。这个边界怎么切,没有通用答案,只能一案一议。
说到底,这项技术的成熟度被高估了,而它的适用边界被低估了。前者导致承诺过度,后者导致选型草率。真正需要的不是更多方案,是更诚实的评估——把威胁模型、数据规模、性能预算三件事摊在桌面上,先算清楚代价,再谈方案。