系统科学方法的分寸感:从耦合结构到可验证边界
某地“智慧交通”项目复盘会上,模型预测拥堵下降18%,上线三个月后主干道排队长度反而上升。不是算法突然失灵,而是边界设错:通勤者改路线、网约车重新巡游、信号配时被人工干预。你看,系统科学方法一旦离开边界与验证,很容易退化成精致的叙事。这里不讨论玄学,只讨论可操作的约束。
先别急着画方框图
系统科学方法常被简化为“画框、连线、加箭头”。概念模型当然有用,但边界划定先于建模。边界至少包含空间、时间、主体、制度四层。做政策评估,观测期要覆盖行为响应周期;时滞长于观测期,结论只能写成短期关联,不能写成稳态效果。反例并不稀缺:园区交通模型未纳入网约车空驶巡游,预测自然偏乐观。类似地,把“拥堵”简化为平均速度,会掩盖排队长度和旅行时间第85分位的差异。指标选择不是技术细节,变量代理与可观测指标决定模型能回答什么问题。
 城市交通政策评估系统动力学因果回路与边界示意图
边界一改,结论就变。这不是模型脆弱,而是系统对象本身有制度嵌入性。把收费、补贴、限行当作外生参数,短期能算;一旦出行者适应、平台调价、地方执法强度变化,参数就内生化了。条件写清楚,比给一个漂亮数字更难,也更有用。
反馈不是道德判断
反馈回路常被写成“正反馈坏、负反馈好”。不对。正反馈是放大机制,负反馈是纠偏机制,二者都不自带价值判断。供应链牛鞭效应就是典型:需求小幅波动沿层级放大,库存策略、提前期、批量补货共同决定幅度。只盯末端库存,会误判波动来源。方法上可走因果回路图加库存规则仿真,再做敏感性分析;条件是主体异质性、信息延迟和补货批量要能观测或合理假设。风险在于把相关性当反馈,把同步波动当因果链。某快消企业把促销峰值当趋势,扩产,后来库存积压——这很常见,也很贵。
分解之后,接口才是难点
 分解之后,接口才是难点
层级分解能降低认知负担,子系统模型也便于分工。但分解降低认知负担,但涌现来自交互。把城市交通拆成信号控制、路网容量、出行行为三块,各自都合理,接口变量一旦丢失,拼接起来就是伪精度。条件很硬:接口变量要可观测,交互项要有行为解释,子模型时间步要能对齐。实现路径可以写成问题结构化、概念模型、可计算模型、校准验证、情景实验、决策接口,但它不是流水线,而是反复回退的迭代。风险也在这里:指标替代目标,部门接口替代系统反馈,模型越做越细,问题却越跑越偏。
模型校准是脏活,可信度在这里
建完模不等于完成。校准与验证决定模型能不能进入决策。校准不是把参数调到历史曲线好看,而是让参数有行为解释。回溯测试要留出后验期;情景压力测试要覆盖极端但合理的外生冲击;专家评审要能指出结构遗漏;敏感性分析要报告结论翻转的阈值,而不是只给一张龙卷风图。数据粒度与模型时间步不匹配时,参数会互相补偿误差:用年度数据校准日尺度客流模型,拟合优度可能不错,外推却容易漂。拟合优度不能替代外推能力,这是系统分析报告里常被省略的一句。
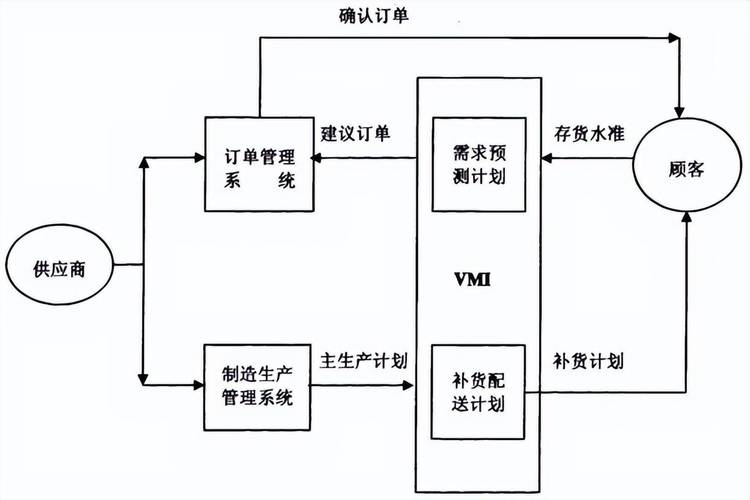 供应链库存多主体仿真校准与敏感性分析流程图
还有数据泄漏。把政策实施后的数据混进校准期,模型会“提前知道答案”。看起来准确,实际不能用于事前评估。黑箱模型可以参与探索,但进入公共决策前,至少要给出可解释的结构假设和失效条件。否则,模型越复杂,责任越模糊。
边界比结论更值得写进报告
系统科学方法适用于强耦合、非线性、时滞、多主体适应的问题;不适用于边界开放到无法观测、数据质量无法支撑、制度变量频繁突变的情形。数字孪生、因果推断、参与式建模都在推进,但技术趋势不取消验证义务。一份报告如果没写清模型不适用什么情形,它的结论就只是一张精密的便签。写边界,写反例,写阈值。条件变了,结论就得重算。