当“知道一点”成为风险:公众科学素养提升的边界与脚手架
在南京一场社区疫苗咨询会上,一位家长能准确说出mRNA,却把“信使”理解成“修改基因的开关”。现场没人笑。问题也不在记性。公众科学素养提升最容易被简化成“多讲点科学”,可真实困境是:术语被记住了,概念结构却没有跟上;结论被转发了,证据链常常缺席。风险感知倒是很快,概率判断却慢半拍。说实话,这很要命。
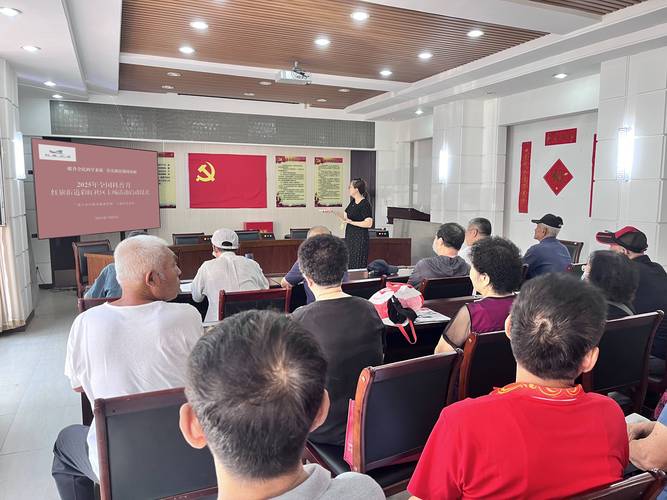 社区科普讲座公众提问现场照片
更麻烦的是来源监控。短视频里的科学表达常把“有研究提示”剪成“已经证实”。公众若没有来源追溯习惯,就会把语气强度当成证据强度。这里的关键不是让人人读论文,而是训练三个动作:找原始来源、看样本与限制、问谁受益。条件也有限制——在健康焦虑高、时间紧的场景里,完整核查很难发生。所以科普文本必须把“不确定”写在显眼处,而不是藏在脚注。
 中小学科学实验课堂学生操作显微镜
应用边界也要说清。科普不是说服术。把“提升素养”做成“接受某结论”,短期有效,长期透支信任。反例并不少:只讲结论、不讲代价,一旦出现例外,公众会转向整体怀疑。更稳妥的做法是公开证据等级、利益冲突和适用条件。比如讲空气质量数据,要说明监测点位、仪器误差和短期波动;讲营养研究,要区分观察性研究与干预试验。这些内容不炫,却是判断的脚手架。
 把素养拆成可训练的动作,而不是口号
我倾向于把公众科学素养提升拆成三类可训练动作。一是证据查找:给定一个争议话题,能在十分钟内找到原始研究或权威汇总,并标出出版时间。二是不确定性表达:能用“在什么条件下成立”复述结论,而不是只复述结论。三是反证意识:主动找一个能推翻自己判断的证据类型。这三件事都可以在社区工作坊里练,不需要高深设备。
验证方式也别只做知识题。前后测若只考名词,会奖励背诵。更有效的是情境题加延迟测试:两周后给一个新案例,看是否调用来源核查;再加行为日志,比如是否点开原始链接、是否记录搜索路径。条件限制在于,资源不足地区高度依赖本地组织者,培训质量参差。趋势上,生成式AI会进一步抬高来源验证成本,合成图像和伪文献让“看起来像”更不可靠。风险也随之而来:若把素养指标化、竞赛化,基层可能转向应试化科普,刷题替代判断。
 评估的陷阱:会答题不等于会判断
评估环节最容易走偏。问卷里问“是否相信科学”,几乎必然高分;问“是否知道双盲”,也能靠记忆。真正要测的是信息行为:遇到冲突证据时是否暂停,是否区分专家共识与单个专家意见,是否能说出自己判断的边界。这里没有简单分数,也不该拿一套指标横向比较。不同社区的知识基础、信任网络、风险暴露完全不同,强行比较会制造虚假精确。
更现实的做法是小样本、长周期、混合方法:少量深度访谈加行为观察,再配合情境测验。它慢,但能看见机制。公众科学素养提升的难点从来不是把所有人变成科学家,而是让普通人在关键决策前多一个可执行的核查动作。这个动作可能很笨:查一次来源,问一句“样本多大”,承认一次“我不确定”。笨办法往往更抗操纵。
说实话,科普供给还会继续膨胀,AI也会让内容生产更便宜。真正稀缺的是可信的中间层:能把证据等级翻译成行动建议,又愿意把限制条件放在台面上的人。这个中间层建不起来,术语越多,误判越隐蔽。
知识碎片为何在决策现场掉链子
科学素养不是事实库存。它更像一套可调用的判断装置:能不能识别变量,能不能区分相关与因果,能不能在信息不全时表达不确定性。技术原理上,这涉及工作记忆负荷、来源监控和启发式判断。公众面对健康、环境、食品议题时,往往没有时间展开完整推理,只能依赖直觉和信任线索。问题在于,碎片化知识会制造“我知道”的错觉,反而降低求助意愿。 比如PCR检测。很多人知道“扩增”,却不知道灵敏度受采样时点、病毒载量、试剂阈值共同约束。于是把一次阴性当成绝对安全。这不是智商问题,是知识结构缺少连接件。科普如果只投放术语,等于给了一堆零件,没给装配图。社区科普讲座公众提问现场照片
更麻烦的是来源监控。短视频里的科学表达常把“有研究提示”剪成“已经证实”。公众若没有来源追溯习惯,就会把语气强度当成证据强度。这里的关键不是让人人读论文,而是训练三个动作:找原始来源、看样本与限制、问谁受益。条件也有限制——在健康焦虑高、时间紧的场景里,完整核查很难发生。所以科普文本必须把“不确定”写在显眼处,而不是藏在脚注。
供给端的热闹,替代不了场景里的可验证
很多科普项目把阅读量当成效。流量当然有价值,但它测量的是触达,不是判断。算法推荐会放大情绪框架,选择性暴露让人反复看到同温层证据。此时继续加量,可能加深极化。实现路径得换:把知识嵌进具体决策节点,比如接种前咨询、家庭用药、校园实验、社区水质观察。让公众在做事中遇到概念,而不是在概念里假装做事。中小学科学实验课堂学生操作显微镜
应用边界也要说清。科普不是说服术。把“提升素养”做成“接受某结论”,短期有效,长期透支信任。反例并不少:只讲结论、不讲代价,一旦出现例外,公众会转向整体怀疑。更稳妥的做法是公开证据等级、利益冲突和适用条件。比如讲空气质量数据,要说明监测点位、仪器误差和短期波动;讲营养研究,要区分观察性研究与干预试验。这些内容不炫,却是判断的脚手架。
把素养拆成可训练的动作,而不是口号
把素养拆成可训练的动作,而不是口号
我倾向于把公众科学素养提升拆成三类可训练动作。一是证据查找:给定一个争议话题,能在十分钟内找到原始研究或权威汇总,并标出出版时间。二是不确定性表达:能用“在什么条件下成立”复述结论,而不是只复述结论。三是反证意识:主动找一个能推翻自己判断的证据类型。这三件事都可以在社区工作坊里练,不需要高深设备。
验证方式也别只做知识题。前后测若只考名词,会奖励背诵。更有效的是情境题加延迟测试:两周后给一个新案例,看是否调用来源核查;再加行为日志,比如是否点开原始链接、是否记录搜索路径。条件限制在于,资源不足地区高度依赖本地组织者,培训质量参差。趋势上,生成式AI会进一步抬高来源验证成本,合成图像和伪文献让“看起来像”更不可靠。风险也随之而来:若把素养指标化、竞赛化,基层可能转向应试化科普,刷题替代判断。
评估的陷阱:会答题不等于会判断
评估的陷阱:会答题不等于会判断
评估环节最容易走偏。问卷里问“是否相信科学”,几乎必然高分;问“是否知道双盲”,也能靠记忆。真正要测的是信息行为:遇到冲突证据时是否暂停,是否区分专家共识与单个专家意见,是否能说出自己判断的边界。这里没有简单分数,也不该拿一套指标横向比较。不同社区的知识基础、信任网络、风险暴露完全不同,强行比较会制造虚假精确。
更现实的做法是小样本、长周期、混合方法:少量深度访谈加行为观察,再配合情境测验。它慢,但能看见机制。公众科学素养提升的难点从来不是把所有人变成科学家,而是让普通人在关键决策前多一个可执行的核查动作。这个动作可能很笨:查一次来源,问一句“样本多大”,承认一次“我不确定”。笨办法往往更抗操纵。
说实话,科普供给还会继续膨胀,AI也会让内容生产更便宜。真正稀缺的是可信的中间层:能把证据等级翻译成行动建议,又愿意把限制条件放在台面上的人。这个中间层建不起来,术语越多,误判越隐蔽。