把误差当原料:供应链管理技术的硬约束与手感
预测永远不准。这句话不新鲜,但很多系统上线时还是把它当敌人。供应链管理技术的真正难点,不是把误差消灭,而是给误差定价:多备一周库存值多少钱,缺货一次伤多少客户,紧急空运吃掉多少毛利。算不清这笔账,算法越漂亮,现场越拧巴。
 仓储拣货区RFID读写器部署场景图
 制造业供应链数字孪生控制台界面截图
 算法排产落地,卡在物料与人的接口
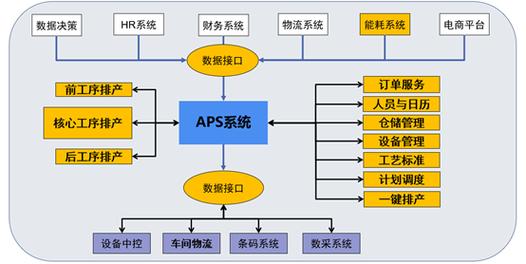
APS听起来硬核。真到车间,卡在物料齐套、工装可用、人员技能矩阵、质量放行。南京一家做精密件的小厂,排产算法跑得挺快,但供应商送货窗口一抖,计划就碎。问题不在算法笨,而在输入不稳。方法不是再买一个模块,而是把供应商承诺、在途批次、检验节拍拉进同一套事件模型。
这里有个边界:订单批量小、工艺路线短、异常频率低的场景,复杂排产收益有限;反过来,瓶颈工序多、换型时间长、物料替代关系复杂的场景,才值得上约束求解。排产技术落地靠的不是模型复杂度,而是异常兜底机制。人不是算法的敌人。人常常是最后一层缓冲。把缓冲拿掉,系统就得自己长出缓冲,否则一次插单就能让全线失速。
 边界与风险:不是每个环节都值得上系统
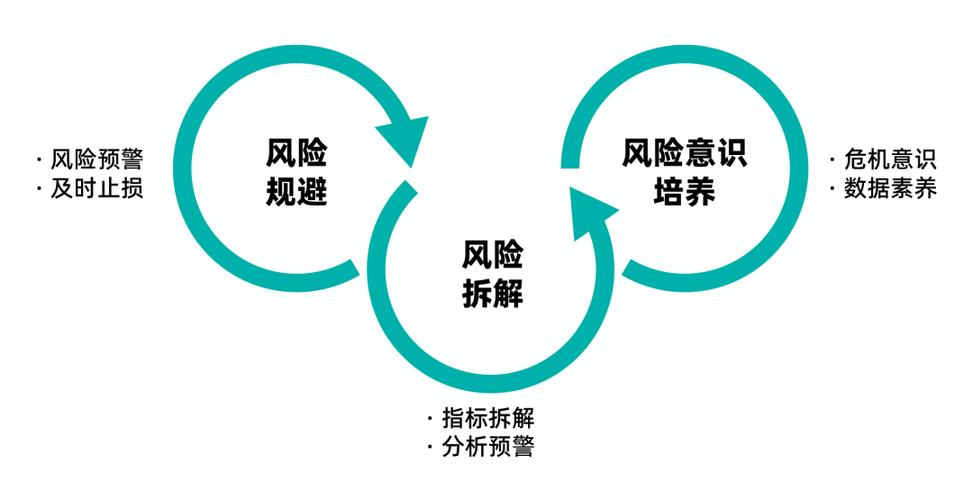
低SKU、低波动、供应商集中且稳定的品类,复杂算法收益有限。技术有应用边界。供应商数据共享的激励不足,模型会漂移;网络安全一松,事件流就是攻击面;供应商锁定一深,后续改造成本高得吓人;指标一博弈,预测准确率会被做成报表艺术。
趋势当然有:可组合架构、边缘计算、概率决策、供应链金融与履约数据打通。但别急着追概念。先问三个问题:动作谁执行,异常谁兜底,数据谁维护。回答不了,系统只是更贵的表格。误差不会消失。它只是换了位置。有的换到库存里,有的换到运费里,有的换到客户投诉里。供应链管理技术要做的,是让这种转移变得可见、可算、可追责。
预测不是水晶球,是误差定价器
需求预测模块常被当成水晶球。实际上它输出的是分布,不是点。滚动预测、分层预测、间歇需求处理,这些方法各有适用条件。关键在把预测误差和补货策略绑在一起。安全库存不是拍脑袋的固定天数,它要跟着提前期波动、服务水平目标和需求自相关走。多级库存里,牛鞭效应不是道德问题,是信息延迟和批量规则的副产品。技术能缩短信息延迟,却改不了批量约束背后的经济账。 我见过一个反面:某企业预测误差指标降了,库存却涨了。为何?预测更平滑,计划员不敢调,批量约束又没动。技术只改了一半,剩下那一半会以库存的形式报复回来。预测系统的价值,不在于曲线多贴合历史,而在于它能否让补货决策在缺货成本和持有成本之间做出可解释的取舍。仓储拣货区RFID读写器部署场景图
可视化之后,谁来承担动作
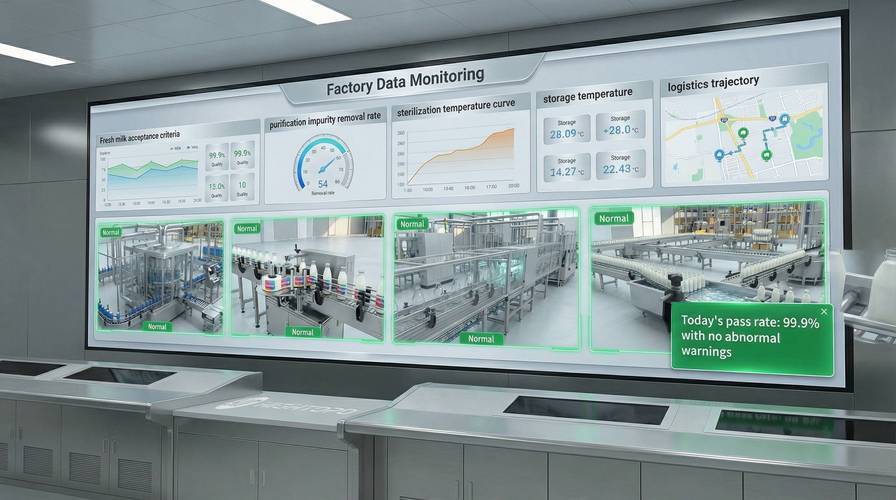
控制塔大屏很亮。数据从ERP、WMS、TMS、供应商门户抽上来,事件流按规则触发预警。问题在动作权。预警不等于处置。谁改交期,谁拆批量,谁承担加急运费,谁向客户解释延迟?这些权限不写清楚,大屏就是高分辨率误会。 事件驱动架构在这里有用,它把订单、在途、库存、质检放行拆成事件,规则引擎再做匹配。可规则一多,维护成本就上来。约束求解能处理复杂排程,但前提是主数据干净、约束表达准确。数字孪生也一样,模型不跟现场校准,仿真只是动画。可视化解决看见的问题,动作设计解决责任的问题。两件事混在一起谈,项目很容易停在演示阶段。制造业供应链数字孪生控制台界面截图
算法排产落地,卡在物料与人的接口
算法排产落地,卡在物料与人的接口
APS听起来硬核。真到车间,卡在物料齐套、工装可用、人员技能矩阵、质量放行。南京一家做精密件的小厂,排产算法跑得挺快,但供应商送货窗口一抖,计划就碎。问题不在算法笨,而在输入不稳。方法不是再买一个模块,而是把供应商承诺、在途批次、检验节拍拉进同一套事件模型。
这里有个边界:订单批量小、工艺路线短、异常频率低的场景,复杂排产收益有限;反过来,瓶颈工序多、换型时间长、物料替代关系复杂的场景,才值得上约束求解。排产技术落地靠的不是模型复杂度,而是异常兜底机制。人不是算法的敌人。人常常是最后一层缓冲。把缓冲拿掉,系统就得自己长出缓冲,否则一次插单就能让全线失速。
边界与风险:不是每个环节都值得上系统
边界与风险:不是每个环节都值得上系统
低SKU、低波动、供应商集中且稳定的品类,复杂算法收益有限。技术有应用边界。供应商数据共享的激励不足,模型会漂移;网络安全一松,事件流就是攻击面;供应商锁定一深,后续改造成本高得吓人;指标一博弈,预测准确率会被做成报表艺术。
趋势当然有:可组合架构、边缘计算、概率决策、供应链金融与履约数据打通。但别急着追概念。先问三个问题:动作谁执行,异常谁兜底,数据谁维护。回答不了,系统只是更贵的表格。误差不会消失。它只是换了位置。有的换到库存里,有的换到运费里,有的换到客户投诉里。供应链管理技术要做的,是让这种转移变得可见、可算、可追责。