别死盯3nm制程了,Chiplet互连才是先进封装真正难啃的硬骨头
上周跟做封测的老周在苏州喝酒,他喝到一半拍桌子骂,现在行业里全是一帮嘴上跑火车的——一讲Chiplet就扯什么把大芯片拆成小芯粒降本,3nm制程成本扛不住了所以拆,讲得好像把几个裸die摆到基板上就算完了。
哪有那么简单。
你把最先进的计算芯粒、最猛的存储芯粒、最灵活的IO芯粒凑到同一块基板上,中间的信号传得慢、串得扰、功耗炸得吓人,凑出来的东西还不如人家单颗大芯片跑的快,那拆了个寂寞。
先算笔账:Chiplet互连根本不是“把线连起来”这么简单
说实话,最早看到UCIe1.0规范的时候我还挺激动的,觉得总算有个统一的东西不用各家自己瞎搞了。结果呢?
坑全在细节里。
很多人以为Chiplet互连就是把线拉短,毕竟原来单芯片里的金属线才几毫米,现在跨die的线哪怕做到几十微米宽,从计算die到内存die的距离就有个几厘米,信号在传输路径上的损耗、串扰、延迟,跟原来片上的互连根本不是一个量级。现在商用的Chiplet方案里,互连链路的功耗占比已经占到整颗芯片总功耗的30%以上,你没看错,三分之一的电都用来在线上跑信号了,真正用来算东西的电反而被挤得越来越少。
 不同工艺节点下Chiplet互连链路功耗占比对比柱状图
之前AMD的3D V-Cache刚出来的时候,大家都惊了,说把缓存die直接叠在计算die上面,带宽拉满,结果谁算过那部分互连的功耗?叠层的微凸点,哪怕做到10微米的间距,每一条链路的电阻都比原来片上的金属线高两个数量级,为了把信号稳住,得给每一段链路单独配驱动电路,光这些驱动吃的电,就够你多塞半个缓存die在上面了。
我之前看到某家国内厂商去年流片的Chiplet方案,标称的互连带宽做到了1TB/s每毫米,结果实测下来,跑满带宽的时候,链路的温度比计算die还高12度,这谁顶得住?
现在大家卷的方向,其实都卷偏了
不过话说回来,现在行业里一提到Chiplet互连,就两个方向使劲:要么卷带宽,把每毫米的传输速率往死里提,从原来的几百GB/s往2TB/s、4TB/s冲;要么卷间距,把凸点的间距从100微米往50微米、20微米压,直到压到跟TSV的尺寸差不多。
有用吗?
有用,但远远不够——你把带宽拉得再高,如果没有配套的链路校准、误差修正、动态功耗调整的机制,只要温度稍微飘一点,信号的误码率就会从1e-12跳到1e-6,直接把链路打回原形,别说跑满带宽了,能稳定传数据就不错。真正卡脖子的根本不是带宽上限,是链路在复杂工况下的鲁棒性。
之前看英特尔在ISSCC上发的那个UCIe 2.0的演示demo,他们为了让链路在-40度到125度的宽温域里都能稳定跑,专门在每条链路上加了实时的自适应均衡电路,占的硅面积比链路本身还大。你说这亏不亏?为了把线连稳,花的硅面积比传数据的电路还多。
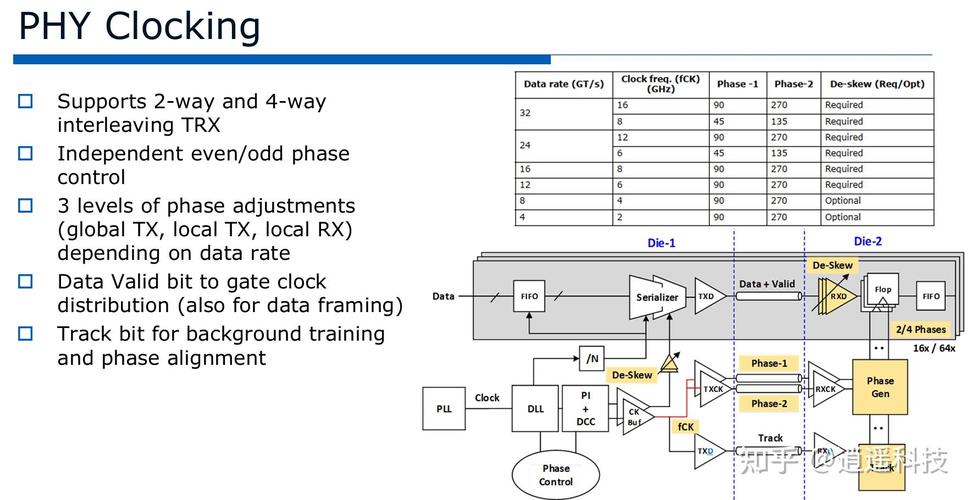 UCIe 2.0标准Chiplet互连链路自适应电路结构示意图
现在很多国内的方案,连最基础的链路温度补偿都没做全,就敢对外吹自己的互连速率追平了国际大厂,等到实际放到服务器里跑个半年,温变加上材料老化,链路直接掉速30%,用户骂都找不到地方。
我去年参与评审的一个行业项目,厂商报的技术指标全是实验室常温下的理想值,问到宽温域下的误码率指标,技术负责人支支吾吾半天说还没测,当时我就把本子合了——这东西做出来谁敢用?
别等标准全成熟了再追,互连的机会其实藏在细节里
 别等标准全成熟了再追,互连的机会其实藏在细节里
现在大家都在等UCIe生态全落地,觉得等标准统一了,所有芯粒都能像搭乐高一样随便拼,其实根本没那么快。你现在去看,AMD的Infinity Fabric、台积电的CoWoS配套的互连、英特尔的EMIB,全是各家自己的私有协议,跟UCIe的兼容性都是半吊子,真正能做到跨厂商互操作的芯粒,现在市面上一只手都数得过来。
为啥?
因为互连这东西,根本不是写个规范拉个联盟就能搞定的。你得摸透不同材料(硅、玻璃基板、有机基板)上的信号传输特性,得磨透不同温度、不同电压下的信号衰减规律,得攒够足够多的实测数据,才能把链路的性能做上去。现在国内在Chiplet互连领域最大的优势,根本不是能做出多高的带宽,是我们有全世界最大的应用场景,能攒最多的实测数据。
比如你在数据中心里跑AI推理,在车规级的芯片里跑自动驾驶,在消费电子里跑手机游戏,不同场景下对互连的要求根本不一样:数据中心要的是带宽够高、功耗够低;车规要的是宽温域稳定、抗干扰强;消费电子要的是成本够低、良率够高。这些东西,不是坐在办公室里写规范就能写出来的,得一个场景一个场景磨。
上周老周跟我说,他们厂现在接了好几个国内AI芯片厂的封测单,现在大家终于不盯着单颗die的制程吹了,开始回头算互连的成本、互连的功耗、互连的良率。这其实是好事。
路总得一步步走。
毕竟你花大价钱买了个顶级跑车,结果装了个自行车的链条,根本跑不起来。