韧性技术系统:黑天鹅满天飞的当下,什么才是真的抗造
去年开春OpenAI集体宕机那阵,多少依赖它的创业公司直接停摆。客服没法自动回复,用户进不来APP,创始人蹲在公司群里刷状态,熬到凌晨也没招儿。
这种事儿,真不是小概率事件。
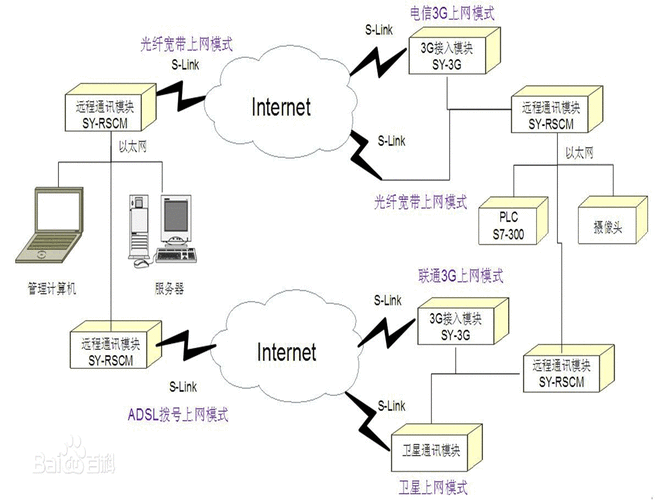 韧性技术系统与冗余系统对比示意图
说白了,冗余是「我多带一块备用零件放身上」,韧性技术系统是「你割我一刀,我自己能止血愈合,该干嘛还干嘛」。完全不是一回事。
说实话,我见过不少公司,为了「容灾」砸了几百万堆资源,结果真出问题还是挂。前年AWS us-east-1大区宕机,好多做了跨区备份的公司照样歇菜,为啥?他们把DNS解析服务还放在故障区,整个网络入口直接堵死,备份再多也拿不出来。
真正的韧性技术系统,核心是动态适应的能力,不是静态堆资源。它不需要你预判所有可能出问题的地方,只要做到故障自动隔离、影响自动收缩、服务自动恢复,哪怕出了你完全没想过的问题,也能把损失锁在小范围,不连累整个系统。
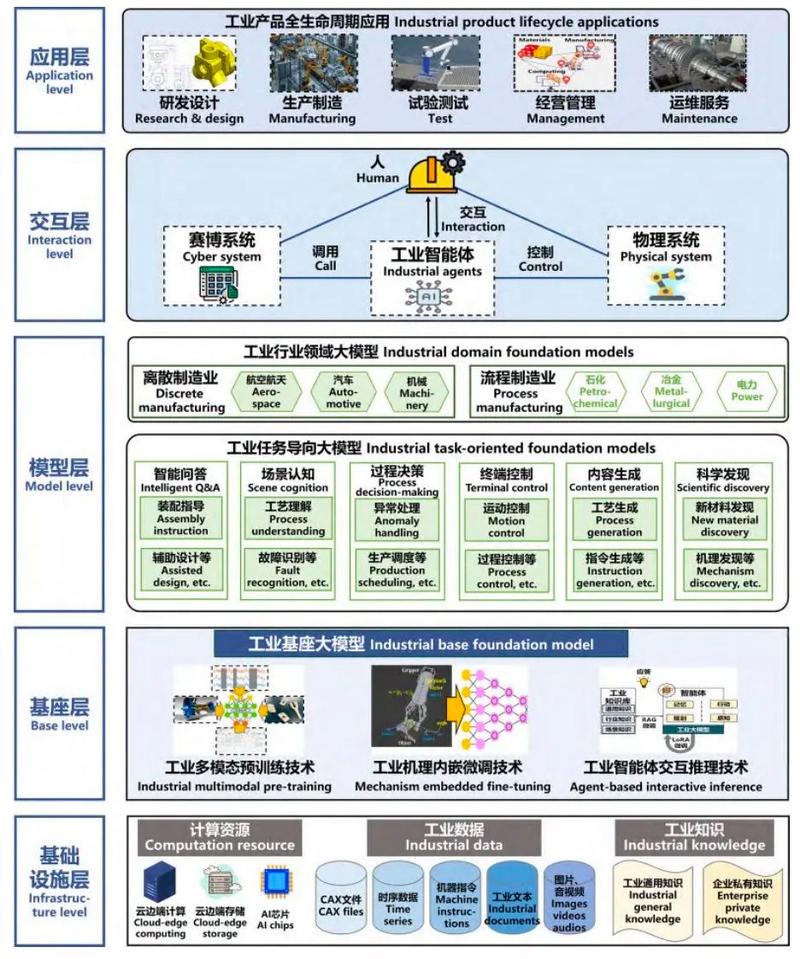 大模型应用韧性容错架构图
更值得说的是大模型的韧性设计,这玩意现在太刚需了。多少创业公司做大模型应用,图省事直接把核心推理绑定在某一家的API上,平时用着好好的,对方一限流、一调价,你整个产品直接不能用了。甚至你自己部署大模型,集群里一张GPU卡坏了,整个推理服务直接挂,这种事儿我上个月刚听一个CTO吐槽过。
好的韧性设计,会给大模型应用做多层兜底:API调用失败自动切到备用服务商,GPU硬件故障自动把任务调度到空闲卡,甚至大模型输出出错,韧性校验层也能直接拦下来,换个模型重新生成,不会把离谱的内容递给用户。
去年底OpenAI那次大宕机,好多做AI应用的公司就是靠这套韧性设计,几乎没受影响,用户连出事儿了都不知道。这就是韧性的价值。
 中小企业做韧性,真的不用砸大钱
很多人一听到「技术系统」「架构」就觉得这是大厂玩的,我们小公司哪有这人力财力凑这个热闹?
真不是这么回事。
韧性是分等级的,你不需要上来就做什么跨云多活、三地五中心,那些是给千万级流量的大厂准备的。对小公司来说,先把最可能出问题的几个地方兜住,就是合格的韧性建设了。
比如做ToC的小程序,你把支付接口多备一家,图片存储放到两个不同厂商,开个云服务商的弹性自动扩容,这一套下来,一个月多花不了几百块,就能接住绝大多数突发流量和故障。
上个月跟一个做亲子研学的老板聊天,去年暑假他的一条短视频爆了,流量翻了三十倍,原来的服务器直接扛死,几十万访客进不来,最后算下来,光是报名损失就小一百万,还亏了不少投放的钱。后来他听了建议,花了不到一千块改了基础架构,加了最基础的韧性配置,上个月他又一条视频爆了,稳稳接住,转化比上次还高了两成。
不过话说回来,也别瞎折腾。上来就照搬大厂的全套方案,最后维护成本比业务收入还高,那不是韧性,那是给自己找不痛快。适合你当前规模的,才是最好的。
现在这个世道,谁也说不准明天会出什么幺蛾子。说不定你做得好好的,云服务商断网,上游API停服,甚至天灾把光缆挖断。太多公司,产品做得没问题,增长也挺好,就是一次意外故障,把用户信心打没了,直接就没然后了。
真的太可惜了。
做韧性技术系统,本质不是为了应付检查,也不是为了凑技术概念骗融资,就是给你的业务买一把伞。你不是每天都能碰到下雨,但下雨的时候,你得有得拿。
就这么简单。
别把韧性和冗余搞混了,很多人从根上就错了
一提抗造的系统,多数人第一反应就是堆备份。多买一台服务器,多存一份数据,这不就是抗造了? 错得离谱。韧性技术系统与冗余系统对比示意图
说白了,冗余是「我多带一块备用零件放身上」,韧性技术系统是「你割我一刀,我自己能止血愈合,该干嘛还干嘛」。完全不是一回事。
说实话,我见过不少公司,为了「容灾」砸了几百万堆资源,结果真出问题还是挂。前年AWS us-east-1大区宕机,好多做了跨区备份的公司照样歇菜,为啥?他们把DNS解析服务还放在故障区,整个网络入口直接堵死,备份再多也拿不出来。
真正的韧性技术系统,核心是动态适应的能力,不是静态堆资源。它不需要你预判所有可能出问题的地方,只要做到故障自动隔离、影响自动收缩、服务自动恢复,哪怕出了你完全没想过的问题,也能把损失锁在小范围,不连累整个系统。
现在做韧性技术系统,最落地的两个方向
这两年学术界和工业界一起砸钱进韧性,本质就是原来的系统设计思路跟不上现在的环境了。原来我们做系统,都是假设「大部分组件都是稳定的,出问题是小概率」,现在呢?云服务商宕机、API厂商限流、网络波动、供应链出问题...啥稀奇古怪的事儿都有。 现在成熟度最高的两个落地方向,一个是云原生韧性架构,一个是大模型应用韧性设计。 云原生这个大家听得不少,微服务拆分之后,最害怕的就是雪崩——一个小服务挂了,请求全堆在那,顺着链路拖死所有服务。原来靠人工运维删流量,现在韧性架构直接把熔断、降级、自动切流做到了每一个服务节点,某一个节点坏了,几毫秒之内就把流量切到正常节点,故障自动隔离,用户根本感觉不出来。大模型应用韧性容错架构图
更值得说的是大模型的韧性设计,这玩意现在太刚需了。多少创业公司做大模型应用,图省事直接把核心推理绑定在某一家的API上,平时用着好好的,对方一限流、一调价,你整个产品直接不能用了。甚至你自己部署大模型,集群里一张GPU卡坏了,整个推理服务直接挂,这种事儿我上个月刚听一个CTO吐槽过。
好的韧性设计,会给大模型应用做多层兜底:API调用失败自动切到备用服务商,GPU硬件故障自动把任务调度到空闲卡,甚至大模型输出出错,韧性校验层也能直接拦下来,换个模型重新生成,不会把离谱的内容递给用户。
去年底OpenAI那次大宕机,好多做AI应用的公司就是靠这套韧性设计,几乎没受影响,用户连出事儿了都不知道。这就是韧性的价值。
中小企业做韧性,真的不用砸大钱
中小企业做韧性,真的不用砸大钱
很多人一听到「技术系统」「架构」就觉得这是大厂玩的,我们小公司哪有这人力财力凑这个热闹?
真不是这么回事。
韧性是分等级的,你不需要上来就做什么跨云多活、三地五中心,那些是给千万级流量的大厂准备的。对小公司来说,先把最可能出问题的几个地方兜住,就是合格的韧性建设了。
比如做ToC的小程序,你把支付接口多备一家,图片存储放到两个不同厂商,开个云服务商的弹性自动扩容,这一套下来,一个月多花不了几百块,就能接住绝大多数突发流量和故障。
上个月跟一个做亲子研学的老板聊天,去年暑假他的一条短视频爆了,流量翻了三十倍,原来的服务器直接扛死,几十万访客进不来,最后算下来,光是报名损失就小一百万,还亏了不少投放的钱。后来他听了建议,花了不到一千块改了基础架构,加了最基础的韧性配置,上个月他又一条视频爆了,稳稳接住,转化比上次还高了两成。
不过话说回来,也别瞎折腾。上来就照搬大厂的全套方案,最后维护成本比业务收入还高,那不是韧性,那是给自己找不痛快。适合你当前规模的,才是最好的。
现在这个世道,谁也说不准明天会出什么幺蛾子。说不定你做得好好的,云服务商断网,上游API停服,甚至天灾把光缆挖断。太多公司,产品做得没问题,增长也挺好,就是一次意外故障,把用户信心打没了,直接就没然后了。
真的太可惜了。
做韧性技术系统,本质不是为了应付检查,也不是为了凑技术概念骗融资,就是给你的业务买一把伞。你不是每天都能碰到下雨,但下雨的时候,你得有得拿。
就这么简单。