当算法敲开实验室门:人机协同研发的破局与边界
上个月赶去南京参加0923的产学研对接会,蹲在新材料展区看了一个多小时,亲眼见团队负责人翻出半年前的项目进度表——原本预计十八个月才能完成的高温合金配方筛选,四十天就出了三个合格候选。当时惊得我手里的冰咖啡都放温了。
拆掉分工的围墙
很长一段时间里,行业默认的规则是人干创意,机器干计算。人圈定方向,机器做重复运算出结果。这套逻辑跑了很多年,直到最近一两年,越来越多跑通的项目把它推翻了。
我认识一个做抗肿瘤药物研发的课题组,两年前按照老思路,由资深教授圈定十个可能的靶点,再用模型做验证筛,算了快两年,连个能进细胞实验的候选都没有。后来组里一个年轻博士换了玩法:不给机器设任何预设范围,让它全基因组扫可能的结合位点,再把所有靶点按照结合能力排序,最后排到前三的靶点,全是领域里没人研究过的冷方向。现在其中一个已经进了临床前验证,进度比同方向的团队快了至少两年。
本质上,这是分工的重构:机器负责跳出人类的经验盲区,找那些我们不敢想、想不到的方向,人负责卡边界、做验证,把机器天马行空的结果落到地上。
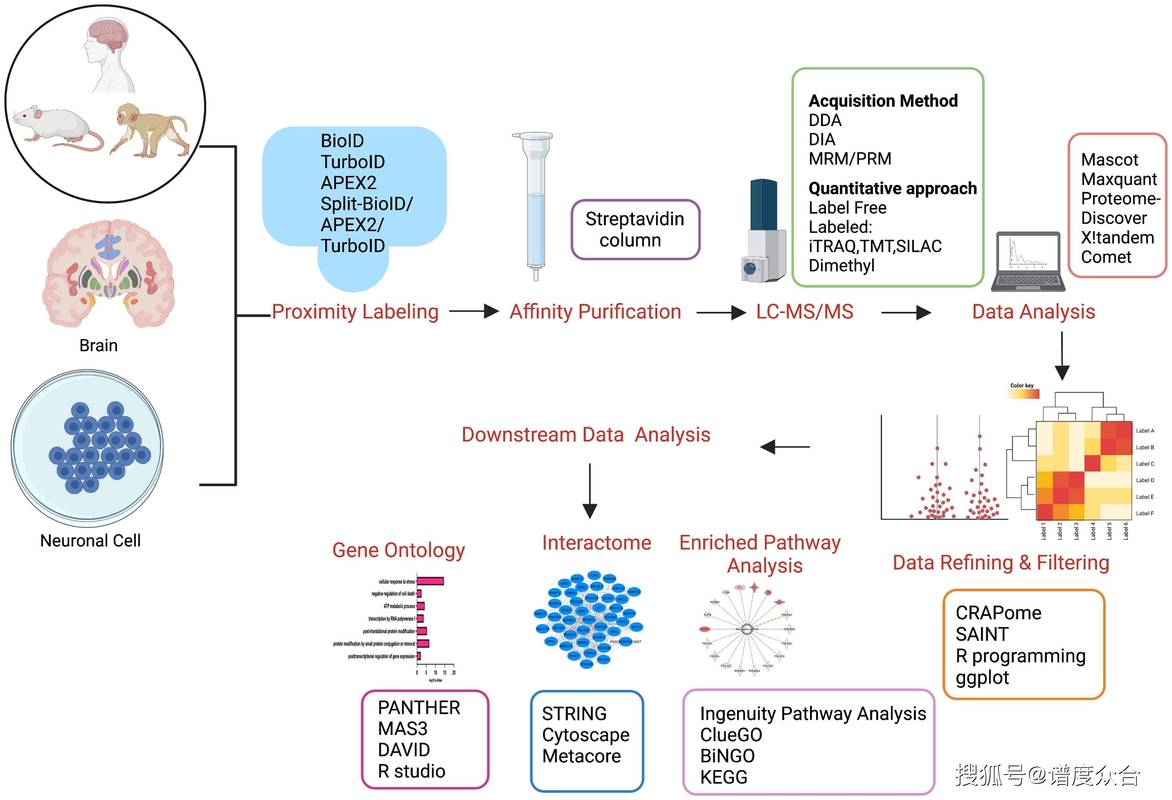 生物医药人机协同靶点筛选流程图
这件事说起来简单,真做的时候,九成团队第一步就走错了。
被跨过的默会知识鸿沟
很多团队掏大价钱买算力、训大模型,把攒了十几年的实验数据一股脑喂进去,最后出来的结果根本没法用。问题出在哪?不是算力不够,是你的数据里,缺了研发里最值钱的那部分东西。
前阵子听南京江北新区一个芯片设计团队的负责人吐槽,他们去年花了近三百万搭了协同研发系统,跑出来的前端布线方案,理论上芯片利用率比人设计的还高两个百分点,结果流片出来,良品率连百分之三十都达不到。干了三十年设计的总工拿过去看了五分钟,就指出问题:机器根本没考虑到这条产线做14nm工艺时,温湿度波动带来的晶格应力偏差,这个偏差每个厂都不一样,只会写在工艺部的内部笔记里,根本没人整理进训练数据集。
 芯片设计人机协同布线对比图
这就是最容易被忽略的问题:研发里大量的核心经验是默会知识。那些做了几十年的老研发人员,能靠感觉说出“这个配比不对,上次出问题就是这个味儿”,这种没法量化的经验,才是帮研发踩刹车的关键。机器学不到,就永远出不了能用的结果。
要填这个坑,核心是做认知对齐——不是把人的结果转换成数据给机器,是把机器的输出转换成研发人员能读懂的逻辑,让人和机器能互相读懂对方的思考。很多团队搞反了,逼着人去适配机器的逻辑,最后自然跑不通。
落地要找小切口,别贪大
 落地要找小切口,别贪大
说实话,现在这个领域泡沫不少。张嘴就是全流程替代,闭嘴就是颠覆研发,一堆蹭概念的项目拿着融资烧钱,最后连个能用的小样都拿不出来。
我见过跑通的项目,全都是从小切口切进去,没有上来就搞全流程替换的。比如做新材料的,先让机器干配方筛选,人干最终验证;做药物的,先让机器干靶点预筛,人干后续实验;做芯片的,先让机器干初步布线,人做最终优化。先把研发人员从最耗时间、最重复的劳动里解放出来,再慢慢扩范围,这才是走得通的路。
也要说清楚边界,什么时候绝对不能把决策权扔给机器?涉及合规、伦理、方向判断的地方,必须人卡最后一关。我听过一个例子,某团队用机器找新的化工合成路径,机器跑出来的方案转化率比现有方法高整整二十个百分点,结果最后审核的时候才发现,整个路径核心溶剂是一类致癌物,根本过不了环保审批,机器的训练集里根本没加合规限制,白忙活了三个多月。
不过话说回来,泡沫归泡沫,方向本身没错。它不是要替代谁,是帮研发把原来跨不过去的门槛给垫低了。原来一个课题组一年只能试十几个配方,现在机器能帮你试几千个,研发人员不用天天守着反应釜记数据,能腾出时间想真正重要的科学问题。
上次在南京展馆,那个新材料团队的负责人说了一句话,我记得特别清楚:原来我们这行,拼的是谁能熬得住十年试错,现在拼的是谁能想清楚,到底让人和机器各站什么位置。对吧?