从像素到共情:多媒体制作技术的演化边界与未来陷阱
很多人聊起这个方向,第一反应就是剪视频、做PPT、套AE模板。
错得离谱。
技术的核心从来都是工具服务于信息,不是反过来。
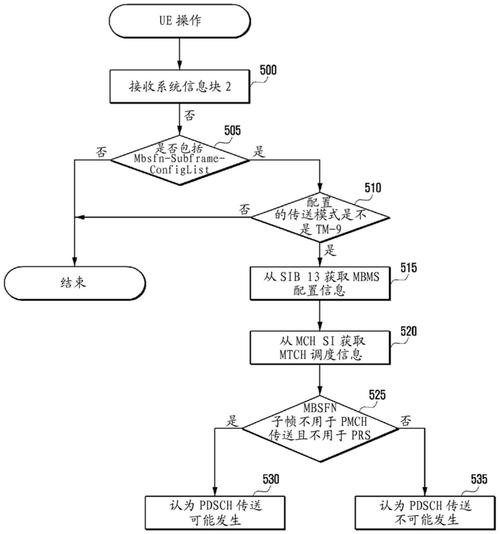 多媒体多源编码格式适配转换流程图
我前两年帮朋友看一个高校的精品课项目,整个片子的素材来自录屏、摄像机、手机、还有十年前拍的老录像带转档,负责剪辑的学生直接把所有素材拖进时间线就剪,输出的时候统一压了1000k码率,放到学校平台上,老素材部分全是马赛克,连PPT上的字都看不清。
这不是学生手笨,是没人告诉他,不同来源的素材,必须先统一编码参数,再进剪辑流程。太多人把技术等同于会用剪辑软件,把基础的适配原理当成无关紧要的小事,最后出了问题还怪器材不好,怪平台压缩太狠。
不过话说回来,现在快餐式的教学,本来就只教你能快速复制的东西,这种吃力不讨好的基础原理,谁愿意费口舌讲呢?对吧。
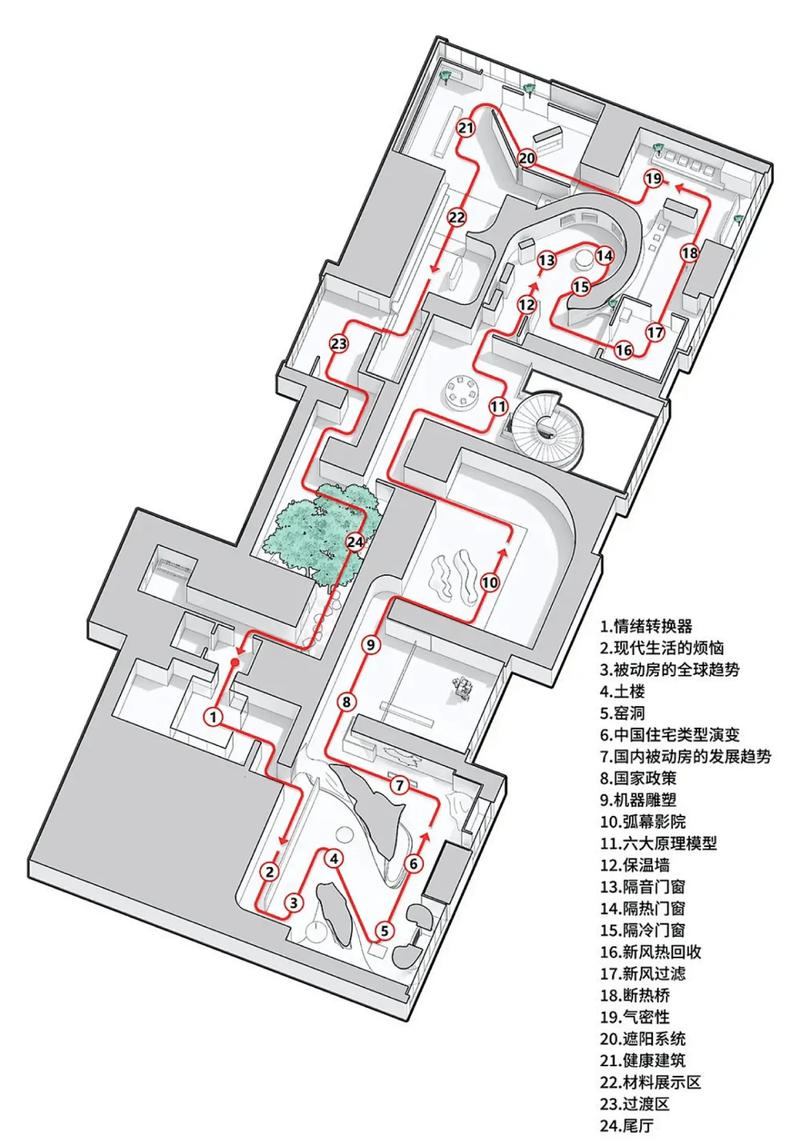 线下展馆互动多媒体节点交互逻辑图
之前在南京逛过一个城市文化展,其中有一个讲民国建筑的展项,整个设计逻辑就舒服。一进门墙面上是整个城区的建筑分布图,你走到哪块,对应的建筑就亮起,轻轻一碰,墙面上就弹出这个建筑的老照片、当年的报纸报道,还有现在的现状航拍,声音会同步讲建筑的历史。整个流程不用找解说,不用看说明书,顺着你的行走路线就能get到所有信息,这才是把技术用对了地方。
实现路径其实没那么玄乎。先理清楚你要传递的核心信息是什么,然后给信息分好层级,最重要的放在第一触点,次要的放在次级交互里,最后再找素材做美化。太多人反过来,先找一堆好看的素材堆上去,最后再补逻辑,出来的东西只能是华而不实的花架子。
而且这里有个很容易踩的坑,就是为了炫技加很多没必要的交互,比如翻个页也要给你加三秒的旋转特效,点个按钮也要蹦出来一堆花瓣,本质上就是干扰信息接收,用户烦都烦死了。
 AI入局之后,看不见的新风险
现在AI生成素材太方便了,输入几个关键词就能出图出音出视频,很多人说这个领域要变天了,从业者都要失业了。
说实话,工具变了,核心逻辑没变。但是新的风险确实出来了,很多人没注意。
第一个风险是版权模糊。你用AI生成的素材,训练数据里有没有带版权的内容?现在法条说不清楚,一旦商用被告,十有八九是你吃亏。去年我知道一个做地产宣传的项目,用AI生成了几张背景图,结果被摄影师告了,说AI训练用了他的原创作品,最后赔了六万多,得不偿失。
第二个风险是信息失真。AI生成内容是概率性的,为了美观会自动调整细节,如果你做的是科普、考古、工程这类对信息准确性要求极高的内容,很容易出问题。之前有个文博号做文物介绍,用AI生成了商代青铜器的复原图,AI把器物上的铭文给改了,结果错的内容转得到处都是,最后号主发了三篇道歉声明都没把影响消掉。
AI的应用边界从来都很清晰:做素材初稿、做概念草稿、做非核心的背景装饰,这些没问题,但是核心信息的梳理、准确内容的呈现,还是要靠人来把控。
很多人说未来这个方向会往越来越智能的方向走,我倒觉得,真正的方向是往越来越适配人的方向走。给视障人士做的带触觉反馈的多媒体读本,给认知障碍群体做的低刺激认知训练多媒体,给偏远地区孩子做的离线可加载的教学多媒体,这些地方没有那么多炫技的空间,但是真正解决问题,也真正需要技术落地。
很多人追着风口跑,追来追去,忘了技术本来就是为人服务的。就这么简单。
被高估的通用性,被忽略的技术前提
市面上绝大多数教程,都在教你“怎么用这个工具出活”,绝口不提不同媒介背后的编码差异。 不同介质的信息存储逻辑,从根上就不一样。印刷用的CMYK色彩模式,挪到电子屏上用的RGB,出来的颜色直接偏一个度,你说找谁说理?栅格图放矢量排版里放大就糊,无损音频压成mp3插到在线课件里,加载速度是快了,低频直接砍没了,给耳机党听着像闷在盒子里说话。多媒体多源编码格式适配转换流程图
我前两年帮朋友看一个高校的精品课项目,整个片子的素材来自录屏、摄像机、手机、还有十年前拍的老录像带转档,负责剪辑的学生直接把所有素材拖进时间线就剪,输出的时候统一压了1000k码率,放到学校平台上,老素材部分全是马赛克,连PPT上的字都看不清。
这不是学生手笨,是没人告诉他,不同来源的素材,必须先统一编码参数,再进剪辑流程。太多人把技术等同于会用剪辑软件,把基础的适配原理当成无关紧要的小事,最后出了问题还怪器材不好,怪平台压缩太狠。
不过话说回来,现在快餐式的教学,本来就只教你能快速复制的东西,这种吃力不讨好的基础原理,谁愿意费口舌讲呢?对吧。
交互逻辑才是核心,不是素材堆叠
静态的图文拼合不算真的多媒体。真的多媒体,是让信息顺着用户的操作路径流动起来。 很多做线下展项的团队,一上来就堆3D模型、上4K大屏、加环绕音,生怕不够炫,结果把交互逻辑做的一塌糊涂。用户站在屏幕前,不知道该点哪,点完之后不知道该看哪,逛了两分钟,只记得屏幕很亮,特效很多,核心讲了什么一点没记住。线下展馆互动多媒体节点交互逻辑图
之前在南京逛过一个城市文化展,其中有一个讲民国建筑的展项,整个设计逻辑就舒服。一进门墙面上是整个城区的建筑分布图,你走到哪块,对应的建筑就亮起,轻轻一碰,墙面上就弹出这个建筑的老照片、当年的报纸报道,还有现在的现状航拍,声音会同步讲建筑的历史。整个流程不用找解说,不用看说明书,顺着你的行走路线就能get到所有信息,这才是把技术用对了地方。
实现路径其实没那么玄乎。先理清楚你要传递的核心信息是什么,然后给信息分好层级,最重要的放在第一触点,次要的放在次级交互里,最后再找素材做美化。太多人反过来,先找一堆好看的素材堆上去,最后再补逻辑,出来的东西只能是华而不实的花架子。
而且这里有个很容易踩的坑,就是为了炫技加很多没必要的交互,比如翻个页也要给你加三秒的旋转特效,点个按钮也要蹦出来一堆花瓣,本质上就是干扰信息接收,用户烦都烦死了。
AI入局之后,看不见的新风险
AI入局之后,看不见的新风险
现在AI生成素材太方便了,输入几个关键词就能出图出音出视频,很多人说这个领域要变天了,从业者都要失业了。
说实话,工具变了,核心逻辑没变。但是新的风险确实出来了,很多人没注意。
第一个风险是版权模糊。你用AI生成的素材,训练数据里有没有带版权的内容?现在法条说不清楚,一旦商用被告,十有八九是你吃亏。去年我知道一个做地产宣传的项目,用AI生成了几张背景图,结果被摄影师告了,说AI训练用了他的原创作品,最后赔了六万多,得不偿失。
第二个风险是信息失真。AI生成内容是概率性的,为了美观会自动调整细节,如果你做的是科普、考古、工程这类对信息准确性要求极高的内容,很容易出问题。之前有个文博号做文物介绍,用AI生成了商代青铜器的复原图,AI把器物上的铭文给改了,结果错的内容转得到处都是,最后号主发了三篇道歉声明都没把影响消掉。
AI的应用边界从来都很清晰:做素材初稿、做概念草稿、做非核心的背景装饰,这些没问题,但是核心信息的梳理、准确内容的呈现,还是要靠人来把控。
很多人说未来这个方向会往越来越智能的方向走,我倒觉得,真正的方向是往越来越适配人的方向走。给视障人士做的带触觉反馈的多媒体读本,给认知障碍群体做的低刺激认知训练多媒体,给偏远地区孩子做的离线可加载的教学多媒体,这些地方没有那么多炫技的空间,但是真正解决问题,也真正需要技术落地。
很多人追着风口跑,追来追去,忘了技术本来就是为人服务的。就这么简单。