你点外卖没泄露地址?隐私计算藏在你每天的上网里
你点外卖的时候,有没有想过,平台给你推「周边人都爱吃的店」,它是怎么算出来的?
它要汇总周边三公里所有用户的点餐偏好,才能算出哪几家店口碑最高。但它不敢把所有用户的地址、口味、消费记录全都拿出来放在一块算——万一漏了,就是天大的事儿。
这就是大多数人没听过,但每天都在用到你的身上的问题。
明明要一起算数据,为啥不能把数据放一块?
说实话,这个痛点太老了。早十几年前互联网开始攒数据的时候,大家就碰到了。
你是银行,要给街边开小店的老板批贷款,你只知道老板在你这儿的流水,不知道他每个月进多少货,发多少快递,线上有多少营业额。这些数据分别在电商平台和物流公司手里。
人家敢把用户数据给你吗?别说《个人信息保护法》压着,就算没法规,谁敢把自己用户的隐私往外放?出了事儿谁扛?
这就是数据孤岛,每块数据都是价值连城的金矿,但就是挖不出来——你想合两块矿挖,就得先把矿搬一块,搬的过程就把隐私漏了。
前几年这种事儿见得少吗?一堆公司号称做数据合作,转头就把用户信息卖了,哪怕是无心的泄露,遭殃的都是普通人。
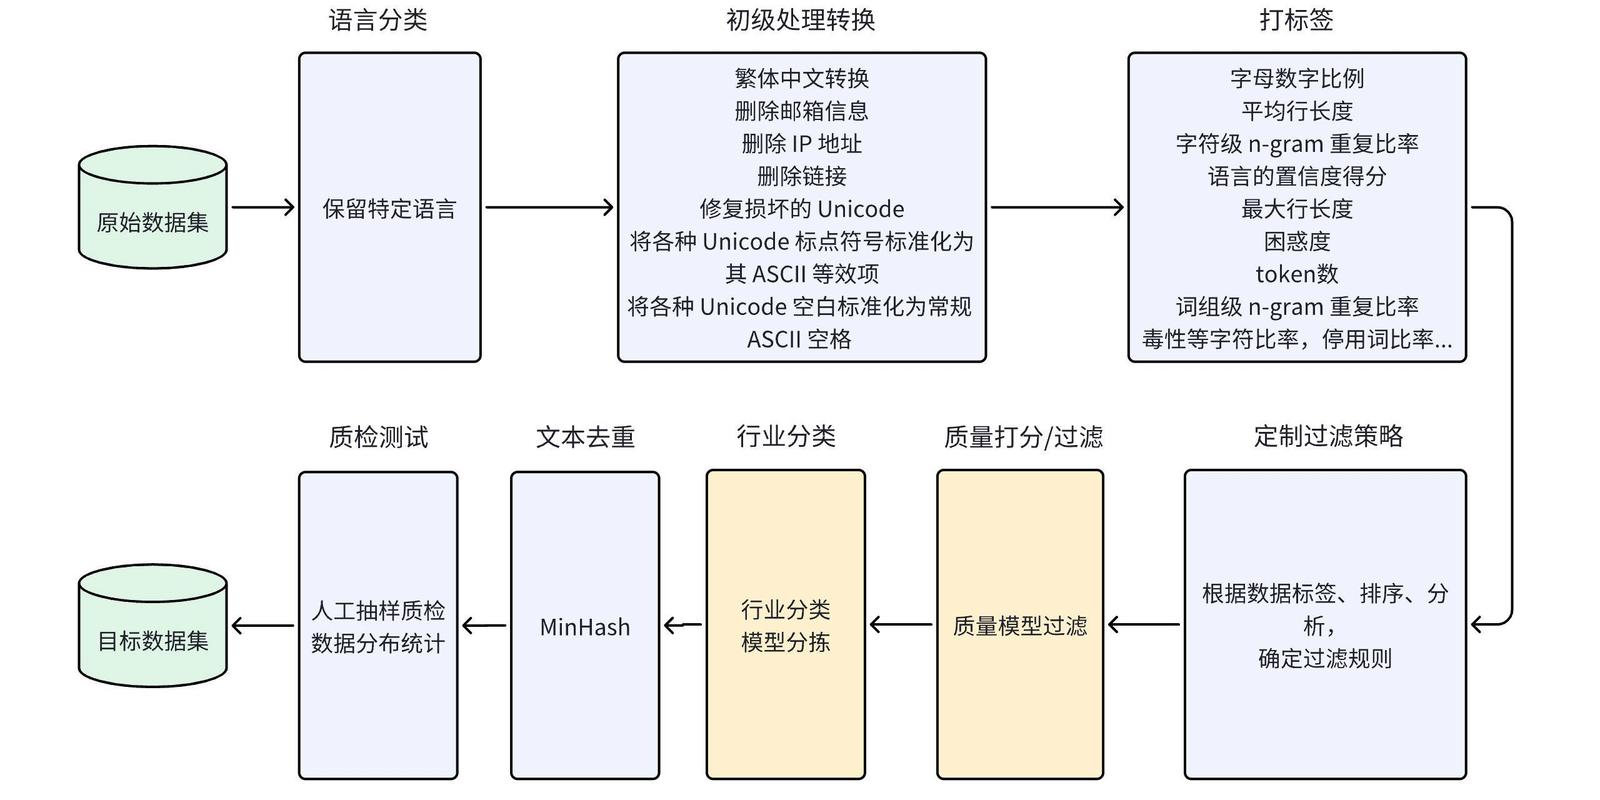 传统数据合作数据汇集流程泄露示意图
隐私计算到底是怎么做到数据可用不可见的?
说穿了,这个技术核心就是一句话:我只用你的数据算结果,不拿你的原始数据。
举个最俗的例子。你和我都不说自己月薪多少,但就想比一比谁拿得多,怎么办?
原来的方法是,我们都把工资条掏出来给第三方看,第三方说谁高就是谁高。但第三方万一转头把我们工资卖了呢?风险太大。
用隐私计算的方法,我们不用给任何人看工资条。咱们拿两把锁,各自把自己写了数字的卡片锁在盒子里,两个人一起在锁着的盒子里做对比,最后只打开盒子看结果——只出来「你比我高」,没人看到具体数字。钥匙还在咱们自己手里。
现在落地最多的联邦学习,就是这个思路。大家各自在自己的数据集上训练AI模型,只把训练出来的模型参数传给对方合在一起,原始数据从头到尾都留在自己的地盘,一步都没动过。
还有另一个常用的差分隐私,就是给原始数据加一点没什么影响的小噪音,算整体结果的时候完全不影响准确性,但想要从结果里反推某一个具体用户的信息,根本不可能。
听起来很玄,其实落地场景就在你身边。你刷到的短视频推荐,你申请贷款的时候的风控,甚至医院一起联合训练的癌症早筛AI,背后都有可能跑着隐私计算。
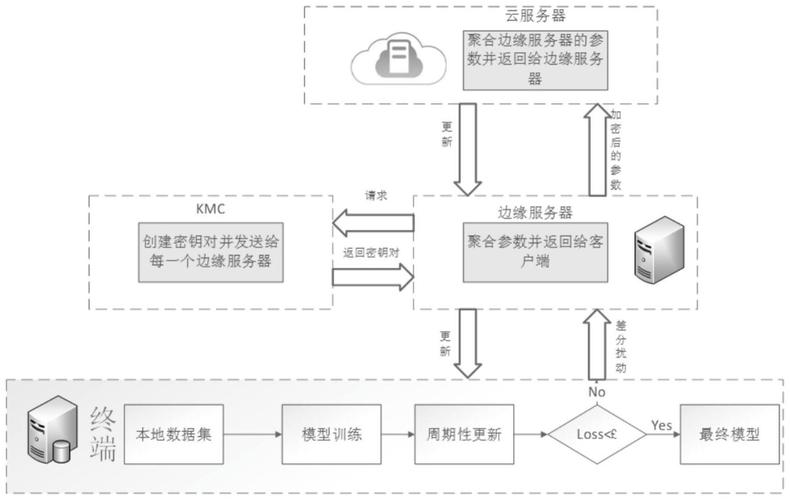 隐私计算联邦学习参数交换流程示意图
别吹神了,隐私计算也有绕不开的坑
 别吹神了,隐私计算也有绕不开的坑
前几年风口的时候,什么牛鬼蛇神都出来蹭概念,连做数据标注的小工作室都敢说自己做隐私计算,说的神乎其神,好像有了它所有数据问题都解决了。
都是扯。
第一个误区,很多人觉得隐私计算就是绝对安全。错。它只是把数据泄露的风险降到了足够低,不是完全没有。比如现在已经有研究证明,传递模型参数的时候,还是有可能通过算法反推出部分原始数据,只是成本很高,一般人碰不到而已。而且它解决不了内鬼偷数据的问题,如果有人直接从你存原始数据的服务器把数据拷走,隐私计算根本管不着。
第二个误区,隐私计算只是为了合规。不对,合规只是最基础的要求,它真正的价值是把原来不能碰的合作变成了可能。原来银行不敢和运营商合作做风控,现在可以拿到用户的行为特征,不用碰用户的具体通话记录,既多了一个风控维度,降低了坏账,又不违规,两边都赚,用户也不用怕信息漏出去,这才是价值。
还有个现实的坑,就是太贵了。原来把数据放一块算,一次就搞定,现在要加密解密,来回传参数,计算量翻好几倍,带宽成本也上去,很多小机构根本用不起。现在落地的大多是大公司,银行、互联网平台、医疗机构,小玩家还碰不起。
不过话说回来,你说这技术改变了什么?其实它就是给我们现在这个数据时代补了一块最关键的短板。原来我们总说,数据是新时代的石油,可石油不能运,运出来就漏,漏了就污染,那挖了也白挖。隐私计算就是建了一条干净的输油管道,石油不用离开产地,能把油运到需要的地方炼,价值出来了,污染也没了。
它不是什么改变世界的黑科技,就是一个解决老问题的笨办法。但就是这种笨办法,才让我们既能用到数据带来的方便,又不用把自己的隐私全露出去。
下次你点外卖收到精准推荐,申请贷款很快批下来的时候,你可以想一想,说不定背后就有隐私计算在偷偷干活,帮你捂着你的隐私呢。