数据锁在保险柜里?联邦学习技术照样训出好模型
上个月跟城商行的项目经理吃火锅,他烟抽了半盒,吐槽了三个小时。之前要做个跨区域的反欺诈模型,监管要求客户数据绝对不能出本地机房,所有数据都锁在内网保险柜里,谁动谁出事。想联合周边几家城商行一起训模型,数据碰都碰不到,以前攒数据训模型的老路,直接给堵死了。这不就是我碰过N次的老问题,直接给他甩了联邦学习的方案,最后成了,他结账的时候都笑开了花。
数据不能出本地,这到底是谁的锅
这几年用户隐私的弦越绷越紧,不管是国内的个人信息保护法,还是海外的GDPR,随便违规传输数据,罚到你怀疑人生。企业自己也怕,数据就是命根子,平白无故给别人,换你你也不愿意。
原来做机器学习的路数是什么?把所有要用的数据都汇集到一个中心服务器,洗干净了再训模型。现在这条路,对很多有敏感数据的行业,走不通了。大家都把数据揣在自己兜里,谁都不肯掏,这不就是大家常说的数据孤岛?
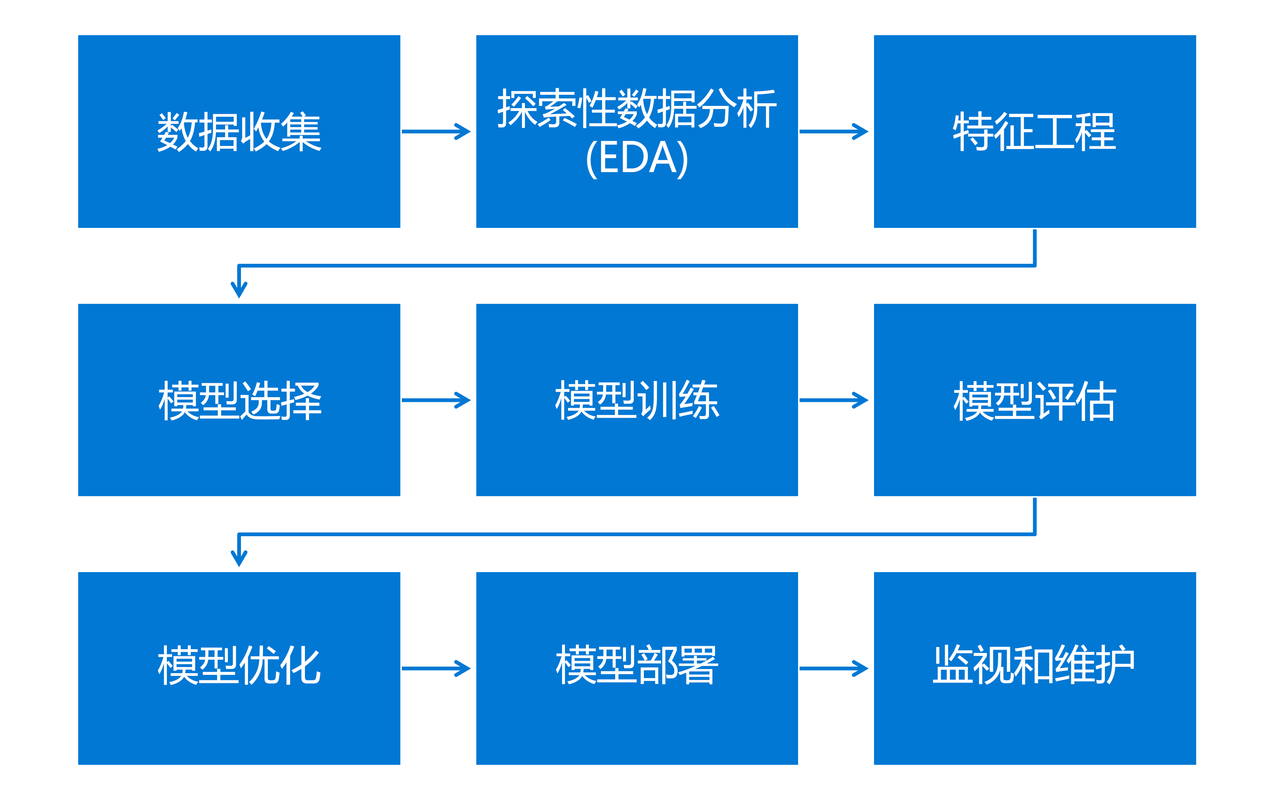 集中式机器学习数据汇集流程图
你说为了合规不做模型了?那肯定不行啊。银行反欺诈,医院诊病,零售做用户推荐,哪一样离得开更精准的模型?总不能因为不能凑数据,就躺着不动吧?
联邦学习到底是怎么“不动数据训模型”的
说穿了其实很好理解。联邦学习的核心就是:只传模型参数,不传原始数据,原始数据自始至终都待在你自己的地盘里。
我给你打个比方,你我还有三个朋友,每个人手里都有一份独家的卤肉方子,都不想把自己的调料配方给别人看,但是又想一起做出一份比每个人单独做都好吃的卤肉,怎么办?原来的方法是所有人把调料都倒一口锅里一起炖,现在不行,那用联邦学习的方法就是:每个人先用自己的方子卤一遍,把自己卤肉试出来的火候调味的经验记下来——这个经验就是模型参数,然后把这个经验拿出来大家一起凑一块调,调出一份大家都认可的更好的经验,再把这份经验拿回去,每个人用新经验再卤一遍,来回调个几次,最后出来的卤肉,比你自己单独做的好吃多了,而且从头到尾没人看过你手里的原配方。对不对?
现在常用的主要分两类,一类叫横向联邦,一类叫纵向联邦。横向联邦说白了就是“同特征不同样本”,比如我刚才说的好几家城商行,都做信贷业务,记录的用户特征都是差不多的,逾期、消费额这些,但是每家的用户不一样,凑一块样本量就大了,模型自然更准。纵向联邦就是“同用户不同特征”,比如一家银行有用户的还款数据,一家电商有用户的购物数据,一家出行平台有用户的出行数据,大家的用户有一部分重叠,每家手里的特征都不一样,凑一块就能给用户画个更完整的像,而且谁都不碰对方的原始数据。
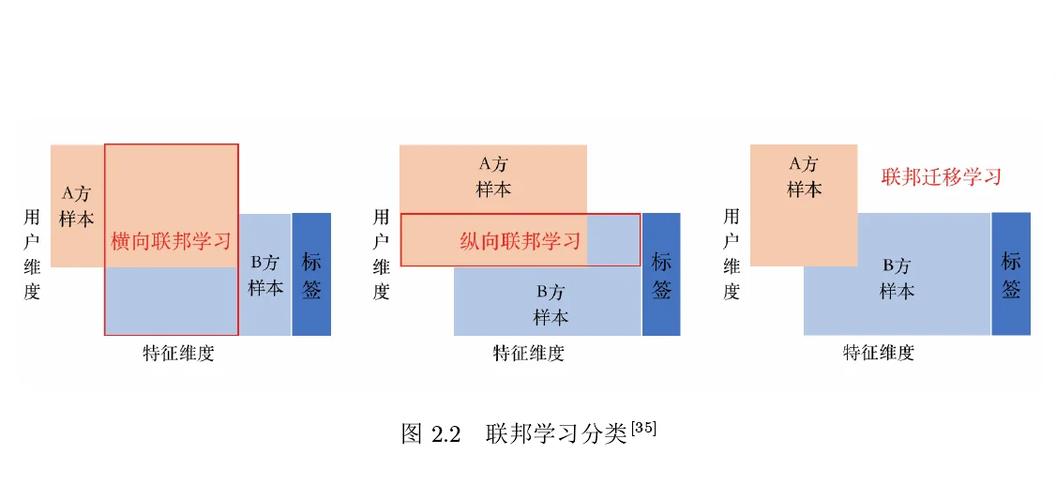 纵向联邦学习样本对齐过程示意图
说实话,第一次听懂这个逻辑的时候,我真觉得这玩意太聪明了。相当于绕开了数据共享的大坑,直接拿到了多数据源训练的好处。
别吹神了,联邦学习远没到万能的地步
 别吹神了,联邦学习远没到万能的地步
不过话说回来,我现在听见业内有些人吹联邦学习是解决数据孤岛的银弹,就浑身难受。哪有那么神?坑多着呢。
第一个误区就是,很多人觉得只要用了联邦学习,模型效果一定比单机构训练好。我经手过好几个项目,上来就要砸钱搭联邦,结果本身某家机构的数据量已经足够大,训出来的AUC已经快0.95了,搭完联邦也就提了0.01,搭集群调参数通网络的成本,翻了三倍都不止,完全得不偿失。联邦学习本质上是数据不能流动场景下的折中方案,不是升级现有模型的万能神器,要是你的数据能合法合规的聚集起来训,那绝对比联邦效果好,成本还低,犯不上折腾这个。
第二个误区就是,很多人说联邦学习绝对安全,不会泄露数据。真的吗?早就有研究证明,就算你只传梯度和参数,恶意攻击者也能通过梯度反推出原始数据的信息,要是碰上个存心偷数据的队友,你防不住。所以现在落地的联邦方案,一般都要搭配差分隐私、同态加密这些安全手段,进一步加锁,但是一加,算力成本又上去了,训练速度又慢了,又是要权衡的事。
现在真真正正落地跑起来的项目,大多集中在那几个真的拿不出数据的领域。比如金融的反欺诈、信用评分,几家机构联合训,数据不出域,合规过了,效果还提了,划算。比如医疗影像,不同医院的病例数据不能随便外传,大家一起训肿瘤识别模型,每家都能用到更多数据的信息,对病人也好。
我上个月那个城商行项目,跑出来的结果,准确率比单个机构自己训的,提了快8个点,监管那边也一次就过了,皆大欢喜。但是你知道我们调了多久吗?前后快一个月,每家机构的机房网络不一样,参数同步经常卡,加密策略也要一家一家谈,真不是买个盒子回来插上就能用的。
说白了,现在联邦学习技术还在往前走,还有一堆问题没解决,通信效率低,训练成本高,安全还有漏洞,这些都是摆着的问题。但是咱们得承认,它给那些被数据卡死的行业,开了一扇新窗。原来因为合规不能做的事,现在能做了,原来攥在自己手里没用的数据,现在能发挥价值了,不用把数据掏出去,就能吃到联合建模的红利,这就够了。对吧?