计算机视觉技术:从实验室走到烟火里的隐形革命
前阵子去楼下生鲜超市买菜,称重的时候不用自己贴条码,放上去机器直接出价格打标签。我盯着那台小机器愣了三秒——这不就是前几年还只出现在顶会论文里的计算机视觉技术么?
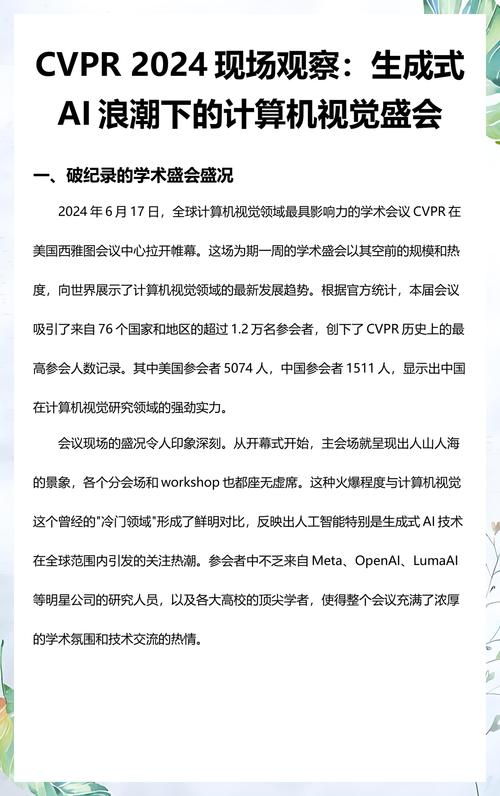 2024年CVPR计算机视觉顶会现场展板
说实话,我前几年跟着导师做项目的时候,改模型改到掉头发,就为了小目标检测涨一两个点的mAP,满脑子都是中会、评奖,压根没想过这东西能用来给青菜称重。
现在呢?路边的占道经营检测靠它,小区的非机动车辆乱停识别靠它,果农拿个手机拍一下苹果树就能数出有多少个待摘的苹果,连路边的共享单车位,都能用它实时统计空位。
为什么落地这么快?说穿了,就是基础模型的性能已经够了。自从ResNet把分类错误率打到个位数之后,计算机视觉的基础能力就跨了大坎,剩下的就是针对不同场景调优,门槛降了不是一点半点。刚好这几年国内各个行业都在缺人工,这种重复的识别、检测工作,机器干的比人好还便宜,自然就铺开来了。
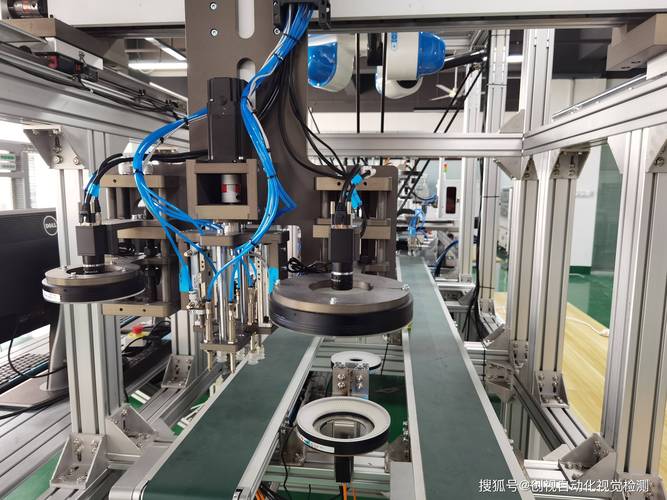 工业流水线计算机视觉锂电池缺陷检测场景
我上个月跟一个做新能源工厂整线改造的朋友吃饭,他说现在他们给客户做的检测线,全靠计算机视觉撑着。以前动力电池电芯的表面缺陷,全靠老工人拿放大镜一个个看,一天干八个小时,眼睛红的像兔子,漏检率还能到3%,出问题就是百万级的赔偿。现在用计算机视觉,一秒扫三个电芯,微米级的划痕、凹点都能揪出来,漏检率不到0.1%,还能二十四小时连轴转不用休息。
更牛的是现在的动态视觉分析,能抓运动中的物体特征。比如高速流水线上面的零件,不用减速停下来拍,跑着就能检测,一条线的产能直接提了三成。
有意思吧?原来大家觉得AI抢工作,这种脏活累活,抢了也就抢了,对吧?谁愿意天天盯着指甲盖大的地方找划痕啊。好的技术从来不是把人架在火上烤,是把人从坑里拉出来,去干更有创造性的事。
 火热背后藏着的坑,没多少人愿意公开说
吹了这么多,不代表现在计算机视觉技术就完美无缺了。坑多着呢。
第一个大坑就是数据。你要训一个能用的模型,就得有对应场景的标注数据。一万张标注好的工业零件图,少说也要三五万,要是复杂场景,十万都打不住。很多小企业想上,一算标注钱就退了。更坑的是,你在A工厂训好的模型,换到B工厂,光线不一样,零件批次不一样,背景不一样,准确率直接掉十几个点,还要重新标数据重新训,折腾不起。
第二个坑就是边缘端推理的平衡。很多场景不能把数据传到云端算,要在本地设备上跑,就得把大模型压缩成小模型。压缩狠了,精度掉的厉害,不够用;压缩轻了,普通的嵌入式芯片跑不动,卡顿不说,成本还涨上去了。怎么平衡,现在还是科研圈都在啃的硬骨头。
去年我认识一个做智慧农业创业的哥们,拿了几百万天使轮做田间作物病虫害检测,跑了五个省的农田采数据,春天的叶子和秋天的叶子不一样,晴天逆光和阴天顺光不一样,不同品种的小麦病虫害斑点还不一样,改了快一年模型,才勉强把准确率做到90%以上,钱烧了大半,才刚摸到商业化的边。
不过话说回来,哪个成熟的技术不是这么踩坑踩出来的?十几年前ImageNet竞赛的时候,谁能想到今天我们能拿着几十块钱的芯片,就跑一个能用的果蔬检测模型?现在科研圈也在解决这些问题,小样本学习、域自适应这些方向,每年都有新突破,去年CVPR就有一个工作,只用一百张标注数据就能把检测准确率做到85%以上,已经有创业公司拿去试商用了。
下次你去超市称重,不妨多盯一秒那台小小的收银机。那些我们曾经在实验室熬无数夜调出来的参数,现在正安安静静帮我们省时间、省力气,藏在烟火气里改变生活。这不就是技术最棒的样子么。
顶会里抢破头的方向,怎么就扎进了民生场景?
早在2010年前后,国内做计算机视觉的团队,几乎都盯着ImageNet 图像分类竞赛死磕。那时候大家比的就是谁能把图片里的猫、狗、汽车分对类别,谁能把准确率涨一个百分点,就能发顶会,就能拿项目,风光的不行。 那时候谁能想到,短短十几年,这个原本只蹲在实验室的方向,能铺满大大小小的民生场景。2024年CVPR计算机视觉顶会现场展板
说实话,我前几年跟着导师做项目的时候,改模型改到掉头发,就为了小目标检测涨一两个点的mAP,满脑子都是中会、评奖,压根没想过这东西能用来给青菜称重。
现在呢?路边的占道经营检测靠它,小区的非机动车辆乱停识别靠它,果农拿个手机拍一下苹果树就能数出有多少个待摘的苹果,连路边的共享单车位,都能用它实时统计空位。
为什么落地这么快?说穿了,就是基础模型的性能已经够了。自从ResNet把分类错误率打到个位数之后,计算机视觉的基础能力就跨了大坎,剩下的就是针对不同场景调优,门槛降了不是一点半点。刚好这几年国内各个行业都在缺人工,这种重复的识别、检测工作,机器干的比人好还便宜,自然就铺开来了。
现在的计算机视觉技术,早就不是“认个东西”那么简单了
很多人对计算机视觉的印象还停留在“认猫认狗”,那可真的太过时了。 现在的计算机视觉,早就和多模态大模型捏到一块去了,不光能“看见”,还能“看懂”。以前的OCR就是把图片上的字抠出来,错一个字就是错了。现在呢?给它一张贴皱了的手写发票,它能结合上下文猜你涂改的数字是什么,还能自动把金额、税号、抬头分类整理好,直接导出成报表。 在工业领域,这种进步更吓人。工业流水线计算机视觉锂电池缺陷检测场景
我上个月跟一个做新能源工厂整线改造的朋友吃饭,他说现在他们给客户做的检测线,全靠计算机视觉撑着。以前动力电池电芯的表面缺陷,全靠老工人拿放大镜一个个看,一天干八个小时,眼睛红的像兔子,漏检率还能到3%,出问题就是百万级的赔偿。现在用计算机视觉,一秒扫三个电芯,微米级的划痕、凹点都能揪出来,漏检率不到0.1%,还能二十四小时连轴转不用休息。
更牛的是现在的动态视觉分析,能抓运动中的物体特征。比如高速流水线上面的零件,不用减速停下来拍,跑着就能检测,一条线的产能直接提了三成。
有意思吧?原来大家觉得AI抢工作,这种脏活累活,抢了也就抢了,对吧?谁愿意天天盯着指甲盖大的地方找划痕啊。好的技术从来不是把人架在火上烤,是把人从坑里拉出来,去干更有创造性的事。
火热背后藏着的坑,没多少人愿意公开说
火热背后藏着的坑,没多少人愿意公开说
吹了这么多,不代表现在计算机视觉技术就完美无缺了。坑多着呢。
第一个大坑就是数据。你要训一个能用的模型,就得有对应场景的标注数据。一万张标注好的工业零件图,少说也要三五万,要是复杂场景,十万都打不住。很多小企业想上,一算标注钱就退了。更坑的是,你在A工厂训好的模型,换到B工厂,光线不一样,零件批次不一样,背景不一样,准确率直接掉十几个点,还要重新标数据重新训,折腾不起。
第二个坑就是边缘端推理的平衡。很多场景不能把数据传到云端算,要在本地设备上跑,就得把大模型压缩成小模型。压缩狠了,精度掉的厉害,不够用;压缩轻了,普通的嵌入式芯片跑不动,卡顿不说,成本还涨上去了。怎么平衡,现在还是科研圈都在啃的硬骨头。
去年我认识一个做智慧农业创业的哥们,拿了几百万天使轮做田间作物病虫害检测,跑了五个省的农田采数据,春天的叶子和秋天的叶子不一样,晴天逆光和阴天顺光不一样,不同品种的小麦病虫害斑点还不一样,改了快一年模型,才勉强把准确率做到90%以上,钱烧了大半,才刚摸到商业化的边。
不过话说回来,哪个成熟的技术不是这么踩坑踩出来的?十几年前ImageNet竞赛的时候,谁能想到今天我们能拿着几十块钱的芯片,就跑一个能用的果蔬检测模型?现在科研圈也在解决这些问题,小样本学习、域自适应这些方向,每年都有新突破,去年CVPR就有一个工作,只用一百张标注数据就能把检测准确率做到85%以上,已经有创业公司拿去试商用了。
下次你去超市称重,不妨多盯一秒那台小小的收银机。那些我们曾经在实验室熬无数夜调出来的参数,现在正安安静静帮我们省时间、省力气,藏在烟火气里改变生活。这不就是技术最棒的样子么。