合作满意度调研:你以为打分就完了?真相比你想的复杂
先承认吧,大部分满意度调研都是走过场
我上周刚填完一个合作满意度问卷。18道题,全是李克特量表——从左边的“非常不同意”到右边的“非常同意”。我闭着眼全选了“一般”。
不是我不认真。是那问卷问的什么“沟通效率”“资源支持”“目标一致性”……一堆抽象词,我早忘了当时合作的具体细节,只能凭感觉瞎勾。说实话,这种调研结果,鬼才信。
但你可能不知道,真正的合作满意度研究根本不是这样玩的。过去十年,心理学和管理学的顶刊上,关于合作满意度的实证研究多得吓人。有篇元分析(就是汇总了几百项研究的那种)发现:感知公平性和心理安全感,比单纯的“结果好坏”更能预测合作满意度。换句话说,就算项目黄了,只要过程公平、说话不挨怼,分照样高。反之,赢了但感觉被当成工具人,满意度照样崩。
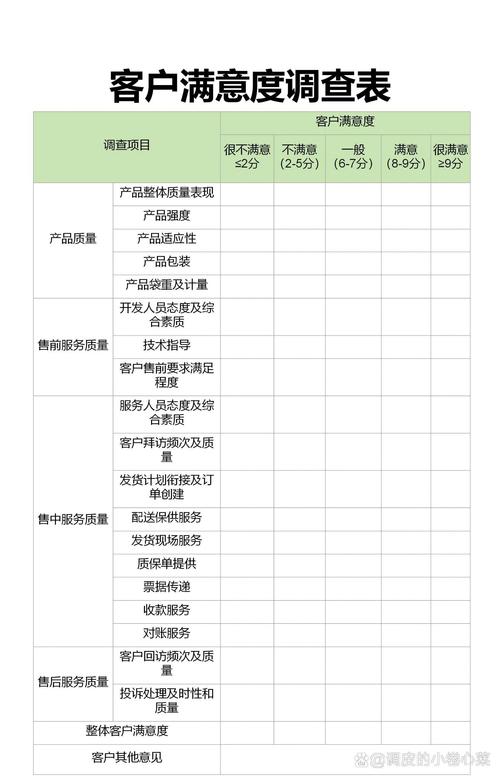 合作满意度调研问卷设计草图
数据背后的真实情绪:那些量表测不出来的东西
我做过一个访谈,参与的是某科技公司的跨部门项目组。问卷数据显示大家都挺满意,平均4.2分(满分5)。但深入聊过才发现,底下怨气冲天——只是没人敢在匿名问卷里写实话。
为什么?因为问卷问的是“你对合作结果的满意程度”,但大家心里想的是“我对那个天天甩锅的同事很不满”。这俩根本不是一回事。有研究把合作满意度拆成认知满意度(我觉得合作有价值)和情感满意度(我在合作中开不开心),它们的影响因素差别大到离谱。认知满意度靠的是任务清晰度和角色分工,情感满意度靠的是尊重和情绪价值。你让一个程序员去填“合作的战略性意义”,他脑子里只想“这东西能不能跑通”。对吧?
所以有个很有趣的发现:在满意度调研里加一道开放式问题,比加十道打分题都管用。因为人们吐槽的时候才说真话。但现实是,大多数公司怕麻烦,直接剪掉文本框。
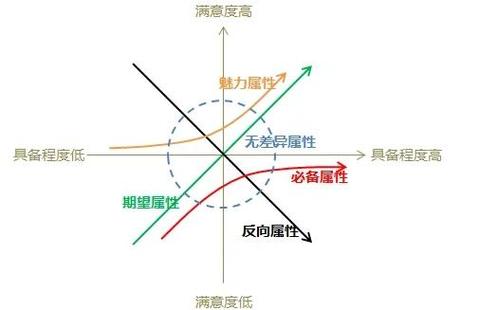 跨部门合作满意度影响因子模型图
动态合作场景下的满意度:不是一次测量,而是持续追踪
 动态合作场景下的满意度:不是一次测量,而是持续追踪
还有个坑。传统调研是“事后诸葛亮”,但合作满意度是波动的。今天被客户虐了一顿,你明天填问卷肯定低分;下周项目顺利,又飘到高分。有本《组织行为学》期刊上的纵向研究,连续测了6个月,发现合作满意度的方差有40%来自时间波动,而不是合作本身。这意味着什么?你拿着一份时点的问卷当圣旨,其实跟拿彩票预测股市一样不靠谱。
真正的做法是体验采样法——在合作过程中,随机发送几次简短的问卷,比如“现在你对合作的感受如何?”就一个问题。这比事后复盘精准多了。但很多企业觉得太麻烦,宁愿年底搞个大满贯。
另外,别只盯着“平均分”。合作满意度在团队里的分布比平均值重要得多。举个例子,A团队所有成员都打3分,B团队一半打5分、一半打1分。平均值都是3,但B团队实际上已经火药味十足。分析一下不一致性(或者叫“满意度差距”),往往能提前预警冲突。
把满意度调研当成一场对话,而不是一次审判
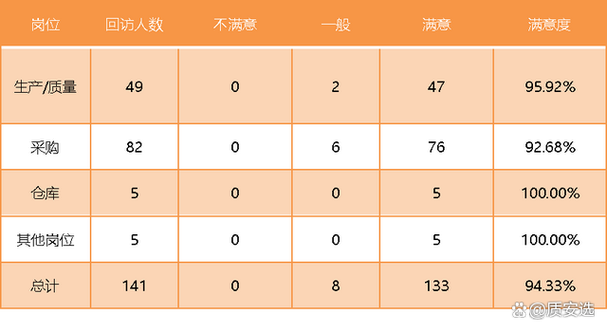 把满意度调研当成一场对话,而不是一次审判
我见过最聪明的做法,是某创业公司的HR。她从不发标准问卷,而是每个月跟每个项目组开半小时“吐槽会”——没有任何层级,老板也坐在旁边听,但明文规定不许解释、不许反驳。她就记录哪些词被提到的频次最高。后来发现,“屁股”“撕逼”“不背锅”这些词出现一次,满意度就降一截。她再用这些词去反推合作流程的问题,居然比那些高信效度量表还管用。
说实话,合作满意度调研的本质不是收集数据,而是建立信任。你让员工觉得“填了这个东西有回馈”,他们才愿意说真话。否则就是一场互相欺骗的游戏。
写这篇文章时,我刚跟一个合作方吵架。所以可能情绪有点上头。但研究是清醒的:合作满意度不只是一个评价指标,更是一种团队免疫系统的体温计。你量体温不是为了记下度数,而是为了决定要不要吃药。
所以,下次设计合作满意度调研时,先忘掉那套“维度+五点量表”的模板吧。好好想想:你究竟是想听真话,还是想收集一份好看的汇报?