故障诊断技术的暗面:被标签遮蔽的退化过程
故障不是事件,而是一段被切碎的过程
一台轴承从出现微小剥落到彻底失效,中间可能要跑几百万转。真正有价值的信息,大多藏在这段历程的前三分之一。问题是——没有哪家工厂愿意等到设备坏了才去标注数据。于是工业现场能拿到的标签,几乎只有“正常”与“已坏”两类,而中间那段漫长的、最具诊断价值的退化区间,是空的。
这就形成了一个尴尬局面。算法在测试集上精度九成九,到了产线上,第一次遇到早期故障,它给出的置信度是0.51。像猜的。或者说,它就是在猜。
标签体系本身也有问题。运维人员记录的“故障”,往往对应一次维修动作,而非一个物理状态。换了轴承,标签写“轴承故障”。可拆下来一看,是润滑失效引起的。标签错了。这类噪声在真实数据集里的占比,说实话,没多少人愿意公开。
 旋转机械轴承早期故障振动信号时域波形图
数据驱动的甜蜜期,以及它随后寄来的账单
深度学习进入故障诊断领域时,带来过一个漂亮的承诺:端到端,不需要人工构造特征。这在实验室里确实奏效。凯斯西储大学那套轴承数据集被反复训练了十几年,各类网络在它上面的表现已经逼近饱和。
然后是跨域问题。
同一台设备,转速从1500转降到1200转,频谱分布整体平移,训练好的网络性能断崖式下跌。工况迁移、负载迁移、跨设备迁移——每一次迁移都在提醒:模型学到的是特定工况下的统计规律,不是故障本身的物理本质。
迁移学习和域适应因此成了热门方向。对抗式域适应、最大均值差异、元学习,方法层出不穷。但有一个前提常被忽略:域适应的有效性依赖源域与目标域共享某种特征空间。当目标域的故障模式在源域中从未出现过,负迁移就会发生。诊断结果比不诊断还糟。
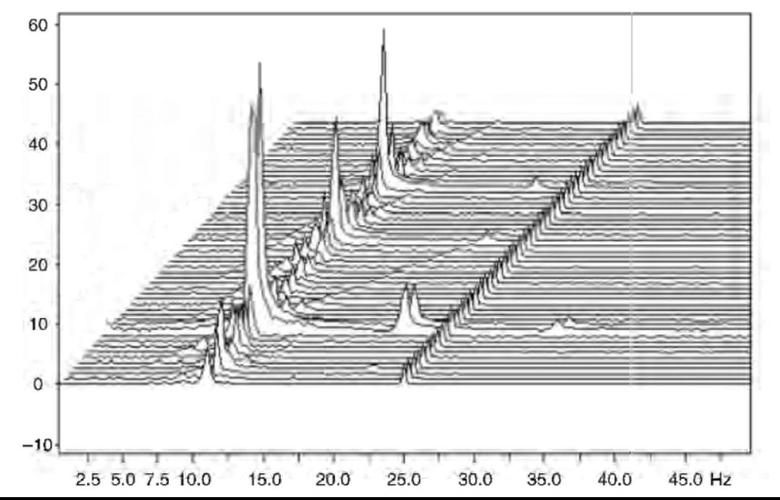 工业设备振动频谱瀑布图工况变化对比
机理模型为什么又回来了
 机理模型为什么又回来了
残差法是个老思路。建立设备的物理或半物理模型,用实测信号减去模型输出,残差中显著偏离零的部分即为异常。它的好处是可解释——你能指着某一段残差说,这里对应的是齿轮啮合频率的边带能量上升。
可机理模型需要参数。阻尼、刚度、间隙,这些量在实际设备上难以准确获取,而且会随磨损缓慢变化。模型失配会直接污染残差,凭空制造出一堆虚假报警。
物理信息神经网络一类的融合方法因此出现。把动力学方程作为约束项加进损失函数,让网络在拟合数据的同时满足物理规律。想法很好。实践中的难处在于:约束项的权重怎么定?物理约束太强,网络学不动数据里的真实偏差;约束太弱,又退化成纯数据驱动。
此处没有普适答案。取决于你对模型的信任程度,以及对数据质量的判断。
准确率是个会骗人的指标
工业场景里,漏报和误报的代价并不对称。漏掉一次早期故障,可能导致整条产线停机,损失以小时计的产量。而一次误报,代价只是派工程师去现场确认,白跑一趟。
但不少研究仍然把总体准确率当作核心指标。在故障样本占比百分之五的数据集上,一个把所有样本都判为正常的模型,准确率是百分之九十五。它没有任何诊断能力,指标却很好看。
代价敏感学习、F1分数、G-mean,这些才是该被盯住的量。只是在现有的评价习惯里,它们不如一个干净的数字便于比较。这算不算一种路径依赖,见仁见智。
边缘部署:算力、传感器与那些没写进论文的约束
实验室里的模型跑在服务器上,现场用的是嵌入式控制器。参数量、推理延迟、内存占用,全是硬约束。一个在GPU上跑得飞快的Transformer,挪到工控机里,可能连一个采样周期都撑不过去。
还有传感器这件事。诊断能力的天花板,往往在数据采集阶段就已经确定了。采样率不够,高频故障特征直接混叠;传感器安装位置偏离激励源,信噪比掉几个量级,后面再怎么做特征增强都是徒劳。
这些约束很少出现在方法论文里。但它们决定了技术能不能真正落地,而不是停在仿真曲线上。
那么,路在哪
三条线在同时推进,实际是纠缠着的。
一条是承认标签的局限,转向无监督与半监督的异常检测,把重点从“识别哪类故障”移到“检测偏离”。这在标签稀缺的工业现场更现实。
一条是把不确定性量化做进来。模型不该只输出一个类别,还该输出它有多不确定。高不确定的样本推给人工复核,低不确定的自动处置。这才是人机协作的实际形态,而非学术口号。
还有一条,评价体系得改。用可迁移性、代价敏感指标、跨工况稳健性来衡量,而不是单一数据集上的峰值精度。改起来很难,因为牵扯到太多既有的比较基准。
故障诊断技术走到今天,算法层面的创新空间正在收窄。真正的瓶颈在数据、在物理、在工程约束,也在我们如何定义“诊断成功”这件事上。