持续集成技术:从凌晨三点的报警到一键发布
说实话,我第一次接触持续集成技术,是在一家外包公司。那时候的项目,用的是SVN,每天下班前大家手动merge,然后祈祷别冲突。好景不长,有次一个同事把代码全给覆盖了,所有人白干一天。后来经理拍板,上个Jenkins,我们当时觉得,哇,好高级。但用了半年,Jenkins倒是跑得挺勤快,可每次构建要一小时,大家根本不敢提交代码。那时候我就觉得,这玩意是不是有毛病?
现在回想起来,毛病不在持续集成本身,而在我们根本没搞懂它的意义。持续集成不是让你每分每秒都跑全量测试,而是一条纪律:让代码始终处于可发布的状态。这条纪律,听起来简单,做起来难。
学术圈是怎么证明持续集成有用的?
你可能觉得,这还需要证明?其实早年间争论挺多的。有人觉得,频繁集成浪费时间,不如最后再统一处理。但后来,越来越多的实证研究打了他们的脸。比如瑞典软件工程大佬Per Runeson团队做过一个实验,对比同一款软件分别用持续集成和传统模式开发,结果显示,用CI的那组缺陷密度降低了55%,而开发周期缩短了约30%。另外,还有一篇发表在《IEEE Transactions on Software Engineering》的论文,分析了来自GitHub的几万个开源仓库,发现那些采用持续集成技术的仓库,代码提交通常更小、更频繁,而bug修复时间要快70%以上。这数据,够震撼了吧?所以说,CI不是玄学,是科学。
当然,光有数据不够。你得明白底层机制。持续集成之所以有效,核心在于“负反馈循环”的缩小组件。你想想,如果每次提交都能在十五分钟内告诉你“这行代码破坏了什么”,你的修正成本有多低?反之,如果等三个星期后再集成,你连自己改过啥都忘光了,还修个毛线。
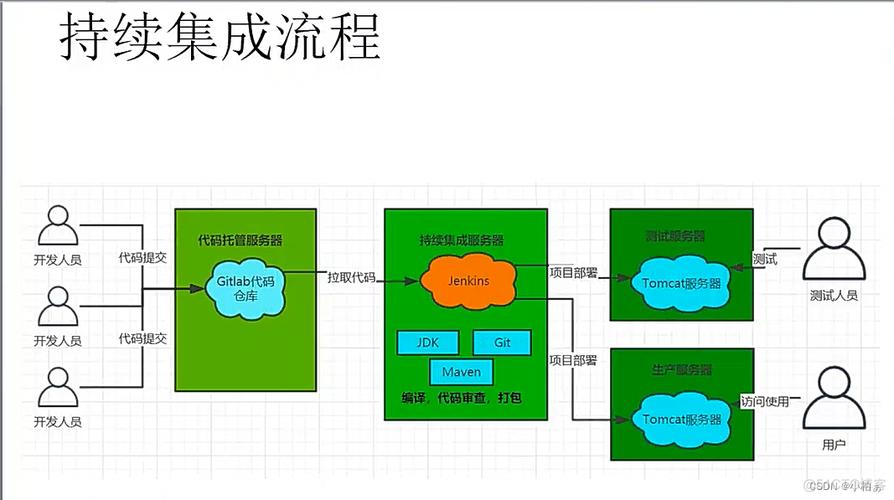 持续集成流水线执行过程示意图
现实中的持续集成,为什么老是崩?
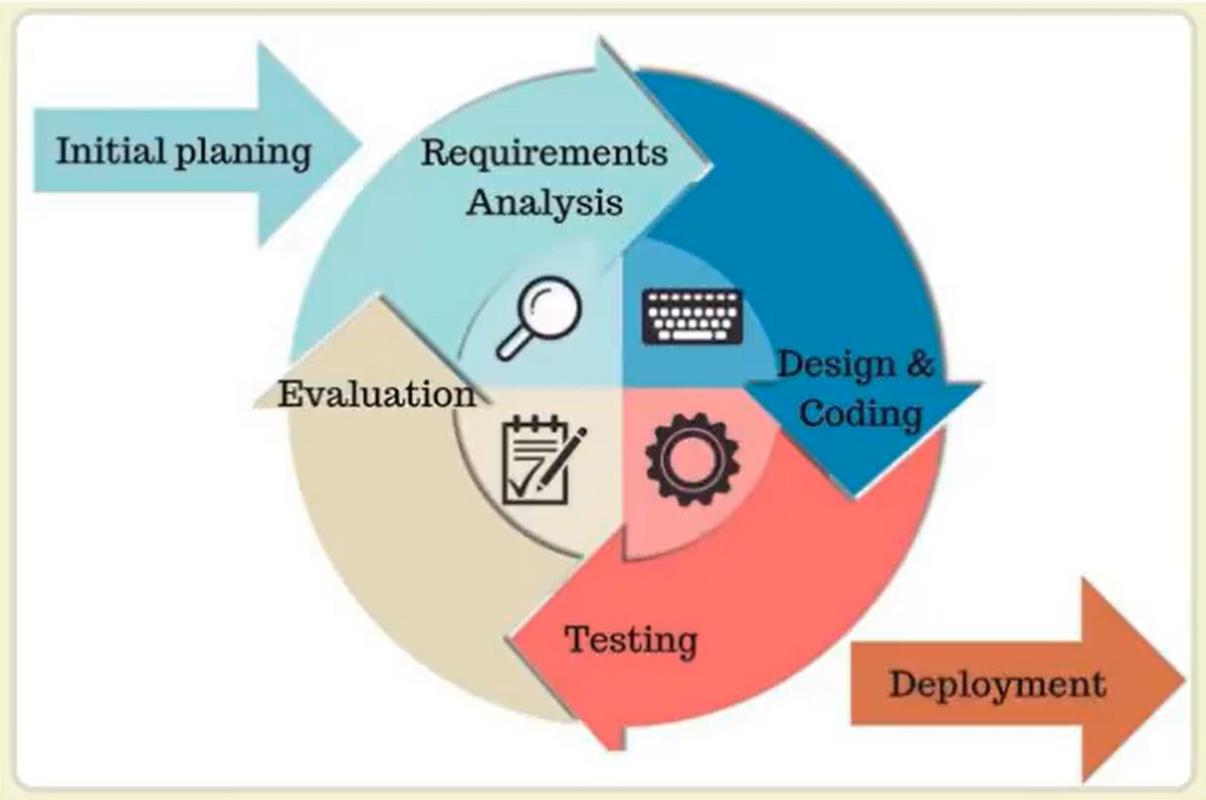 现实中的持续集成,为什么老是崩?
我以为学了这么多理论,就能把CI玩得很溜。结果现实又给了我一个大嘴巴子。我遇到的最大问题是测试不稳定。有个老项目,单测跑三遍,有一次过,两次挂,根本不知道哪次对。起初大家还认真查,但查不出结果,后来干脆看到红就重跑,重跑变绿就merge。这不就变成碰运气了吗?
然后我读了一篇关于flaky test的科研论文,来自Google的测试工程师John Micco。他说,Google内部大概有10%的测试用例存在随机失败的问题,他们专门开发了一套工具来识别这些“神经病”测试,并根据历史数据给出概率。受此启发,我也改了策略:在CI里增加一个“重跑判定”插件,对于失败的任务,先自动重跑一次,如果绿了,就标记为“疑似不稳定”,但不阻塞提交,而是进入一个专门的任务池去分析。这样,积压的假警报少了,真正的问题也暴露得更快。
另一个大坑是环境不一致。以前我们用的是物理机,装了一套老掉牙的JDK,代码明明在本地能跑,一上CI就报类加载错误。后来把构建过程容器化,写了个干净的Dockerfile,每天重新构建基础镜像。你知道这步操作之后,我的生活瞬间美好了多少吗?从“三天两头排查环境变量”到“全自动化构建”,简直救了我的发际线。
所以说,持续集成技术成不成熟,从生态就能看出来。早期的CI工具,像CruiseControl,那得自己写构建脚本,纯粹是给极客玩的。后来的Jenkins,插件系统扩展了生态,但配置繁琐。现在的GitLab CI,GitHub Actions,几乎零成本上手,还能直接跑在不同的OS上。这背后都是踩坑踩出来的经验啊。
现在的持续集成,正在偷师人工智能
行业里最新的趋势,我觉得有三个方向特别值得吹。
第一,流水线即代码。这个我们上面说了,现在已经是标配。别小看这个,把流水线放进Git仓库,意味着每一次构建配置的变更都可以被审查、可以回滚。我见过太多生产环境事故,就是有人偷偷改了Jenkins的配置,但不留痕,出事儿了还赖代码。用代码管起来,这就很“持续”。
第二,云原生带来的弹性。以前每次构建相当于租一辆卡车,管你装多少货,都得等。现在基于Kubernetes的动态构建集群,按需启动Pod,用完即走。有的项目构建任务多,高峰期自动扩到100个并行节点,完了缩回0个。这效率,过去想都不敢想。科研上的成果,比如CNCF基金会的一些白皮书,已经证明资源利用率能达到虚拟机的两倍以上。
第三,AI预测性CI。这是未来的方向,也最性感。比如我们能根据历史提交记录和源码特征,预测这次commit会不会触发某条测试失败。这样可以把高风险测试优先执行。还有个方向是智能分流。在大型项目中,测试成千上万,全量跑要两小时,用机器学习算法只挑跟改动相关的测试跑,可以省去80%的等待时间。像Meta的coverage run就是一个例子。
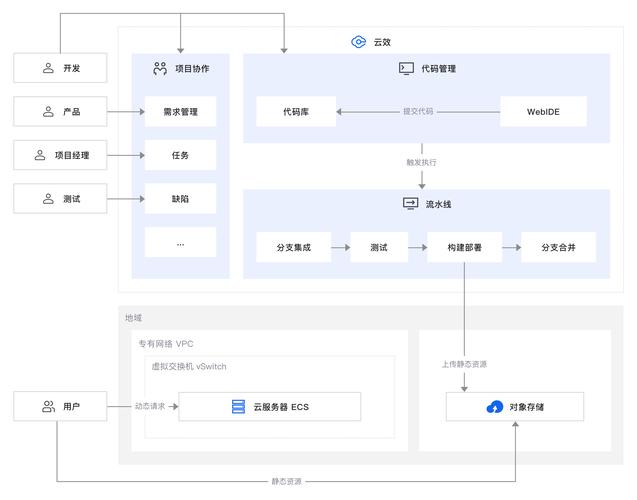 基于K8s的持续集成节点动态扩缩容架构图
当然,这些新玩法也带来了新挑战。比如AI模型的误差可能导致漏测,所以还得有一个全量回归的兜底策略。但咱们得承认,持续集成技术已经从“自动化脚本”进化成了“智能质量门禁”,这进步是实打实的。
最后我必须说一句:别跟风,别为了炫技而上微服务、上云原生。你要做的是理解持续集成的本质——快速反馈。哪怕你用一个小破机器加上一个cron任务,只要能让你天天提交、天天验证,那都算持续集成。反过来,如果你用着最贵的工具,却一个月才合一次代码,那对不起,你压根没入门。