DevOps实践:别被硅谷那套忽悠了,咱们聊点真东西
先说个闹心事儿
去年我接手一个传统企业的运维团队,那叫一个乱。开发写完代码直接扔给运维,运维手工部署,出问题了互相甩锅。老板一怒之下喊我们搞DevOps,说业界都在玩这个。我当时心里就一句话:搞可以,但别指望一夜暴富。后来查了一堆论文,包括DORA(DevOps研究与评估)的年度报告,挺有意思——人家那数据都是从几千个团队里扒出来的,说持续交付能力强的团队,部署次数比普通团队多46倍。但注意,人家也说了,这些团队大多在科技公司,你让传统制造业直接抄作业?不现实。
今天咱们就聊聊,我踩过的坑,还有那些真刀真枪实践下来有用的东西。
自动化部署:别用脚趾头想,要用工具
很多团队一提DevOps,第一反应就是上K8s,上Jenkins。说实话,工具只是表象。我见过一个团队,把Jenkins pipeline写得跟论文似的,结果每次发版还是得手动点一下“构建”。图啥?就为截图给领导看?
科研上有篇挺经典的论文《Accelerate: The Science of Lean Software and DevOps》里提了个核心指标:变更前置时间。意思是代码提交到生产环境的耗时。我见过最夸张的,前置时间能拖俩星期——因为中间要人工审批、手动跑测试、再发个邮件通知。后来我们干了三件事:第一,把部署脚本固化成CI/CD流水线;第二,给测试套件加了自动触发;第三,所有环境配置写进代码库,用版本管理。就这么简单,前置时间从两周压到一天。那论文里提到的“部署失败率”我们也盯了——从原来的30%降到8%。
不过话说回来,你手上连自动化测试都没有,就别碰流水线。先补基础。就像你还没学会走路呢,直接穿个跑鞋去跑马拉松,不摔死才怪。
监控和可观测性:别等用户骂了才反应过来
有一阵子我们的服务频繁超时,客户投诉不断。运维半夜爬起来查日志,翻了一个多小时,发现是数据库连接池满了。那感觉,真想抽自己两巴掌——明明都有日志,怎么就不能早点发现?后来我们把监控做细了,不只是看CPU、内存,关键业务指标也上线了:下单成功率、支付链路延迟、队列积压量。配合链路追踪系统(参考了Google Dapper那篇论文的思路),每次请求走哪个服务、耗时多少,全链路可视化。这回再出问题,五分钟内定位。
你可能觉得这不就是上工具吗?没那么简单。我给你看一个真实案例:某家银行把监控面板做得花里胡哨,一百多个图表,但运维根本不知道看哪个。后来我们只留三个:业务成功率、平均响应时间、错误率趋势。反而效果立竿见影。心理学上叫“选择过载”,放在运维这事儿上也通。你弄那么多指标,等于没指标。
这种坑,我估计同行都踩过。别嫌我啰嗦,可观测性不是为了炫技,是为了能在用户发现问题之前你先骂自己一顿。
文化冲突:这才是DevOps最难啃的骨头
你看那些成功的DevOps实践分享,大部分在讲工具链。我去翻了一篇2023年发表在《IEEE Transactions on Software Engineering》上的研究,调查了上百个团队,结论让人心凉:工具不背锅,组织文化才是决定成败的关键。开发想“我写的代码没问题,你运维咋不扩容?”运维想“你天天改需求,我怎么维护?”这种对立不破,上再牛的金丝雀发布也白搭。
我们当时做了个“逆向操作”:让开发和运维换工位,每周轮流盯监控。刚开始各种尴尬,开发看不懂运维的脚本,运维被开发质问“你这写的什么**”。但一个月后,神奇的事情发生了——开发会注意到不正常的报错,主动找运维讨论;运维也开始理解改个接口有多痛。那个研究里也提到,跨职能协作的质量比数量重要。你搞一堆乱七八糟的例会,不如让大家坐一块儿解决一个真实故障。
不过话说回来,也有搞砸的。隔壁团队强行推行“开发自运维”,结果开发天天忙得焦头烂额,代码质量直线下滑。为啥?因为DevOps不等于让开发兼职运维,而是让两个角色变成一个团队。这个平衡,你得拿捏死。
云原生和平台工程:新的装逼关键词?
近几年“平台工程”火了,一堆公司招人建内部开发者平台。从一个实践者的角度看,这其实是DevOps的2.0——因为大家发现,让每个开发自己搞定K8s和Helm,有点强人所难。我看过一份Gartner的报告,说到了2026年,80%的软件工程组织会建立平台团队,目的是降低认知负担。这话说得挺学术,说白了就是让开发别折腾基础设施,把精力放在业务代码上。
但别急着上平台。我见过一个公司,啥都不懂呢就搞了个团队去封装CICD,结果封出来的平台比原版还难用,没人敢用。所以我的建议是:先让开发团队自己用工具,等痛到不行了,再抽象成平台。顺序反了,就是浪费钱。
还有云原生那套,容器化是趋势没错,但别忘了,技术复杂度不会消失,只会转移。昨天你管虚拟机,今天你管Pod,明天还得管Service Mesh。这活儿不轻松。不过你要是能把这套玩转了,那薪酬确实香。
最后的实话(不用总结,就聊到这)
DevOps实践这话题,能写本书。但我今天聊的这些,都是血泪换来的。你问有没有万能模板?真没有。那些卖咨询的,张嘴就是“最佳实践”,闭嘴就是“持续创新”,你让他自己来跑个传统项目试试?
反正我的原则是:先从最痛的点下手。部署老出错?就先治部署。监控像瞎子?就先治监控。文化和流程,慢慢来,急不得。你要是想聊具体场景,欢迎在评论区留言——但别问我什么“怎么制定DevOps战略”这种虚头巴脑的,我怕自己没忍住开喷。
顺便说一句,最近人工智能也卷进DevOps了,什么AI辅助排障、自动修复Bug。科研论文倒是有不少,但实践起来……等真能帮我省心的时候,我再来说道说道。
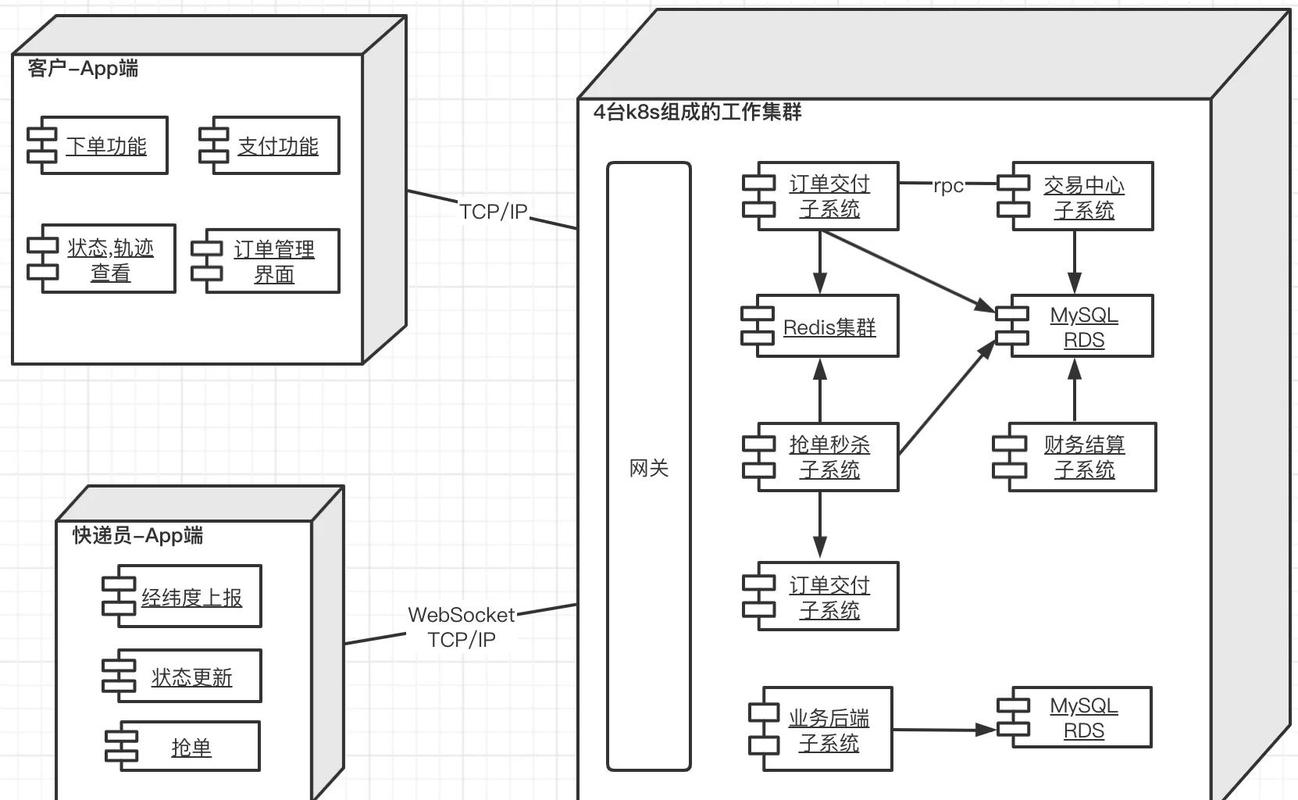 软件部署流水线示意图
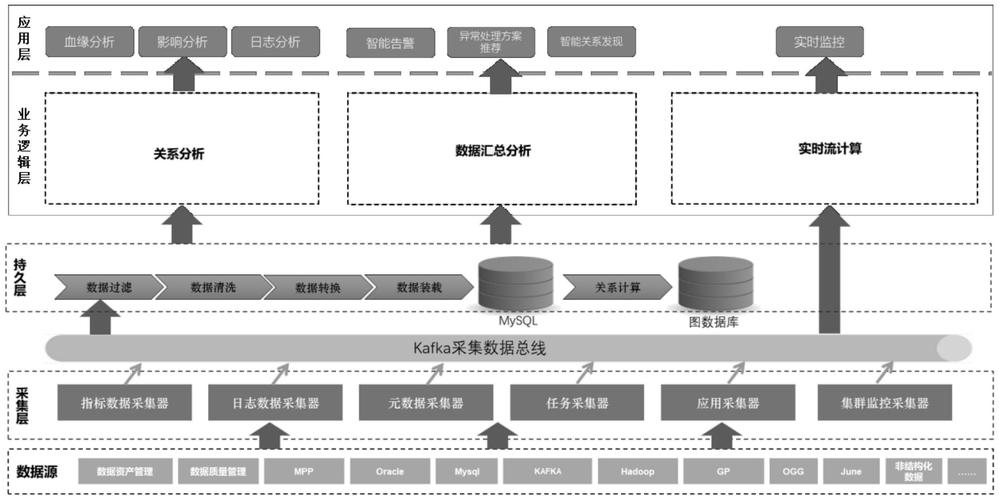 全链路监控系统架构图