技术风险识别:别等系统崩了才想起来补课
凌晨两点,手机疯狂震动。一看监控,核心服务挂了。排查半天,发现是依赖的一个第三方API突然改了返回格式,而我们没做兼容。这种事儿,做过几年开发的人估计都遇到过。问题出在哪?风险识别没做到位。
说实话,技术风险这东西,就像鞋里进的小石子,平时不在意,等脚磨出水泡了才后悔。我们总在事故复盘会上信誓旦旦地说“下次一定提前发现”,可到了下次,还是老样子。这不是能力问题,是心理机制在作祟。
为啥我们总是对风险视而不见?
 为啥我们总是对风险视而不见?
心理学有个词叫“正常化偏见”——人在面临潜在危险时,倾向于低估它,觉得“以前没出事儿,这次也不会”。放到技术圈,就是:这个服务跑了三年了,稳如老狗,改它干嘛?
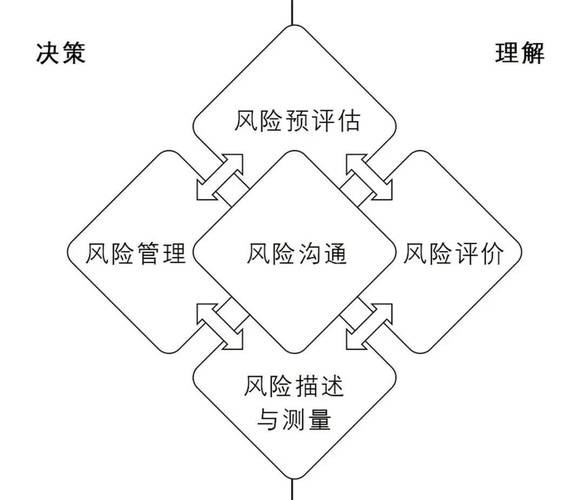 技术风险忽视的心理模型图示
而且,很多公司里,业务压力大的时候,风险识别就成了摆设。产品经理催上线催得跟催命一样,你还慢悠悠做风险评估?不被怼死算好的。于是,技术债越积越多,直到有一天,一次小小的配置变更,就能引发雪崩。这可不是我瞎编的,看过《黑天鹅》的都知道,极端事件往往源于一堆不起眼的隐患叠加——只不过咱们这儿,每天都在上演。
还有个坑:过度依赖监控。总觉得告警系统会替我们兜底,可告警是滞后的,等你看到磁盘使用率90%的告警时,可能几分钟后就100%了。风险识别必须是前瞻的,不能靠后视镜开车。
从学术论文里偷几招实用的
别以为搞科研的都是纸上谈兵。我前阵子翻了一篇论文,讲的是如何在微服务架构里做风险传播分析,思路挺清奇:把服务间的依赖关系画成图,然后模拟某个节点故障,看影响范围。这其实跟混沌工程的思路很像,只不过它是静态分析,不用真搞破坏。
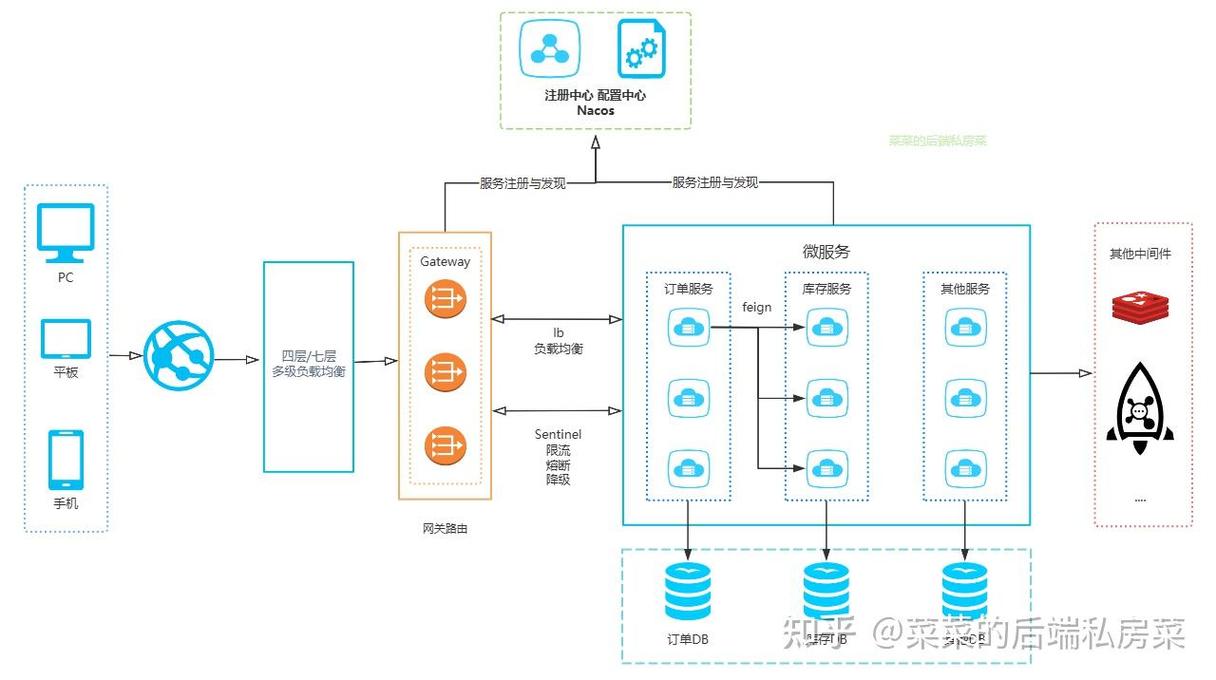 微服务依赖图风险传播分析示例
还有个更古老的工具,FMEA(失效模式与影响分析),五十年代就用在航空航天了。现在有些团队把它简化了用在软件上:列出每个组件的功能,然后问几个问题——它要是出错了会怎样?可能导致多严重的后果?发生的概率有多高?虽然听着笨,但真能发现一些隐蔽的单点故障。比如,你可能会突然意识到:redis集群的哨兵模式投票要过半,如果三个节点的集群分布在同一个机架呢?机架断电就是全灭。这种风险,光看监控绝对看不出来。
再新潮点的,有团队用因果推断来分析事故。去年一篇顶会文章提到,用do-calculus去模拟“如果某个变量变化,系统故障概率会怎么变”。说实话,我没全看懂,但核心思想很启发人:别只盯着相关性,要去找因果链。比如,CPU飙升和响应延迟同时出现,不代表CPU是原因,可能都是垃圾回收搞的鬼。识别风险,得顺藤摸瓜。
工具箱:几个反直觉的实操方法
 工具箱:几个反直觉的实操方法
第一招:别怕破坏东西。混沌工程就是让你主动在生产环境里注入故障——对,你没听错,生产环境。Netflix有只猴子叫Chaos Monkey,随机干掉服务实例,逼着工程师设计容错。风险识别最怕的就是虚假的安全感,你以为是高可用的,一测,全挂了。这种打脸方式,比半夜电话温柔得多。
 混沌工程故障注入实验控制台
第二招:做一次彻底的“假设清除”。把所有你认为理所当然的前提列出来,然后一个个质疑。比如:“假设网络总是可靠的”——真的吗?交换机固件有bug怎么办?“假设数据库主从切换是毫秒级的”——如果binlog同步延迟呢?这个方法来自哲学里的笛卡尔怀疑论,用在这儿效果拔群。
第三招:拉产品经理下水。你让他想象一下,用户数据丢了一天的后果,他可能就给你排期做容灾了。风险识别不是技术人的独角戏,业务影响评估才是最有力的说服工具。我见过最成功的一次,是安全团队模拟了一次勒索软件攻击,把演示环境加密了,CEO看完脸都绿了,立刻批了安全预算。看见没?感性往往比理性管用。
最后,别迷信工具。什么风险评估矩阵、风险雷达图,都是辅助。真正的风险识别能力,源自于你对系统行为的深刻理解,和那种“总觉得哪里不对劲”的敏感。你越熟悉一个系统,就越能察觉到微妙的异常——就像老司机能听出发动机的异响。所以,没事多看看架构图,多在线上溜溜,培养第六感。
行了,就聊这么多。风险这事儿,说完也完不了。毕竟,只要还在写代码,坑就永远在前面等着。共勉吧。