系统效能评估:学术圈的屠龙刀,工程界的鸡毛掸子
上周,实验室砸了几十万的新系统终于跑通了基准测试。结果嘛……惨不忍睹。吞吐量远低于设计值,延迟像过山车,资源利用率长期徘徊在30%左右——但偶尔飙到90%然后又暴跌。老板脸都绿了,我憋着笑。说实话,那一刻我突然明白了,系统效能评估这玩意儿,在论文里是屠龙刀,到了工程现场,往往变成一把鸡毛掸子,拂一拂灰尘,然后继续假装岁月静好。
别误会,我不是说评估不重要。恰恰相反,正因为太重要,才被过度包装。你看那些学术论文,动辄几百个公式、复杂的马尔可夫模型、排队网络,把一个系统的效能预测做得像算命先生一样玄乎。可到了实际部署,一个内存泄漏、一条慢SQL,甚至一个配置错误,就能让所有模型瞬间破功。对吧?效能评估的核心困境,不是数学不够美,而是真实世界太脏了。
 复杂系统效能模型与实际运行对比图
从“应该跑多快”到“为什么跑不快”
2019年,Google发表了一篇论文,讲的是他们内部一个叫Scape的工具,专门用来分析微服务架构下系统性能瓶颈。我当时惊为天人——这不就是把控制论和统计推断塞进了分布式系统里吗?但后来跟一个前狗厂的朋友聊,他轻描淡写地说:“哦,那个啊,核心就是采样+相关性分析,再加一套可视化。其实我们每个季度还要靠人工巡检,因为模型会漂移。” 瞧,学术殿堂里的圣杯,到了工程实践中,就是个辅助诊断仪。连Google都这样,普通公司更不用说了。
不过话说回来,这几年可观测性的兴起,倒确实给效能评估装上了一对顺风耳。OpenTelemetry、eBPF这些技术,让系统内部的运行细节前所未有地透明。以前我们要靠打桩、插桩,现在动动手指,在内核层就能抓到各种延迟数据。效能评估的方法论,正从一个‘静态画像’向‘动态监测’剧烈转型。
但问题来了:数据多了,就真的更懂系统了吗?未必。我曾参与过一个项目,监控面板上几十个指标,每次出故障,团队盯着大盘看了十分钟,最后还是靠老工程师的经验——他摸了一下服务器外壳,说:“风扇转疯了,准是哪个线程死循环了。” 你看,经验这东西,往往能绕过所有精心设计的评估体系,一剑封喉。
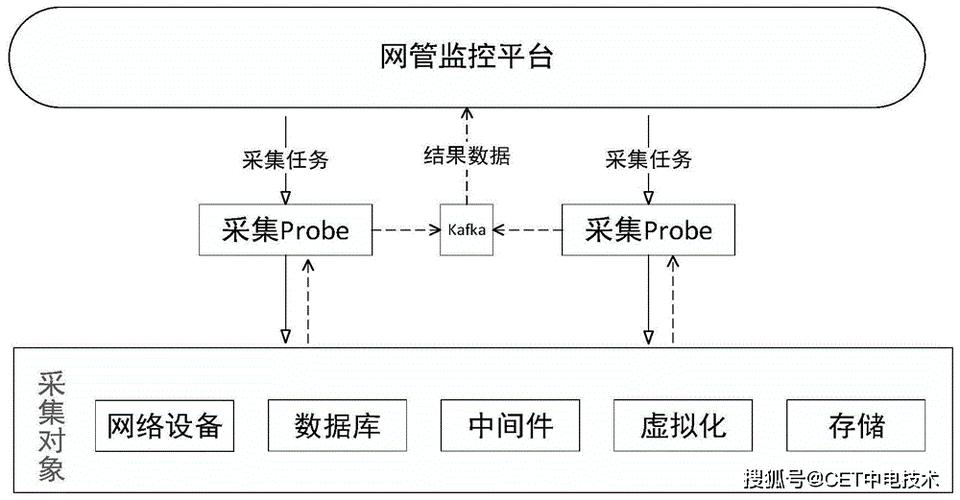 现代可观测性技术栈数据采集管道示意图
当效能评估遇上AI:救赎还是另一场忽悠?
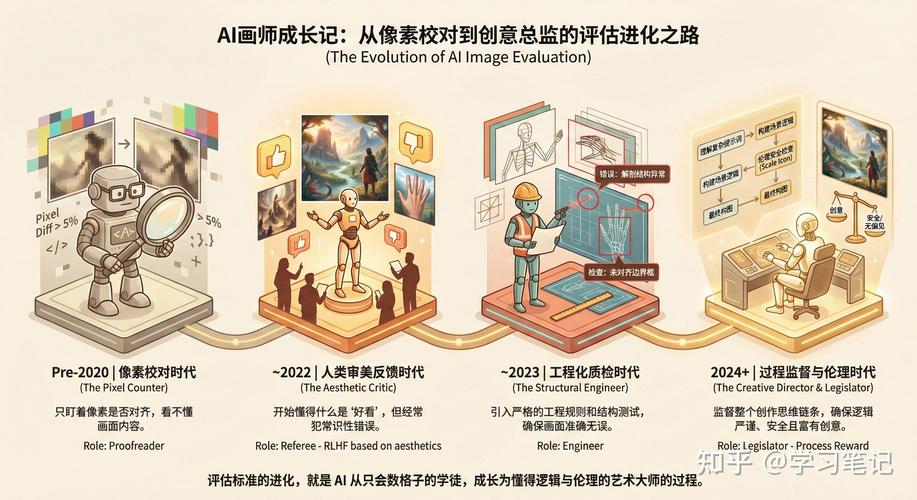 当效能评估遇上AI:救赎还是另一场忽悠?
最近,AI for IT Operations (AIOps) 火得一塌糊涂。用机器学习来预测系统瓶颈、自动调优参数,听起来完美。我记得去年参加一个会议,某大厂展示了一个基于强化学习的数据库资源调度系统,PPT上曲线漂亮得让人心动。可一问落地情况,演讲者支支吾吾,最后承认:“在生产环境跑的时候,我们得严格限制它的动作空间,否则它常常把系统调到崩溃边缘去探索最优解。” 我差点笑出声——这哪儿是智能调度,分明是数字版的‘作死边缘疯狂试探’。
当然,也有务实派。比如Netflix的Chaos Monkey团队,他们不用花哨模型,就是主动注入故障,看看系统怎么死,然后改进。这种混沌工程的思路,本质上是一种破坏性效能评估:不要预测极限,直接打到你崩为止,然后把临界点记录下来。简单粗暴,但极其有效。我特别推崇这种理念,因为真实世界的流量不是高斯分布,而是长尾、爆发、不可预测的。用办公室里的模型去预测野外的风暴?开什么玩笑。
不过,AI在效能评估中并非一无是处。至少,在异常检测和时间序列预测上,深度学习可以快速识别模式,尤其是当系统规模大到人力无法应付时。但千万别把AI当成银弹。我见过一个团队,花了半年训练一个性能诊断模型,准确率高达95%,结果新版本一上线,几个微服务接口改了签名,模型直接废了。没人维护。说到底,系统效能评估是一个持续运营的活,不是一次性的智力冲浪。
抛弃完美主义,拥抱“够用”评估
这些年,我踩过的坑告诉我:好的效能评估,不是那个能算出小数点后三位的模型,而是能用最简单的逻辑解释清楚瓶颈在哪,并且给出可操作的优化方向。比如,“因为缓存淘汰策略太激进,导致数据库查询增加了200%,影响了接口延迟”——这就是合格的评估。至于精确到200%还是189%,对解决问题帮助不大。
另一个极端是,有些团队把效能评估搞成了形式主义。每季度跑一遍标准benchmark,生成几十页报告,扔进共享文件夹,然后该扩容扩容,该慢还是慢。我问过一个负责人,为什么不做深入分析?他说:“报告给老板看的,他只看绿色和红色,绿色就没事。” 可悲。效能评估如果脱离了容量规划、架构演进、排障优化这三驾马车,就只是一堆废纸。
最近,我开始痴迷于‘效能预算’(Performance Budget)的概念。比如说,我们明确规定首页加载延迟不能超过500ms,其中网络层150ms,渲染层200ms,后端计算层150ms。一有突破预算,马上报警。这比任何事后评估都来得直接。它把效能目标融入了日常开发流程,逼着每个模块的人对自己的资源消耗有概念。DevOps的深层逻辑不就是这个吗?
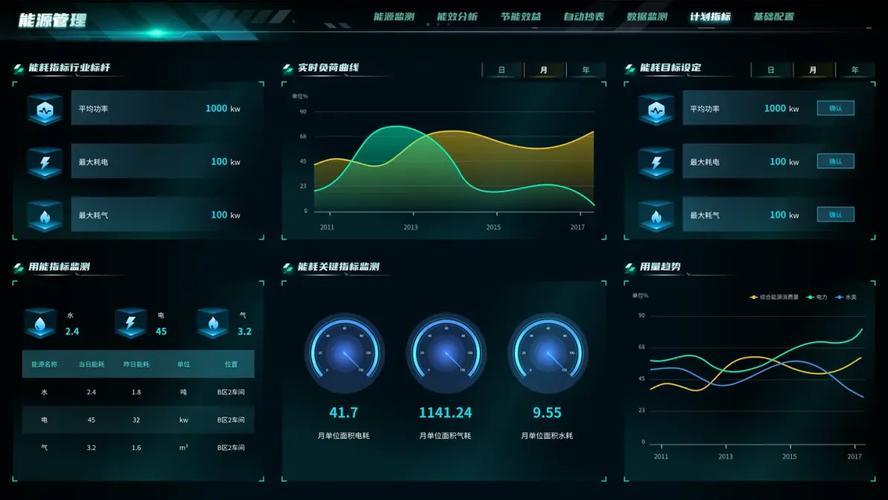 系统效能预算分配与实时监控仪表盘示例
还有一点不得不提:硬件异构化对效能评估的冲击。以前我们在X86服务器上算得精准,现在有了ARM、GPU、FPGA甚至存算一体芯片,系统效能不再是同质化平台上的优化,变成了跨异构单元的协同调度问题。评估指标也得跟着变,比如能耗比、每瓦特性能,在大规模数据中心比单纯的吞吐量更重要。绿色计算不再是口号,而是实实在在的账单。
最后,讲个笑话吧。有一次,我帮一个创业公司做系统诊断,他们的推荐服务延迟一直降不下来。我用各种先进分析工具,跟踪了三天,发现了几个微小瓶颈,改完只提升了5%。然后,创始人突然问:“你们是不是用的第三方短信验证码服务?” 我说是啊。他拍着桌子说:“那个服务供应商为了省钱,把服务器放在新疆,而我们大部分用户在广东!延迟能不超时吗?” 我们哈哈大笑。评估来评估去,最大的坑居然在系统边界外。所以,搞效能评估,不要只盯着自己的代码堆,打开视野,看看整个价值链,有时候答案在别处。
好了,今天就瞎聊到这儿。系统效能评估,说到底,是一场无止境的侦探游戏。数字是死的,故事是活的。希望你的评估能讲出一个好故事,而不是堆砌一堆没人看懂的统计量。